儀表板不會自我懷疑
數字在抵達前已預設立場
儀表板、A/B 測試工具與自動化分析如今驅動著商業領域的決策。它們輸出看似定論的數字:「變體 B 將轉換率提升 12%」、「此群組流失率高達 3 倍」、「活動回報率達 4.2 倍」。介面以自信的樣式呈現每一個數字,沒有動搖、沒有星號註記、沒有懷疑。
問題在於,這些數字中有很大一部分來自波動劇烈的樣本、被刻意挑選的比較,或是被悄悄重複執行直到某項指標越過閾值的測試。工具不會標記這些問題。它只是報告數字,然後繼續前進。
作為決策者,你的優勢並非親自執行統計分析。而是能充分理解樣本、區間、比較與效應量,從而判斷哪些自信的數字值得信任、哪些應暫緩判斷,以及哪些應退回以獲取更多數據。
本課程涵蓋五種直覺反應:(1) 樣本大小與噪音,(2) 信賴區間與不確定性,(3) p值操縱(p-hacking)與多重比較,(4) 效應量與統計顯著性,以及 (5) 基礎率與來源。最後,我們將提供一份檢查清單,讓您在兩分鐘內即可對任何研究或報告進行快速評估。
那個逆轉的 A/B 測試結果
讓我們從一個具體的情境開始:
您的成長團隊在週一啟動了一項 A/B 測試。到了週二,工具顯示變體 B 領先 18%,並帶有綠色的「顯著」標籤,這是基於每組 240 名訪客得出的結果。團隊希望立即向所有用戶推送變體 B。您建議他們讓測試繼續運行。到了下個週一,當每組訪客數達到 9,000 時,變體 B 實際上落後於 A 1%,且「顯著」標籤已消失。
小樣本波動劇烈
用白話解釋統計功效
來自樣本的每個測量值都是真實值加上雜訊。樣本越小,相對於訊號而言,雜訊就越大。這不是可以用程式碼規避的缺陷,而是對較少觀測值進行平均運算的數學本質。
一個實用的經驗法則:估計值的雜訊會隨著樣本量的平方根縮小,而非隨樣本量本身縮小。要將不確定性減半,你需要四倍的數據。要將其降至十分之一,你需要一百倍的數據。這就是為什麼早期結果如此不穩定,以及為什麼測試的最後階段感覺如此緩慢。
統計功效(Statistical power)是指當真實效應確實存在時,檢定偵測到特定大小真實效應的機率。功效不足(underpowered)的檢定是指觀察值過少,無法可靠地偵測到其目標效應的檢定。功效不足的檢定會朝兩個方向失敗:它們會漏掉真實效應;而且,當它們確實報告「顯著」結果時,該結果更可能是雜訊過高的過高估計。第二種失敗,即被誇大的贏家,才是真正讓決策者吃虧的地方。
實務上的紀律:在執行檢定之前,先決定值得採取行動的最小效應大小,然後計算偵測該效應所需的樣本量。執行至該樣本量。不要在第一天的數據上過度解讀。
診斷功效不足的報告
一份自動化報告擺在你的桌上。它比較了本季度 14 個客戶分群的流失率。標題寫著:「第 7 分群流失率飆升至 22%,遠高於 9% 的平均值,請緊急調查。」你查看詳細資料。本季度第 7 分群包含 46 位客戶。上季度第 7 分群有 41 位客戶,當時其流失率為 7%。
沒有區間的點估計
點周圍的橫槓
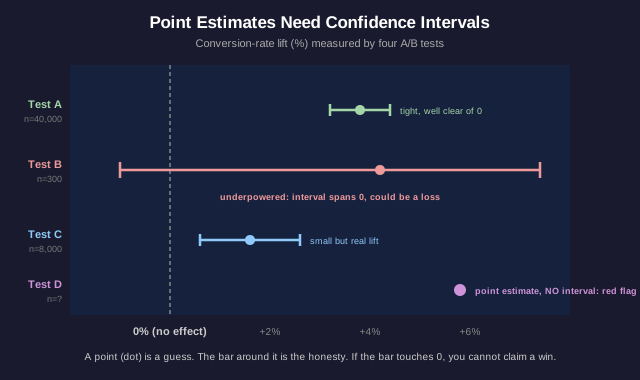
點估計(point estimate)是單一的最佳猜測數值:提升幅度為 12%,平均值為 4.2,流失率為 9%。信賴區間(confidence interval)則是考慮到資料中的雜訊後,真實值可能佔據的範圍:提升幅度為 12%,正負 9%,因此合理範圍可能在 3% 到 21% 之間。
點估計是猜測,區間則是誠實。一份報告如果只顯示點估計,沒有區間、沒有誤差條、沒有範圍,就是在隱藏你最需要的那個數字。請將沒有區間的點估計視為警訊,而非精確度。
重疊的區間(overlapping intervals)帶有一個特定的啟示。如果 A 變體的區間是 3% 到 21%,而 B 變體的區間是 1% 到 19%,這些範圍大幅重疊。你無法宣稱 A 優於 B,因為資料顯示兩者可能相等,或者 B 可能領先。兩個點估計可能不同,但它们的區間顯示這種差異只是雜訊。
一個更微妙的陷阱:一個寬廣但完全位於零之上的區間,告訴你效果是真實的,但其大小不確定。一個寬廣且跨越零的區間,則告訴你你甚至不知道符號(正負)。這兩者需要不同的決策。區間的寬度是資訊,而非裝飾。
解讀兩個重疊的區間
一位供應商向你推銷他們的推薦引擎。他們的投影片上寫著:「我們的引擎將平均訂單金額提升至 $58.40(95% 信心區間 $54.10 至 $62.70)。對照組平均為 $55.90(95% 信心區間 $51.30 至 $60.50)。」他們以粗體結論道:「每單明確提升 $2.50,立即上線。」
測試足夠多的東西,總有一個會贏
你看得越多,發現的就越多
P值為 0.05 意味著,如果實際上沒有效應,你純粹憑運氣看到如此強勁結果的機率約為 20 分之 1。當你只進行一次誠實的測試時,這是可接受的風險。但當你進行二十次測試時,這就變成了幾乎必然出現的假陽性。
多重比較:如果儀表板將你的用戶按 20 個維度(設備、地區、小時、推薦來源、訂閱層級等)進行切片,並標記任何看起來「顯著」的切片,那麼即使沒有真實效應發生,你也應該預期每次運行都會出現約一個假勝利。該工具並沒有對任何單一測試說謊。它只是靜默地運行許多測試,並報告最幸運的那一個。
P值操縱(P-hacking)是一系列製造顯著性的操作:嘗試多種結果指標並報告那個跨過閾值的指標;不斷添加或刪除控制變量直到 P 值下降;在看起來顯著的那一刻停止數據收集;或者將數據分割成子群體,直到某個子群體「有反應」為止。這些都不需要誠實度問題;有動機的分析师在不自覺的情況下就會進行 P 值操縱。
防禦措施是結構性的。預註冊:在查看數據之前,寫下唯一的一個假設和唯一的一個指標。保留集(Holdout):保留一份新的數據切片,並確認該發現能在沒有機會被揀選的數據上存活下來。校正:當必須運行許多測試時,提高標準(Bonferroni 校正、錯誤發現率控制),使閾值考慮到查看的次數。一個在保留集上存活的發現,遠比一個僅僅在第一次嘗試中跨過 0.05 的發現更有價值。
找到贏家的分析師
一位分析師報告說:「好消息,我們發現我們的電子郵件行銷活動顯著增加了購買量(p = 0.03),對象是那些使用 Android 裝置、年齡在 25-34 歲之間、且在晚上 8 點後開啟電子郵件的用戶。」他們正在申請預算,以將此活動擴大到所有用戶。你得知,該分析師在得出這個組合之前,檢視了跨裝置、年齡層和時間段的購買率切片。
顯著仍可能意味著微不足道
兩個不同的問題
統計顯著性回答一個問題:這個效應能否與零區分開?而效應量回答的是另一個問題:效應有多大?一個結果可能同時具有極高的統計顯著性和極低的實際價值。
關鍵連結在於樣本量。當樣本量足夠大時,幾乎任何差異都會變得統計顯著,因為置信區間會縮小,直到即使微小的效應也不再與零重疊。一項針對 500 萬用戶的測試可能報告說,新的按鈕顏色「顯著」提升了 0.02% 的點擊率,且 p < 0.0001。這個 p 值無懈可擊,但效應毫無價值。
因此,沒有效應量的顯著性只是半句話。決策者真正關心的是:效應有多大?它是否大到足以影響這個決策?以及它的價值是否超過其成本?一個需要六個月工程專案才能實現的 0.02% 提升,無論其統計顯著性多高,在實務上都是失敗的。
換個角度想。一個巨大且充滿希望的效應量,如果伴隨著寬廣的區間(來自功效不足的測試),可能是一個值得進行更大規模、具備適當功效之後續研究的真實機會。顯著性和效應量是兩個獨立的調節器。請同時閱讀兩者。
顯著但值得上線嗎?
你的平台團隊在 400 萬個會話上進行了一項嚴謹且具高統計功效(well-powered)的實驗。結果顯示:「新的結帳版面配置顯著提升了完成的購買次數,p < 0.001。提升幅度為 +0.05 個百分點(完成率從 4.10% 提升至 4.15%)。」要上線此版面配置需要兩個月的重構時間,並會使程式碼庫變得複雜。團隊主張:「既然具有統計顯著性,我們就有義務將其上線。」
這些數據由誰收集?它具有普遍性嗎?
數據總有來源
在關注任何 p 值或區間之前,先問數據來自哪裡。兩個問題能解決大部分問題:基礎比率(base rate)是多少?這個樣本是否能推廣到你關心的總體?
基礎比率是你所讀到的任何比率的錨點。一個檢測欺詐「準確率 95%」的測試聽起來很棒,但當你知道欺詐僅發生在 0.1% 的交易中時,情況就變了:在該基礎比率下,絕大多數被標記的交易都是虛警,因為龐大誠實多數的 5% 遠大於微小欺詐少數的 95%。忽略基礎比率,正是技術上準確的模型產生無用且嘈雜警報流的原因。在評估任何檢測率或回應率數字之前,務必先問底層比率是多少。
來源(Provenance) 是數字的託管鏈。誰收集的?如何收集的?針對誰?由你最活躍的用戶回答的調查,無法描述你流失的用戶。在節日促銷期間測量的轉換率,無法描述普通的星期二。由銷售該產品的供應商運行的基準測試,並非中立測量。採樣方法、時機、測量工具,以及誰從結果中受益,都影響數字是否能推廣到你的決策。
推廣性(Generalization) 是最後一道關卡。在一個情境(一個國家、一個季節、一個客戶層級、一個設備)中收集的數據,可能無法遷移到另一個情境。數字可能測量得完美無缺,但對你的問題來說仍是錯誤的數字。「在此為真」與「對我的決策為真」是不同的聲稱。
供應商網站上的案例研究
某軟體供應商的著陸頁聲稱「使用我們工具的企業生產力提升了 35%」。該數字來自於供應商自行選取並撰寫的 3 家客戶公司的案例研究,由這些公司自我報告節省的時間,測量時間為供應商團隊提供親手白手套式導入後的首個月份。
兩分鐘懷疑者檢查清單
對任何研究、儀表板或自動化報告執行此檢查
現在你已經掌握了五種直覺。以下是你可以針對任何出現在你桌上的自信數字,在兩分鐘內快速檢查的清單。
1. 樣本與功效。 這個數字背後的樣本有多大?它是否足夠大以偵測出值得採取行動的效果,還是小到僅憑少數觀察值就會大幅波動?小群體上的比率大多是噪音。
2. 區間而非點估計。 是否有信心區間或誤差範圍,還是只有一個裸露的點估計值?沒有區間的點估計值是危險信號。如果比較兩件事,它們的區間是否重疊?重疊意味著差異尚未確立。
3. 比較次數。 這是單一預先宣告的測試,還是從許多測試中撿到的最幸運的一塊?詢問檢查了多少指標、分群或變體。從搜尋中挑出的「顯著」贏家,在相信它之前,需要新的保留集或預註冊的確認。
4. 效果量與顯著性。 暫時把 p 值放在一邊:效果有多大?相對於其成本,它是否大到足以影響這個決策?在巨大樣本上「顯著」的效果可能仍然微不足道。
5. 基礎率與來源。 這個數字所依據的基礎基礎率是多少?誰收集了數據、如何收集、針對誰,以及誰從結果中受益?測量時的背景是否與你正在做的決策相符?
帶走的一句話:在檢視其樣本、區間、比較與來源之前,數字只是一項主張,而非事實。 這些工具會不斷輸出自信的數字。你的工作是讀懂它們所遺漏的四件事。
建議深入閱讀的資料包括:Darrell Huff 的《統計謊言》(How to Lie with Statistics)、Charles Wheelan 的《裸體統計》(Naked Statistics)、Regina Nuzzo 關於 p-hacking 的著作,以及關於閱讀研究方法的 CONSORT 指引。