لوحة البيانات لا تشكّ في نفسها
الأرقام تصل مُقرَّرة مسبقًا
تقود لوحات البيانات وأدوات اختبار A/B والتحليلات الآلية الآن القرارات عبر قطاع التجارة. إنها تُصدر أرقامًا تبدو نهائية: "المتغير B يرفع معدل التحويل بنسبة 12%"، "هذه الفئة تتسرب أسرع بثلاثة أضعاف"، "حملات التسويق عادت بأربعة أضعاف ونصف". تُصيّر الواجهة كل رقم منها بخطٍّ واثق، دون أي تردد، دون علامة نجمة، ودون أي شك.
المشكلة أن حصة كبيرة من تلك الأرقام تأتي من عينات تتأرجح بعنف، أو من مقارنات تم انتقاؤها بعناية، أو من اختبارات تم تكرارها بهدوء حتى تجاوز شيءٌ ما حدًّا معينًا. لا يُشير الأداة إلى أيٍّ من ذلك. إنها تُبلغ عن الرقم ثم تنتقل إلى ما يليه.
مزاياك كصانع قرار ليست في إجراء الإحصاءات بنفسك. بل هي في قراءة العينة، والفاصل الزمني، والمقارنات، وحجم الأثر جيدًا بما يكفي لمعرفة أي الأرقام الواثقة يجب أن تثق بها، وأيها يجب أن تحتفظ به، وأيها يجب أن تُعيده لطلب المزيد من البيانات.
تغطي هذه الدرس خمسة انعكاسات: (1) حجم العينة والضوضاء، (2) فترات الثقة وعدم اليقين، (3) التلاعب بالإحصاءات (p-hacking) والمقارنات المتعددة، (4) حجم الأثر مقابل الدلالة الإحصائية، و(5) المعدلات الأساسية والمصدر. نختم بقائمة تحقق يمكنك تنفيذها ضد أي دراسة أو تقرير في أقل من دقيقتين.
نتيجة اختبار A/B التي انعكست
سيناريو ملموس للبدء به:
أطلق فريق النمو اختبار A/B يوم الاثنين. بحلول يوم الثلاثاء، أظهرت الأداة أن النسخة B تفوز بفارق 18% مع شارة خضراء "دالة إحصائيًا"، بناءً على 240 زائرًا لكل ذراع. يريد الفريق نشر B للجميع فورًا. طلبت منهم ترك الاختبار يعمل. بحلول الاثنين التالي، عند 9,000 زائر لكل ذراع، أصبحت النسخة B متأخرة فعليًا بنسبة 1% عن A، واختفت الشارة.
العينات الصغيرة تتأرجح بعنف
القوة الإحصائية بلغة بسيطة
كل قياس من عينة هو القيمة الحقيقية مضافًا إليها الضوضاء. كلما كانت العينة أصغر، كانت الضوضاء أكبر نسبةً إلى الإشارة. هذا ليس عيبًا يمكن تجاوزه بالبرمجة. إنه حساب متوسط عدد أقل من الملاحظات.
قاعدة إبهام مفيدة: الضوضاء في التقدير تتقلص مع الجذر التربيعي لحجم العينة، وليس مع حجم العينة نفسه. لتقليل عدم اليقين إلى النصف، تحتاج إلى أربعة أضعاف البيانات. لتقليله إلى عُشره، تحتاج إلى مئة ضعف من البيانات. هذا هو السبب في أن النتائج المبكرة متقلبة للغاية، ولماذا يبدو الجزء الأخير من الاختبار بطيئًا.
القوة الإحصائية هي الاحتمال الذي يكتشف به الاختبار تأثيراً حقيقياً بحجم معيّن، إذا كان هذا التأثير موجوداً حقاً. الاختبار الضعيف القوة هو الذي يحتوي على عدد قليل جداً من الملاحظات لرصد التأثير الذي يبحث عنه بشكل موثوق. تفشل الاختبارات الضعيفة القوة في اتجاهين: فهي تفوّت التأثيرات الحقيقية، وعندما تُبلغ عن نتيجة "دالة" إحصائياً، فمن المرجح أن تكون هذه النتيجة مبالغة ضجيجية في التقدير. هذا الفشل الثاني، المتمثل في الفائز المبالغ فيه، هو ما يُحرق صانعي القرار.
الانضباط العملي: قبل إجراء الاختبار، حدد أصغر تأثير يستحق اتخاذ إجراء بشأنه، ثم احسب حجم العينة المطلوب لكشفه. نفّذ الاختبار حتى الوصول إلى هذا الحجم. لا تقرأ أوراق الشاي في اليوم الأول.
تشخيص تقرير ضعيف القوة
يصلك تقرير آلي على مكتبك. يقارن التقرير معدل التسرب بين 14 شريحة من العملاء هذا الربع. يقول العنوان الرئيسي: "قفز معدل التسرب في الشريحة 7 إلى 22%، وهو أعلى بكثير من المتوسط البالغ 9%، قم بالتحقيق بشكل عاجل". تنظر إلى التفاصيل الدقيقة. تحتوي الشريحة 7 على 46 عميلاً هذا الربع. كانت الشريحة 7 تحتوي على 41 عميلاً في الربع الماضي، عندما كان معدل التسرب فيها 7%.
تقدير نقطي بدون فترة
الشريط حول النقطة
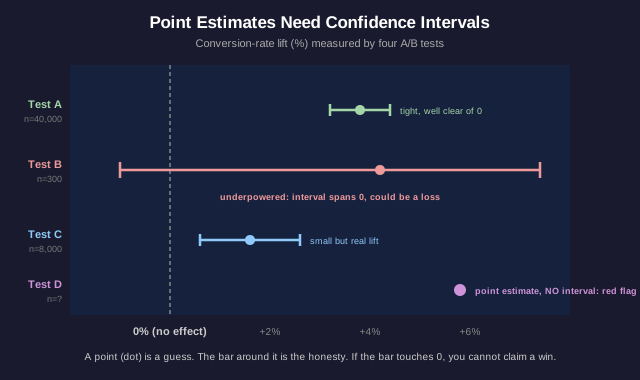
التقدير النقطي هو رقم واحد يُعد أفضل تخمين: الارتفاع 12%، والمتوسط 4.2، ومعدل الدوران 9%. أما فترة الثقة فهي النطاق الذي من المرجح أن يقع فيه القيمة الحقيقية بالنظر إلى الضوضاء في البيانات: الارتفاع 12%، زائدًا أو ناقصًا 9%، أي أنه قد يكون في أي مكان من 3% إلى 21% بشكل معقول.
التقدير النقطي هو التخمين. أما الفترة فهي الأمانة. التقرير الذي يعرض تقديرًا نقطيًا بدون فترة، أو شريط خطأ، أو نطاق، يخفي الرقم الذي تحتاجه أكثر من أي شيء آخر. تعامل مع التقدير النقطي العاري كعلامة تحذير، وليس كدقة.
الفترات المتداخلة تحمل درسًا محددًا. إذا كانت فترة النسخة أ من 3% إلى 21%، وفترة النسخة ب من 1% إلى 19%، فإن هذه النطاقات تتداخل بشكل كبير. لا يمكنك الادعاء بأن أ تتفوق على ب، لأن البيانات متسقة مع تساويهما، أو مع تقدم ب. يمكن أن يختلف تقديران نقطيان بينما تقول فترتهما إن الفرق ضوضاء.
فخّ أدقّ: فاصل زمني (أو نطاق) واسع لا يزال يقع بالكامل فوق الصفر يخبرك أن التأثير حقيقي لكن حجمه غير مؤكد. فاصل واسع يعبر الصفر يخبرك أنك لا تعرف حتى الإشارة (إيجابي أم سلبي). هذه تتطلب قرارات مختلفة. عرض الفاصل هو معلومات، وليس زخرفة.
قراءة فاصلين متداخلين
يقدم لك بائع توصية محركه. تقول شريحته: "رفع محركنا متوسط قيمة الطلب إلى 58.40 دولار (95% CI من 54.10 دولار إلى 62.70 دولار). بلغ متوسط المجموعة الضابطة 55.90 دولار (95% CI من 51.30 دولار إلى 60.50 دولار)". ويختم، بخط عريض، قائلاً: "ربح واضح قدره 2.50 دولار لكل طلب، أطلقوه."
اختبر ما يكفي من الأشياء وستجد شيئاً يفوز
كلما بحثت أكثر، وجدت أكثر
قيمة الاحتمالية (p-value) البالغة 0.05 تعني أنه إذا لم يكن هناك تأثير حقيقي، فستشاهد نتيجة بهذه القوة مرة واحدة من كل 20 مرة بسبب الصداد البحت. هذا خطر مقبول عندما تجري اختباراً صادقاً واحداً. لكنه يصبح شبه مؤكد كإيجابي زائف عندما تجري عشرين اختباراً.
المقارنات المتعددة: إذا قسّم لوحة التحكم (dashboard) مستخدميك عبر 20 بُعداً (الجهاز، المنطقة، الساعة، المُحيل، فئة الخطة، وما إلى ذلك) وسلّط الضوء على أي شريحة تبدو "مهمة إحصائياً"، فيجب أن تتوقع وجود فائز زائف واحد تقريباً في كل تشغيل حتى عندما لا يحدث شيء حقيقي. الأداة لا تكذب بشأن أي اختبار فردي. إنها تجري العديد من الاختبارات بصمت وتُبلغ عن الأوفر حظاً بينها.
التلاعب بالإحصاء (P-hacking) هو مجموعة من الحيل التي تصنع الأهمية الإحصائية: تجربة مقاييس نتائج متعددة والإبلاغ عن تلك التي تجاوزت الحد، وإضافة أو حذف المتغيرات الضابطة حتى تنخفض قيمة الاحتمالية، وإيقاف جمع البيانات في اللحظة التي تبدو فيها النتيجة مهمة، أو تقسيم البيانات إلى مجموعات فرعية حتى تستجيب إحدى المجموعات. لا يتطلب أي من هذا الكذب؛ فالمحللون الدافعون يتلاعبون بالإحصاء دون أن يدركوا ذلك.
الدفاعات هي هيكلية. التسجيل المسبق (Pre-registration): اكتب الفرضية الواحدة والمقياس الواحد قبل رؤية البيانات. عينة الاحتفاظ (Holdout): احتفظ بشريحة جديدة من البيانات وتأكد من أن الاكتشاف يصمد على بيانات لم يكن لديها فرصة للاختيار الانتقائي. التصحيح: عندما يجب إجراء العديد من الاختبارات، ارفع المعيار (تصحيح بونفروني، التحكم في معدل الاكتشاف الكاذب) بحيث يأخذ الحد في الاعتبار عدد مرات الفحص. الاكتشاف الذي يصمد في عينة الاحتفاظ يستحق قيمة أكبر بكثير من ذلك الذي تجاوز 0.05 في المحاولة الأولى فقط.
المحلل الذي وجد فائزًا
يُبلغ أحد المحللين بـ"أخبار رائعة، لقد اكتشفنا أن حملة البريد الإلكتروني لدينا زادت المشتريات بشكل كبير (p = 0.03) بين المستخدمين الذين يستخدمون أندرويد، وفي فئة العمر من 25 إلى 34 عامًا، وفتحوا البريد الإلكتروني بعد الساعة 8 مساءً". وهم يطلبون ميزانية لتوسيع نطاق الحملة لتشمل الجميع. تعلمت أن المحلل نظر في معدلات الشراء عبر شرائح الجهاز، وفئة العمر، وساعة اليوم قبل أن يستقر على هذه التركيبة.
الدلالة قد تعني شيئًا ضئيلًا
سؤالان مختلفان
الدلالة الإحصائية تجيب عن سؤال واحد: هل يمكن تمييز هذا الأثر عن الصفر؟ أما حجم الأثر فيجيب عن سؤال مختلف: ما مدى ضخامة الأثر؟ يمكن أن يكون النتيجة ذات دلالة إحصائية قوية للغاية وفي الوقت نفسه تافهة تمامًا.
العلاقة تكمن في حجم العينة. مع عينة كبيرة بما يكفي، تصبح أي فروق تقريبًا ذات دلالة إحصائية، لأن الفاصل الثقة يتقلص حتى لا يلمس الصفر بعد حتى مع وجود أثر مجهرى. يمكن لاختبار على 5 ملايين مستخدم أن يبلّغ عن أن لون زر جديد "يرفع" النقرات بشكل "دال إحصائيًا" بنسبة 0.02%، مع قيمة p < 0.0001. قيمة p لا تشوبها شائبة. لكن الأثر عديم القيمة.
لذا، الدلالة دون حجم الأثر هي نصف جملة فقط. أسئلة صانع القرار هي: ما حجم الأثر؟ وهل هو كبير بما يكفي ليكون ذا أهمية لهذا القرار؟ وهل تتجاوز قيمته تكلفته؟ زيادة بنسبة 0.02% تتطلب مشروعًا هندسيًا يستغرق ستة أشهر تفشل من الناحية العملية مهما بلغت دلالتها الإحصائية.
ولنقلب الأمر أيضًا. حجم أثر كبير وموعد مع فاصل ثقة واسع (من اختبار ضعيف القوة) يمكن أن يكون فرصة حقيقية تستحق متابعة أكبر ومُعدّة جيدًا من حيث القوة الإحصائية. الدلالة وحجم الأثر هما مقبلان مستقلان. اقرأ كلاهما.
دال إحصائيًا لكن يستحق النشر؟
نفّذ فريق المنصة لديك تجربة صارمة ومُحكمة إحصائيًا على 4 ملايين جلسة. النتيجة: "تُزيد تخطيط صفحة الدفع الجديد بشكل كبير من عمليات الشراء المكتملة، p < 0.001. الارتفاع هو +0.05 نقطة مئوية (من 4.10% إلى 4.15% من معدل الإكمال)." يتطلب نشر هذا التخطيط إعادة بناء تستغرق شهرين وسيعقّد قاعدة الكود. يجادل الفريق بأن "النتيجة ذات دلالة إحصائية، لذا نحن ملزمون بنشرها."
من جمع هذه البيانات، وهل يمكن تعميمها؟
جاءت الأرقام من مكان ما
قبل النظر في أي قيمة p أو فترة ثقة، اسأل من أين جاءت البيانات. هناك سؤالان يؤدّان معظم العمل: ما هو المعدل الأساسي (Base Rate)، وهل يمكن تعميم هذه العينة على المجتمع الذي تهمك؟
المعدلات الأساسية هي المرجع الذي تُقاس به كل المعدلات التي تقرأها. اختبار "دقيق بنسبة 95%" في كشف الاحتيال يبدو ممتازاً حتى تلاحظ أن الاحتيال يحدث في 0.1% من المعاملات فقط: عند هذا المعدل الأساسي، فإن الغالبية العظمى من المعاملات المُعلَّمة كاحتيال هي إنذارات خاطئة، لأن 5% من الأغلبية الضخمة من المعاملات الصادقة تتفوق على 95% من الأقلية الصغيرة من المعاملات الاحتيالية. تجاهل المعدل الأساسي هو الطريقة التي ينتج بها نموذج دقيق تقنياً تياراً من الإنذارات الضجيجية غير المفيدة. اسأل دائماً ما هو المعدل الكامن قبل الحكم على رقم معدل الكشف أو معدل الاستجابة.
المصدر (Provenance) هو سلسلة حيازة الرقم. من جمعه؟ وكيف؟ ومن أي مجموعة؟ استبيان أجاب عنه مستخدموك الأكثر تفاعلاً لا يصف مستخدميك الذين غادروا الخدمة. معدل تحويل قُيس خلال ترويج عطلات لا يصف يوم ثلاثاء عادي. معيار أداء (Benchmark) نفّذه المورّد الذي يبيع المنتج ليس قياساً محايداً. طريقة أخذ العينة، والتوقيت، والأداة المستخدمة، ومن يستفيد من النتيجة، كلها عوامل تؤثر في ما إذا كان الرقم يمكن تعميمه على قرارك.
التعميم (Generalization) هو البوابة الأخيرة. البيانات المجمعة في سياق واحد (دولة واحدة، موسم واحد، فئة عملاء واحدة، جهاز واحد) قد لا تنطبق على سياق آخر. قد يكون الرقم مقاساً بدقة تامة ومع ذلك يكون الرقم الخاطئ لسؤالك. "صحيح هنا" و"صحيح لقراري" ادعاءان مختلفان.
دراسة الحالة على موقع المورّد
تدّعي صفحة الهبوط الخاصة بمورّد برمجيات أن "الشركات التي تستخدم أداةنا شهدت زيادة في الإنتاجية بنسبة 35%". يأتي هذا الرقم من دراسة حالة لثلاث شركات عملاء اختارها المورّد وكتب عنها، وقُيست من خلال تقارير ذاتية من تلك الشركات حول الساعات الموفرة، وذلك خلال الشهر الأول بعد تدريب مباشر وشخصي (White-glove onboarding) من قبل فريق المورّد نفسه.
قائمة الشك السريع لمدة دقيقتين
نفّذ هذا ضد أي دراسة، أو لوحة بيانات، أو تقرير آلي
لديك الآن الانعكاسات الخمسة. إليك هذه القائمة التي يمكنك تنفيذها في أقل من دقيقتين ضد أي رقم واثق يصل إلى مكتبك.
1. العينة والقوة. ما حجم العينة التي تقف خلف هذا الرقم؟ هل هي كبيرة بما يكفي لكشف تأثير يستحق اتخاذ إجراء، أم صغيرة بما يكفي لتتأثر بعدد قليل من الملاحظات؟ المعدل على مجموعة صغيرة هو في الغالب ضوضاء.
2. الفاصل، وليس النقطة. هل يوجد فاصل ثقة أو شريط خطأ، أم مجرد تقدير نقطي عاري؟ النقطة بدون فاصل هي علامة تحذير. إذا تم مقارنة شيئين، هل يتداخل فاصلهما؟ التداخل يعني أن الفرق غير مُثبت.
3. كم عدد المقارنات؟ هل كان هذا اختباراً مُعلناً مسبقاً، أم الشريحة الأكثر حظاً من بين العديد؟ اسأل عن عدد المقاييس أو الشرائح أو المتغيرات التي تم فحصها. الفائز "المهم" المستخرج من عملية بحث يحتاج إلى مجموعة احتياطية جديدة أو تأكيد مسجل مسبقاً قبل أن تصدقه.
4. حجم التأثير مقابل الدلالة. ضع قيمة p جانباً للحظة: ما حجم التأثير، وهل هو كبير بما يكفي ليكون مهماً لهذا القرار مقابل تكلفته؟ "المهم" على عينة ضخمة قد يكون صغيراً بشكل تافه.
5. المعدل الأساسي والمصدر. ما هو المعدل الأساسي الذي يقف عليه هذا الرقم؟ من جمع البيانات، وكيف، وعلى من، ومن يستفيد من النتيجة؟ هل السياق الذي تم القياس فيه يتطابق مع القرار الذي تتخذه؟
جملة واحدة تحملها معك عند الخروج: الرقم هو ادعاء، وليس حقيقة، حتى ترى عيّنته، وفاصله، ومقارناته، وأصله. ستستمر الأدوات في إصدار أرقام واثقة. مهمتك هي قراءة الأشياء الأربعة التي تُهملها.
القراءة الموصى بها للتعمق أكثر هي كتاب داريل هاف "كيف تكذب بالإحصاءات"، وكتاب تشارلز ويلان "الإحصاءات العارية"، وكتابات ريجينا نوزو حول التلاعب بـ p-value، ودليل CONSORT لقراءة منهجية الدراسة.