Het dashboard twijfelt niet aan zichzelf
Cijfers arriveren vooraf bepaald
Dashboards, A/B-testtools en geautomatiseerde analytics sturen nu beslissingen aan in de hele handelswereld. Ze produceren cijfers die definitief lijken: "variant B verhoogt de conversie met 12%", "deze cohort churns 3x sneller", "de campagne leverde 4,2x op". De interface toont elk cijfer in een zelfverzekerd lettertype, zonder wankelen, zonder sterretje, zonder twijfel.
Het probleem is dat een groot deel van die cijfers afkomstig is van steekproeven die wild schommelen, van vergelijkingen die selectief zijn gekozen, of van tests die stilletjes herhaald werden tot iets een grens overschreed. Het tool vlagt niets van dat alles. Het rapporteert het cijfer en gaat verder.
Jouw voordeel als besluitvormer is niet zelf de statistiek draaien. Het is de steekproef, het interval, de vergelijkingen en de effectgrootte goed genoeg lezen om te weten welke zelfverzekerde cijfers je kunt vertrouwen, welke je moet aanhouden, en welke je terug moet sturen voor meer data.
Deze les behandelt vijf reflexen: (1) steekproefgrootte en ruis, (2) betrouwbaarheidsintervallen en onzekerheid, (3) p-hacking en meervoudige vergelijkingen, (4) effectgrootte versus statistische significantie, en (5) basispercentages en herkomst. We sluiten af met een checklist die je in minder dan twee minuten kunt toepassen op elke studie of rapport.
Het A/B-testresultaat dat omkeerde
Een concreet scenario om mee te beginnen:
Je groeiteam lanceert op maandag een A/B-test. Op dinsdag toont het tool dat variant B met 18% wint, met een groen "significant"-badge, gebaseerd op 240 bezoekers per arm. Het team wil B direct voor iedereen uitrollen. Je vraagt hen om het nog even te laten draaien. Op de volgende maandag, bij 9.000 bezoekers per arm, is variant B in werkelijkheid 1% achter A, en het badge is verdwenen.
Kleine steekproeven schommelen hevig
Statistische kracht in gewone taal
Elke meting uit een steekproef is de werkelijke waarde plus ruis. Hoe kleiner de steekproef, hoe groter de ruis in verhouding tot het signaal. Dit is geen gebrek waar je code omheen kunt bouwen. Het is de rekenkunde van het gemiddeld nemen van minder observaties.
Een nuttige vuistregel: de ruis in een schatting neemt af met de wortel van de steekproefgrootte, niet met de steekproefgrootte zelf. Om je onzekerheid te halveren heb je vier keer zoveel data nodig. Om het tot een tiende te verkleinen heb je honderd keer zoveel data nodig. Dit is de reden waarom vroege resultaten zo volatiel zijn en waarom de laatste fase van een test zo langzaam aanvoelt.
Statistische power is de kans dat een test een reëel effect van een bepaalde grootte detecteert, mits dat effect daadwerkelijk bestaat. Een onderbemachtigde test is een test met te weinig observaties om het effect dat het zoekt betrouwbaar te zien. Onderbemachtigde tests falen in twee richtingen: ze missen reële effecten en wanneer ze wel een "significante" resultaat rapporteren, is dat resultaat waarschijnlijker een ruisachtige overschatting. Dit tweede falen, de versterkte winnaar, is wat besluitvormers het meest schaadt.
De praktische discipline: beslis vóór het uitvoeren van een test wat het kleinste effect is dat de moeite waard is om actie te ondernemen, en bereken vervolgens de benodigde steekproefgrootte om dit te detecteren. Voer de test uit tot die grootte. Lees niet de theedozen op de eerste dag.
Diagnose van een onderbemachtigd rapport
Een geautomatiseerd rapport landt op je bureau. Het vergelijkt churn (klantverlies) over 14 klantsegmenten dit kwartaal. De kop luidt: "Churn in segment 7 steeg naar 22%, ver boven het gemiddelde van 9%, onderzoek dringend." Je kijkt naar de kleine lettertjes. Segment 7 bevatte dit kwartaal 46 klanten. Segment 7 had 41 klanten vorig kwartaal, toen de churn 7% was.
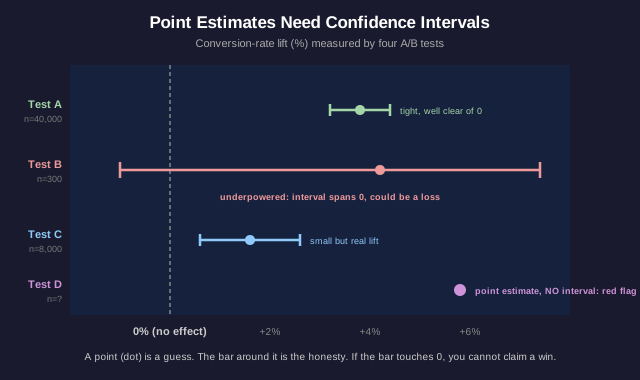
Een Puntinschatting Zonder Interval
De Balk Rond de Stip
Een puntinschatting is een enkele beste schatting: de lift is 12%, het gemiddelde is 4,2, de churn is 9%. Een betrouwbaarheidsinterval is het bereik dat de werkelijke waarde aannemelijk inneemt, gezien het ruisniveau in de data: de lift is 12%, plus of min 9%, dus aannemelijk ergens tussen 3% en 21%.
De puntinschatting is de gok. Het interval is de eerlijkheid. Een rapport dat een puntinschatting toont zonder interval, zonder foutenbalk, zonder bereik, verbergt het ene getal dat je het meest nodig hebt. Behandel een naakte puntinschatting als een rode vlag, niet als precisie.
Overlappende intervallen dragen een specifieke les in zich. Als het interval van variant A van 3% tot 21% loopt en het interval van variant B van 1% tot 19%, dan overlappen die bereiken zwaar. Je kunt niet beweren dat A beter is dan B, omdat de data consistent is met het idee dat ze gelijk zijn, of dat B voorop ligt. Twee puntinschattingen kunnen verschillen, terwijl hun intervallen aangeven dat het verschil ruis is.
Een subtielere val: een brede interval die volledig boven nul ligt, zegt je dat het effect echt is, maar dat de grootte onzeker is. Een brede interval die nul overschrijdt, zegt je dat je niet eens weet welk teken het effect heeft. Dat vereist verschillende beslissingen. De breedte van de interval is informatie, geen versiering.
Twee overlappende intervallen lezen
Een leverancier pitcht hun aanbevelingsmotor. Hun dia luidt: "Onze motor verhoogde de gemiddelde bestelwaarde naar $58,40 (95% BI $54,10 tot $62,70). De controlegroep had een gemiddelde van $55,90 (95% BI $51,30 tot $60,50)." Ze concluderen, in vet, "een duidelijke winst van $2,50 per bestelling, implementeer het."
Test Voldoende Dingen en Er Zal Iets Winnen
Hoe Meer Je Kijkt, Hoe Meer Je Vindt
Een p-waarde van 0,05 betekent dat als er in werkelijkheid geen effect zou zijn, je een resultaat zo sterk zou zien als puur toeval ongeveer 1 keer in de 20. Dat is een acceptabel risico wanneer je één eerlijke test uitvoert. Het wordt een bijna zekerheid voor een vals positief resultaat wanneer je twintig tests uitvoert.
Meerdere vergelijkingen: als een dashboard je gebruikers opslit in 20 dimensies (apparaat, regio, uur, verwijzer, planlaag, enzovoort) en welke slice dan ook markeert die "significant" lijkt, dan moet je ongeveer één valse winnaar per run verwachten, zelfs wanneer er niets reels aan de hand is. Het tooltje liegt niet over een enkele test. Het voert stilletjes vele tests uit en rapporteert de gelukkigste.
P-hacking is de familie van trucjes die significantie creëren: veel uitkomstmetingen proberen en de ene rapporteren die de grens overschreed, controles toevoegen en verwijderen tot de p-waarde daalt, de dataverzameling stoppen op het moment dat het significant lijkt, of de data opsplitsen in subgroepen tot één subgroep "reageert". Geen van deze vereist oneerlijkheid; gemotiveerde analisten p-hacken zonder het te merken.
De verdedigingsmaatregelen zijn structureel. Pre-registratie: schrijf de ene hypothese en de ene meting neer voordat je de data ziet. Een holdout: reserveer een verse slice data en bevestig dat het bevinding overleefd op data die geen kans had om te worden uitgekozen. Correctie: wanneer je vele tests moet uitvoeren, verhoog de lat (Bonferroni, false-discovery-rate controle) zodat de drempel rekening houdt met het aantal keekjes. Een bevinding die een holdout overleeft, is veel meer waard dan één die slechts 0,05 overschreed bij de eerste poging.
De analist die een winnaar vond
Een analist meldt "groot nieuws, we hebben ontdekt dat onze e-mailcampagne de aankopen significant heeft verhoogd (p = 0,03) onder gebruikers die Android gebruiken, in de leeftijdsgroep 25-34, en de e-mail na 20:00 uur hebben geopend." Ze vragen om budget om de campagne voor iedereen uit te rollen. U ontdekt dat de analist de aankooppercentages heeft bekeken over sneden van apparaat, leeftijdsgroep en tijdstip vóórdat ze op deze combinatie uitkwamen.
Significatie kan nog steeds betekenen: mini
Twee verschillende vragen
Statistische significantie beantwoordt één vraag: is dit effect te onderscheiden van nul? Effectgrootte beantwoordt een andere vraag: hoe groot is het effect? Een resultaat kan overtuigend significant en tegelijkertijd volledig triviaal zijn.
De schakel is de steekproefgrootte. Met een steekproef die groot genoeg is, wordt vrijwel elk verschil statistisch significant, omdat het interval krimpt totdat zelfs een microscopisch effect niet langer nul raakt. Een test op 5 miljoen gebruikers kan rapporteren dat een nieuwe knopkleur de klikken "significant" verhoogt met 0,02%, met p < 0,0001. De p-waarde is onberispelijk. Het effect is waardeloos.
Significantie zonder effectgrootte is dus slechts de helft van een zin. De vragen van de besluitvormer zijn: hoe groot is het effect, is het groot genoeg om voor deze beslissing te tellen, en overschrijdt de waarde ervan de kosten? Een verhoging van 0,02% die een half jaar aan engineeringwerk vereist, faalt op praktische gronden, hoe significant het ook mag zijn.
Kijk ook omgekeerd. Een grote, belovende effectgrootte met een breed interval (afkomstig van een onderbemachtigde test) kan een echte kans zijn die een grotere, goed bemachtigde opvolging waard is. Significantie en effectgrootte zijn twee onafhankelijke schuifregelaars. Lees beide.
Significant, maar de moeite waard om uit te rollen?
Jouw platformteam voerde een rigoureus, goed gemacht experiment uit op 4 miljoen sessies. Het resultaat: "het nieuwe checkout-ontwerp verhoogt significatief het aantal voltooide aankopen, p < 0,001. Het voordeel is +0,05 procentpunten (van 4,10% naar 4,15% voltooide aankopen)." Het implementeren van het ontwerp vereist een herbouw van twee maanden en zal de codebasis compliceren. Het team stelt: "het is statistisch significant, dus we zijn verplicht om het te implementeren."
Wie heeft dit verzameld, en is het generaliseerbaar?
De cijfers komen ergens vandaan
Vóórdat je naar een p-waarde of interval kijkt, vraag je waar de data vandaan komt. Twee vragen doen het grootste deel van het werk: wat is de basistax, en generaliseert deze steekproef naar de populatie die je interesseert?
Basistaxen vormen de anker voor elke rate die je leest. Een test die "95% nauwkeurig" is in het detecteren van fraude klinkt uitstekend, totdat je merkt dat fraude slechts in 0,1% van de transacties voorkomt: bij die basistax zijn de overgrote meerderheid van de gemarkeerde transacties valse meldingen, omdat 5% van de enorme eerlijke meerderheid 95% van de kleine frauduleuze minderheid overtreft. De basistax negeren is hoe een technisch accuraat model een nutteloos ruisende stroom meldingen produceert. Vraag altijd wat de onderliggende rate is voordat je een detectierate of responsrate oordeelt.
Herkomst is de bewaakingsketen van het cijfer. Wie heeft het verzameld? Hoe? Op wie? Een enquête beantwoord door je meest betrokken gebruikers beschrijft niet je churned gebruikers. Een conversierate gemeten tijdens een feestdagpromotie beschrijft geen gewone dinsdag. Een benchmark uitgevoerd door de leverancier die het product verkoopt, is geen neutrale meting. Bemonsteringsmethode, timing, instrument en wie profiteert van het resultaat bepalen allemaal of een cijfer generaliseert naar jouw beslissing.
Generalisatie is de laatste poort. Data verzameld in één context (één land, één seizoen, één klantsegment, één apparaat) kan niet naar een andere context worden overgenomen. Het cijfer kan perfect gemeten zijn en toch het verkeerde cijfer zijn voor jouw vraag. "Waar hier" en "waar voor mijn beslissing" zijn verschillende claims.
Het casusonderzoek op de website van de leverancier
De landingspagina van een softwareleverancier beweert dat "bedrijven die ons tool gebruikten een productiviteitsverhoging van 35% zagen". Het cijfer komt uit een casusonderzoek van 3 klantbedrijven die door de leverancier zijn geselecteerd en uitgeschreven, gemeten door zelfrapportage van bespaarde uren door die bedrijven, over de eerste maand na een hands-on white-glove onboarding door het eigen team van de leverancier.
De twee-minuten sceptische checklist
Voer dit uit voor elke studie, dashboard of geautomatiseerd rapport
Je hebt nu de vijf reflexen. Hier zijn ze als een checklist die je in minder dan twee minuten kunt doorlopen voor elk zelfverzekerd cijfer dat op je bureau belandt.
1. Steekproef en power. Hoe groot is de steekproef achter dit cijfer? Is het groot genoeg om een effect te detecteren dat de moeite waard is om actie te ondernemen, of klein genoeg om te schommelen door een handvol observaties? Een percentage op een kleine groep is grotendeels ruis.
2. Interval, geen punt. Is er een betrouwbaarheidsinterval of foutbalk, of slechts een naakte puntwaarde? Een punt zonder interval is een rode vlag. Als twee dingen worden vergeleken, overlappen hun intervallen dan? Overlap betekent dat het verschil niet is vastgesteld.
3. Hoeveel vergelijkingen? Was dit één vooraf aangekondigde test, of het gelukkigste fragment uit velen? Vraag hoeveel metingen, segmenten of varianten zijn onderzocht. Een "significante" winnaar die uit een zoektocht is gehaald, heeft een verse holdout of vooraf geregistreerde bevestiging nodig voordat je het gelooft.
4. Effectgrootte versus significantie. Zet de p-waarde even opzij: hoe groot is het effect, en is het groot genoeg om er voor deze beslissing toe te doen ten opzichte van de kosten? "Significant" op een enorme steekproef kan nog steeds triviaal klein zijn.
5. Basispercentage en herkomst. Wat is het onderliggende basispercentage waar dit cijfer tegenover staat? Wie heeft de data verzameld, hoe, op wie, en wie profiteert van het resultaat? Past de context waarin het is gemeten bij de beslissing die je neemt?
Eén zin om mee de deur uit te gaan: een getal is een bewering, geen feit, totdat je de steekproef, het interval, de vergelijkingen en de oorsprong ervan hebt gezien. De tools zullen blijven zelfverzekerde cijfers uitstoten. Jouw taak is om de vier dingen die ze weglaten te lezen.
Aanbevolen lectuur om dieper in te duiken zijn Darrell Huff's "How to Lie with Statistics", Charles Wheelan's "Naked Statistics", Regina Nuzzo's schrijverswerk over p-hacking, en de CONSORT-richtlijnen voor het lezen van de methodologie van een studie.