Le tableau de bord ne se doute pas de lui-même
Les chiffres arrivent pré-décidés
Les tableaux de bord, les outils de tests A/B et les analyses automatisées pilotent désormais les décisions dans tout le commerce. Ils émettent des chiffres qui semblent définitifs : « la variante B augmente la conversion de 12 % », « cette cohorte a un taux de désabonnement 3 fois plus rapide », « la campagne a généré un retour de 4,2x ». L'interface affiche chacun d'eux en caractères confiants, sans tremblement, sans astérisque, sans doute.
Le problème est qu'une grande partie de ces chiffres provient d'échantillons qui varient considérablement, de comparaisons qui ont été sélectionnées à la loupe, ou de tests qui ont été silencieusement répétés jusqu'à ce que quelque chose franchisse un seuil. L'outil ne signale rien de tout cela. Il rapporte le chiffre et passe à la suite.
Votre avantage en tant que décideur ne réside pas dans l'exécution des statistiques vous-même. Il réside dans la capacité à lire correctement l'échantillon, l'intervalle, les comparaisons et la taille de l'effet, afin de savoir quels chiffres confiants il faut faire confiance, lesquels mettre en attente et lesquels renvoyer pour obtenir plus de données.
Cette leçon aborde cinq réflexes : (1) la taille de l'échantillon et le bruit, (2) les intervalles de confiance et l'incertitude, (3) le p-hacking et les comparaisons multiples, (4) la taille de l'effet par rapport à la signification statistique, et (5) les taux de base et la provenance. Nous concluons avec une liste de vérification que vous pouvez appliquer à n'importe quelle étude ou rapport en moins de deux minutes.
Le résultat A/B qui s'est inversé
Un scénario concret pour commencer :
Votre équipe de croissance lance un test A/B le lundi. Dès le mardi, l'outil indique que la variante B gagne de 18 % avec un badge vert « significatif », basé sur 240 visiteurs par bras. L'équipe souhaite déployer B à tous immédiatement. Vous leur demandez de laisser le test se poursuivre. Le lundi suivant, avec 9 000 visiteurs par bras, la variante B est en réalité en retard de 1 % par rapport à A, et le badge a disparu.
Les petits échantillons varient fortement
La puissance statistique en termes simples
Toute mesure issue d'un échantillon est la valeur vraie plus du bruit. Plus l'échantillon est petit, plus le bruit est important par rapport au signal. Ce n'est pas un défaut que l'on peut contourner par le code. C'est l'arithmétique de la moyenne de moins d'observations.
Une règle pratique utile : le bruit dans une estimation diminue avec la racine carrée de la taille de l'échantillon, et non avec la taille de l'échantillon elle-même. Pour diviser votre incertitude par deux, il vous faut quatre fois plus de données. Pour la réduire à un dixième, il vous faut cent fois plus de données. C'est pourquoi les résultats initiaux sont si volatils et pourquoi la dernière phase d'un test semble lente.
La puissance statistique est la probabilité qu'un test détecte un effet réel d'une taille donnée, si cet effet existe véritablement. Un test sous-dimensionné est un test qui dispose de trop peu d'observations pour détecter de manière fiable l'effet qu'il recherche. Les tests sous-dimensionnés échouent dans deux directions : ils manquent les effets réels et, lorsqu'ils signalent un résultat « significatif », ce résultat est plus susceptible d'être une surestimation bruitée. Cet échec secondaire, le gagnant exagéré, est celui qui brûle les décideurs.
La discipline pratique : avant de lancer un test, déterminez le plus petit effet justifiant une action, puis calculez la taille d'échantillon nécessaire pour le détecter. Exécutez jusqu'à cette taille. Ne lisez pas les feuilles de thé dès le premier jour.
Diagnostic d'un rapport sous-dimensionné
Un rapport automatisé arrive sur votre bureau. Il compare l'attrition (churn) entre 14 segments de clients ce trimestre. Le titre indique : « L'attrition du segment 7 a bondi à 22 %, bien au-dessus de la moyenne de 9 %, enquête urgente requise ». Vous consultez les détails. Le segment 7 contient 46 clients ce trimestre. Le segment 7 comptait 41 clients le trimestre dernier, lorsque son taux d'attrition était de 7 %.
Une estimation ponctuelle sans intervalle
La barre autour du point
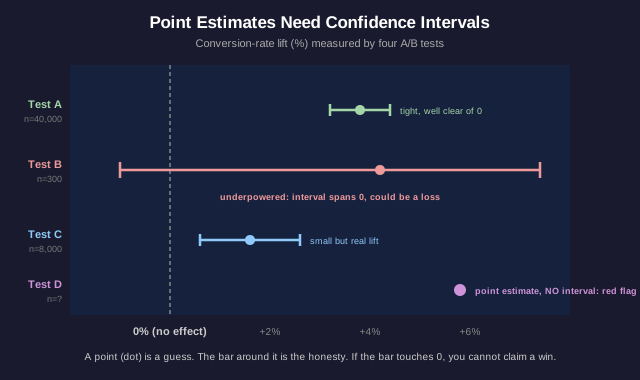
Une estimation ponctuelle est un seul nombre, le meilleur pari possible : le gain est de 12 %, la moyenne est de 4,2, le churn est de 9 %. Un intervalle de confiance est la plage dans laquelle la valeur vraie se situe plausiblement, compte tenu du bruit dans les données : le gain est de 12 %, plus ou moins 9 %, donc plausiblement n'importe où entre 3 % et 21 %.
L'estimation ponctuelle est le pari. L'intervalle est l'honnêteté. Un rapport qui affiche une estimation ponctuelle sans intervalle, sans barre d'erreur, sans plage, cache le seul nombre dont vous avez le plus besoin. Traitez une estimation ponctuelle nue comme un drapeau rouge, et non comme de la précision.
Les intervalles qui se chevauchent portent une leçon spécifique. Si l'intervalle de la variante A est de 3 % à 21 % et celui de la variante B est de 1 % à 19 %, ces plages se chevauchent fortement. Vous ne pouvez pas affirmer que A bat B, car les données sont cohérentes avec l'hypothèse qu'ils sont égaux, ou que B est en tête. Deux estimations ponctuelles peuvent différer alors que leurs intervalles indiquent que la différence est du bruit.
Un piège plus subtil : un intervalle large qui reste entièrement au-dessus de zéro vous indique que l'effet est réel, mais que sa taille est incertaine. Un intervalle large qui chevauche zéro vous indique que vous ne connaissez même pas le signe de l'effet. Ces situations exigent des décisions différentes. La largeur de l'intervalle est une information, pas une décoration.
Lire deux intervalles qui se chevauchent
Un fournisseur vous présente son moteur de recommandation. Sa diapositive indique : « Notre moteur a fait passer la valeur moyenne des commandes à 58,40 $ (IC à 95 % : de 54,10 $ à 62,70 $). Le groupe de contrôle a obtenu une moyenne de 55,90 $ (IC à 95 % : de 51,30 $ à 60,50 $). » Il conclut, en gras : « un gain net de 2,50 $ par commande, on le lance. »
Testez assez de choses et quelque chose gagnera
Plus vous regardez, plus vous trouvez
Une valeur p de 0,05 signifie que s'il n'y avait réellement aucun effet, vous observeriez un résultat aussi fort environ 1 fois sur 20 par pur hasard. C'est un risque tolérable lorsque vous effectuez un seul test honnête. Cela devient une quasi-certitude de faux positif lorsque vous en effectuez vingt.
Comparaisons multiples : si un tableau de bord découpe vos utilisateurs selon 20 dimensions (appareil, région, heure, référent, niveau d'abonnement, etc.) et signale quel que soit le segment qui semble « significatif », vous devriez vous attendre à environ un faux gagnant par exécution, même lorsque rien de réel ne se produit. L'outil ne ment pas sur un test individuel. Il exécute silencieusement de nombreux tests et rapporte le plus chanceux.
Le P-hacking est la famille de manœuvres qui fabriquent la signification statistique : essayer de nombreuses métriques de résultat et n'en rapporter qu'une qui a franchi le seuil, ajouter et retirer des contrôles jusqu'à ce que la valeur p baisse, arrêter la collecte de données dès que le résultat semble significatif, ou diviser les données en sous-groupes jusqu'à ce qu'un sous-groupe « réagisse ». Aucune de ces pratiques ne requiert de malhonnêteté ; les analystes motivés font du P-hacking sans s'en rendre compte.
Les défenses sont structurelles. Pré-enregistrement : notez l'hypothèse unique et la métrique unique avant de voir les données. Un jeu de données de contrôle (holdout) : réservez une tranche fraîche de données et confirmez que la découverte survit sur des données qui n'ont eu aucune chance d'être sélectionnées à l'avance. Correction : lorsque vous devez effectuer de nombreux tests, élevez la barre (Bonferroni, contrôle du taux de découverte fausse) pour que le seuil tienne compte du nombre de vérifications. Une découverte qui survit à un jeu de données de contrôle vaut bien plus qu'une qui a simplement franchi 0,05 au premier passage.
L'analyste qui a trouvé un gagnant
Un analyste rapporte de « bonnes nouvelles, nous avons constaté que notre campagne e-mail a considérablement augmenté les achats (p = 0,03) chez les utilisateurs sous Android, dans la tranche d'âge de 25 à 34 ans, qui ont ouvert l'e-mail après 20 h ». Il demande un budget pour étendre la campagne à tout le monde. Vous apprenez que l'analyste a examiné les taux d'achat selon les tranches de périphérique, de groupe d'âge et d'heure de la journée avant de se concentrer sur cette combinaison.
Significatif peut tout de même signifier minuscule
Deux questions différentes
La signification statistique répond à une question : cet effet est-il distinguable de zéro ? La taille de l'effet en répond à une autre : quelle est la magnitude de l'effet ? Un résultat peut être significatif de manière éclatante et totalement trivial en même temps.
Le lien est la taille de l'échantillon. Avec un échantillon suffisamment grand, presque toute différence devient statistiquement significative, car l'intervalle se rétrécit jusqu'à ce qu'un effet microscopique ne touche plus zéro. Un test sur 5 millions d'utilisateurs peut indiquer qu'une nouvelle couleur de bouton augmente « significativement » les clics de 0,02 %, avec p < 0,0001. La valeur de p est impeccable. L'effet est sans valeur.
Ainsi, la signification sans la taille de l'effet n'est que la moitié d'une phrase. Les questions du décideur sont : quelle est la magnitude de l'effet, est-elle assez grande pour compter pour cette décision, et sa valeur dépasse-t-elle son coût ? Une augmentation de 0,02 % qui nécessite un projet d'ingénierie de six mois échoue sur le plan pratique, quelle que soit sa signification statistique.
Inversez aussi la perspective. Une taille d'effet grande et prometteuse avec un intervalle large (provenant d'un test sous-dimensionné) peut être une véritable opportunité méritant un suivi plus important et correctement dimensionné. La signification et la taille de l'effet sont deux curseurs indépendants. Lisez les deux.
Significatif, mais mérite-t-il d'être déployé ?
Votre équipe plateforme a mené une expérience rigoureuse et bien dimensionnée sur 4 millions de sessions. Résultat : « la nouvelle disposition de la page de paiement augmente significativement les achats finalisés, p < 0,001. Le gain est de +0,05 point de pourcentage (passant de 4,10 % à 4,15 % de taux de complétion). » La mise en production de cette disposition nécessite une reconstruction de deux mois et compliquera la base de code. L'équipe argue : « c'est statistiquement significatif, nous sommes donc obligés de le mettre en production. »
Qui a collecté ces données, et sont-elles généralisables ?
Les chiffres proviennent de quelque part
Avant de considérer toute valeur p ou tout intervalle de confiance, demandez-vous d'où proviennent les données. Deux questions font l'essentiel du travail : quelle est la fréquence de base, et cet échantillon est-il généralisable à la population qui vous intéresse ?
Les fréquences de base servent de référence à tous les taux que vous lisez. Un test « 95 % précis » pour détecter la fraude semble excellent, jusqu'à ce que l'on constate que la fraude ne représente que 0,1 % des transactions : à cette fréquence de base, la grande majorité des transactions signalées sont de fausses alertes, car 5 % de l'immense majorité honnête dépassent largement 95 % de la petite minorité frauduleuse. Ignorer la fréquence de base est la raison pour laquelle un modèle techniquement précis produit un flux d'alertes inutilisable et bruyant. Demandez toujours quelle est la fréquence sous-jacente avant de juger un taux de détection ou un taux de réponse.
La provenance est la chaîne de traçabilité du chiffre. Qui l'a collecté ? Comment ? Sur qui ? Un sondage rempli par vos utilisateurs les plus engagés ne décrit pas vos utilisateurs qui ont résilié. Un taux de conversion mesuré pendant une promotion de fin d'année ne décrit pas un mardi ordinaire. Un benchmark réalisé par le vendeur du produit n'est pas une mesure neutre. La méthode d'échantillonnage, le moment, l'instrument de mesure et ceux qui tirent parti du résultat influencent tous sur la capacité d'un chiffre à se généraliser à votre prise de décision.
La généralisation est la dernière étape de validation. Des données collectées dans un contexte donné (un pays, une saison, une catégorie de clients, un appareil) peuvent ne pas être transposables à un autre contexte. Le chiffre peut être parfaitement mesuré et rester le mauvais chiffre pour votre question. « Vrai ici » et « vrai pour ma décision » sont deux affirmations différentes.
L'étude de cas sur le site du fournisseur
La page d'accueil d'un fournisseur de logiciels affirme que « les entreprises utilisant notre outil ont constaté une augmentation de 35 % de leur productivité ». Ce chiffre provient d'une étude de cas portant sur 3 entreprises clientes, sélectionnées et rédigées par le fournisseur, mesurées par l'auto-déclaration des heures économisées par ces entreprises, au cours du premier mois suivant un accompagnement personnalisé de proximité par l'équipe du fournisseur.
La liste de vérification du sceptique en deux minutes
Appliquez ceci à toute étude, tableau de bord ou rapport automatisé
Vous disposez désormais des cinq réflexes. Voici une liste de contrôle que vous pouvez exécuter en moins de deux minutes sur n'importe quel chiffre confiant qui atterrit sur votre bureau.
1. Échantillon et puissance. Quelle est la taille de l'échantillon derrière ce chiffre ? Est-il assez grand pour détecter un effet méritant une action, ou assez petit pour être influencé par une poignée d'observations ? Un taux sur un groupe minuscule est principalement du bruit.
2. Intervalle, pas point. Y a-t-il un intervalle de confiance ou une barre d'erreur, ou juste une estimation ponctuelle nue ? Un point sans intervalle est un signal d'alerte. Si deux éléments sont comparés, leurs intervalles se chevauchent-ils ? Un chevauchement signifie que la différence n'est pas établie.
3. Nombre de comparaisons. S'agit-il d'un test pré-déclaré unique, ou de la tranche la plus chanceuse parmi beaucoup ? Demandez combien de métriques, de segments ou de variantes ont été examinés. Un gagnant « significatif » extrait d'une recherche a besoin d'un nouveau groupe témoin ou d'une confirmation pré-enregistrée avant d'être cru.
4. Taille de l'effet par rapport à la significativité. Mettez la valeur p de côté un instant : quelle est la taille de l'effet, et est-elle assez grande pour compter pour cette décision par rapport à son coût ? « Significatif » sur un échantillon énorme peut toujours être trivialement petit.
5. Taux de base et provenance. Quel est le taux de base sous-jacent par rapport auquel ce chiffre se situe ? Qui a collecté les données, comment, sur qui, et qui bénéficie du résultat ? Le contexte dans lequel il a été mesuré correspond-il à la décision que vous prenez ?
Une phrase à emporter avec soi : un nombre est une affirmation, et non un fait, tant que vous n'avez pas examiné son échantillon, son intervalle, ses comparaisons et son origine. Les outils continueront à produire des chiffres confiants. Votre rôle est de lire les quatre éléments qu'ils omettent.
Pour approfondir, il est recommandé de lire « How to Lie with Statistics » de Darrell Huff, « Naked Statistics » de Charles Wheelan, les écrits de Regina Nuzzo sur le p-hacking, et les directives CONSORT sur la lecture des méthodes d'une étude.