Bảng Điều Khiển Không Tự Hoài Nghi Về Chính Nó
Các Con Số Đến Đã Được Định Trước
Các bảng điều khiển (dashboard), công cụ kiểm thử A/B và phân tích tự động hiện đang thúc đẩy các quyết định trong thương mại. Chúng phát ra những con số trông có vẻ cuối cùng: "biến thể B tăng chuyển đổi 12%", "nhóm này rời đi nhanh gấp 3 lần", "chiến dịch này mang lại lợi nhuận 4,2 lần". Giao diện hiển thị mỗi con số bằng kiểu chữ đầy tự tin, không có sự dao động, không có dấu hoa thị, không có sự nghi ngờ.
Vấn đề là một phần lớn trong số những con số đó đến từ các mẫu dao động dữ dội, từ các so sánh được chọn lọc theo ý muốn, hoặc từ các bài kiểm tra được lặp lại âm thầm cho đến khi có thứ gì đó vượt qua một ngưỡng. Công cụ không đánh dấu bất kỳ điều nào trong số đó. Nó báo cáo con số và tiếp tục.
Lợi thế của bạn với tư cách là người ra quyết định không phải là tự mình chạy các phép thống kê. Nó là đọc mẫu, khoảng tin cậy, các so sánh và kích thước hiệu ứng đủ tốt để biết những con số đầy tự tin nào nên tin tưởng, những con số nào nên giữ lại, và những con số nào nên gửi lại để lấy thêm dữ liệu.
Bài học này bao gồm năm phản xạ: (1) kích thước mẫu và nhiễu, (2) khoảng tin cậy và sự không chắc chắn, (3) p-hacking và so sánh đa biến, (4) kích thước hiệu ứng so với ý nghĩa thống kê, và (5) tỷ lệ nền và nguồn gốc. Chúng ta sẽ kết thúc bằng một danh sách kiểm tra mà bạn có thể áp dụng cho bất kỳ nghiên cứu hoặc báo cáo nào trong chưa đầy hai phút.
Kết quả A/B Đã Đảo Chiều
Một kịch bản cụ thể để mở đầu:
Đội ngũ tăng trưởng của bạn khởi chạy một thử nghiệm A/B vào thứ Hai. Đến thứ Ba, công cụ cho thấy biến thể B chiến thắng với mức tăng 18% kèm theo huy hiệu "có ý nghĩa" màu xanh lá, dựa trên 240 khách truy cập cho mỗi nhánh. Đội ngũ muốn triển khai B cho tất cả mọi người ngay lập tức. Bạn yêu cầu họ để thử nghiệm tiếp tục chạy. Đến thứ Hai tuần sau, với 9.000 khách truy cập cho mỗi nhánh, biến thể B thực tế lại kém hơn A 1%, và huy hiệu đó đã biến mất.
Mẫu nhỏ dao động dữ dội
Công suất thống kê bằng ngôn ngữ thông thường
Mọi phép đo từ một mẫu đều là giá trị thực cộng với nhiễu. Mẫu càng nhỏ, nhiễu càng lớn so với tín hiệu. Đây không phải là khiếm khuyết mà bạn có thể viết code để khắc phục. Đây là phép tính của việc lấy trung bình từ ít quan sát hơn.
Một quy tắc ước lượng hữu ích: nhiễu trong một ước lượng giảm theo căn bậc hai của kích thước mẫu, chứ không phải theo chính kích thước mẫu. Để giảm một nửa độ không chắc chắn, bạn cần gấp bốn lần dữ liệu. Để cắt giảm nó xuống còn một phần mười, bạn cần gấp một trăm lần dữ liệu. Đây là lý do tại sao các kết quả ban đầu lại biến động mạnh và tại sao giai đoạn cuối của một bài kiểm thử lại cảm thấy chậm chạp.
Công suất thống kê (statistical power) là xác suất để một phép kiểm tra phát hiện ra một hiệu ứng thực sự có kích thước nhất định, nếu hiệu ứng đó thực sự tồn tại. Một phép kiểm tra thiếu công suất (underpowered) là phép kiểm tra có quá ít quan sát để có thể nhìn thấy một cách đáng tin cậy hiệu ứng mà nó đang tìm kiếm. Các phép kiểm tra thiếu công suất thất bại theo hai hướng: chúng bỏ sót các hiệu ứng thực sự, và, khi chúng báo cáo một kết quả "có ý nghĩa", kết quả đó có nhiều khả năng hơn là một ước tính quá mức do nhiễu. Sự thất bại thứ hai này, người chiến thắng bị phóng đại, là điều khiến các nhà ra quyết định chịu thiệt hại nặng nề nhất.
Kỷ luật thực hành: trước khi chạy một phép kiểm tra, hãy quyết định hiệu ứng nhỏ nhất đáng để hành động, sau đó tính toán kích thước mẫu cần thiết để phát hiện nó. Chạy đến kích thước đó. Đừng cố đoán ý trời từ lá trà vào ngày đầu tiên.
Chẩn đoán một Báo cáo Thiếu Công suất
Một báo cáo tự động được đặt trên bàn làm việc của bạn. Nó so sánh tỷ lệ khách hàng rời bỏ (churn) giữa 14 phân khúc khách hàng trong quý này. Tiêu đề nói: "Tỷ lệ churn của Phân khúc 7 đã tăng vọt lên 22%, cao hơn nhiều so với mức trung bình 9%, cần điều tra khẩn cấp." Bạn nhìn vào phần chữ nhỏ. Phân khúc 7 chứa 46 khách hàng trong quý này. Phân khúc 7 có 41 khách hàng vào quý trước, khi tỷ lệ churn của nó là 7%.
Ước lượng điểm mà không có khoảng
Thanh ngang quanh chấm
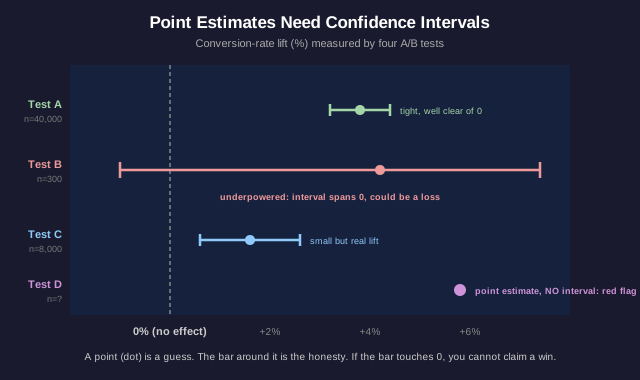
Một ước lượng điểm là một con số dự đoán tốt nhất duy nhất: mức tăng là 12%, trung bình là 4,2, tỷ lệ rời bỏ là 9%. Một khoảng tin cậy là phạm vi mà giá trị thực sự có thể nằm trong đó, xét theo nhiễu trong dữ liệu: mức tăng là 12%, cộng hoặc trừ 9%, vì vậy có thể nằm ở bất kỳ đâu từ 3% đến 21%.
Ước lượng điểm là lời dự đoán. Khoảng là sự trung thực. Một báo cáo chỉ hiển thị ước lượng điểm mà không có khoảng, không có thanh sai số, không có phạm vi, đang che giấu con số mà bạn cần nhất. Hãy coi một ước lượng điểm trần trụi là một cờ đỏ, chứ không phải là độ chính xác.
Các khoảng chồng chéo mang đến một bài học cụ thể. Nếu khoảng của biến thể A là từ 3% đến 21% và khoảng của biến thể B là từ 1% đến 19%, các phạm vi đó chồng chéo rất nhiều. Bạn không thể khẳng định A vượt trội hơn B, vì dữ liệu nhất quán với việc chúng bằng nhau, hoặc với việc B đang dẫn trước. Hai ước lượng điểm có thể khác nhau trong khi các khoảng của chúng cho thấy sự khác biệt đó chỉ là nhiễu.
Một cái bẫy tinh tế hơn: một khoảng rộng nhưng vẫn nằm hoàn toàn phía trên số 0 cho bạn biết rằng hiệu ứng là có thật nhưng kích thước của nó không chắc chắn. Một khoảng rộng cắt ngang qua số 0 cho bạn biết rằng bạn thậm chí còn không biết chắc về dấu của hiệu ứng. Những điều này đòi ra những quyết định khác nhau. Độ rộng của khoảng là thông tin, không phải là yếu tố trang trí.
Đọc Hai Khoảng Tin Cậy Chồng Chéo
Một nhà cung cấp giới thiệu cho bạn động cơ khuyến nghị của họ. Slide của họ ghi: "Động cơ của chúng tôi đã nâng giá trị đơn hàng trung bình lên 58,40 USD (khoảng tin cậy 95% từ 54,10 USD đến 62,70 USD). Nhóm đối chứng có giá trị đơn hàng trung bình là 55,90 USD (khoảng tin cậy 95% từ 51,30 USD đến 60,50 USD)." Họ kết luận, được in đậm, "một chiến thắng rõ ràng là 2,50 USD mỗi đơn hàng, hãy triển khai nó."
Kiểm tra đủ nhiều thứ và một thứ sẽ chiến thắng
Càng tìm kiếm nhiều, càng phát hiện nhiều
Một p-value là 0,05 có nghĩa là nếu thực sự không có hiệu ứng, bạn sẽ thấy một kết quả mạnh như vậy khoảng 1 lần trên 20 chỉ do may mắn thuần túy. Đó là một rủi ro có thể chấp nhận được khi bạn chạy một bài kiểm tra trung thực. Nó trở thành một sự chắc chắn gần như tuyệt đối về một dương tính giả khi bạn chạy hai mươi bài kiểm tra.
So sánh nhiều lần: nếu một bảng điều khiển chia nhỏ người dùng của bạn theo 20 chiều (thiết bị, khu vực, giờ, nguồn giới thiệu, cấp độ gói dịch vụ, v.v.) và đánh dấu bất kỳ lát cắt nào trông "có ý nghĩa thống kê", bạn nên kỳ vọng có khoảng một người chiến thắng giả mỗi lần chạy ngay cả khi không có điều gì thực sự đang xảy ra. Công cụ không nói dối về bất kỳ bài kiểm tra đơn lẻ nào. Nó đang âm thầm chạy nhiều bài kiểm tra và báo cáo cái may mắn nhất.
P-hacking là nhóm các thao tác tạo ra ý nghĩa thống kê: thử nhiều chỉ số kết quả và báo cáo cái vượt qua ngưỡng, thêm và bớt các biến kiểm soát cho đến khi p-value giảm xuống, dừng thu thập dữ liệu ngay khoảnh khắc nó trông có ý nghĩa thống kê, hoặc chia dữ liệu thành các nhóm con cho đến khi một nhóm con "phản ứng". Không có điều nào trong số này đòi hỏi sự thiếu trung thực; các nhà phân tích có động cơ sẽ p-hack mà không nhận ra.
Các biện pháp phòng thủ là mang tính cấu trúc. Đăng ký trước (Pre-registration): viết ra một giả thuyết duy nhất và một chỉ số duy nhất trước khi nhìn thấy dữ liệu. Một phần dữ liệu giữ lại (A holdout): dành riêng một lát cắt dữ liệu mới và xác nhận rằng phát hiện vẫn tồn tại trên dữ liệu mà không có cơ hội bị chọn lọc theo ý muốn. Hiệu chỉnh (Correction): khi bạn phải chạy nhiều bài kiểm tra, hãy nâng cao tiêu chuẩn (Bonferroni, kiểm soát tỷ lệ phát hiện sai) để ngưỡng tính đến số lần nhìn. Một phát hiện tồn tại qua phần dữ liệu giữ lại có giá trị cao hơn nhiều so với một phát hiện đơn thuần vượt qua 0,05 trong lần đầu tiên.
Nhà phân tích tìm thấy một "thắng lợi"
Một nhà phân tích báo cáo: "Tin tốt, chúng tôi phát hiện chiến dịch email của mình đã tăng đáng kể lượng mua hàng (p = 0.03) trong số người dùng sử dụng Android, thuộc nhóm tuổi 25-34, và mở email sau 8 giờ tối." Họ đang yêu cầu ngân sách để mở rộng chiến dịch này cho tất cả mọi người. Bạn tìm hiểu được rằng nhà phân tích đã xem xét tỷ lệ mua hàng trên các lát cắt theo thiết bị, nhóm tuổi và khung giờ trước khi chốt lại tổ hợp này.
Có ý nghĩa thống kê vẫn có thể là hiệu ứng rất nhỏ
Hai câu hỏi khác nhau
Ý nghĩa thống kê trả lời một câu hỏi: hiệu ứng này có thể phân biệt được với số không hay không? Kích thước hiệu ứng trả lời một câu hỏi khác: hiệu ứng đó lớn đến mức nào? Một kết quả có thể có ý nghĩa thống kê rất rõ ràng nhưng lại hoàn toàn tầm thường cùng một lúc.
Mối liên hệ nằm ở kích thước mẫu. Với một mẫu đủ lớn, hầu như mọi sự khác biệt đều trở nên có ý nghĩa thống kê, vì khoảng tin cậy thu hẹp lại cho đến khi ngay cả một hiệu ứng vi mô cũng không còn chạm vào số không. Một thử nghiệm trên 5 triệu người dùng có thể báo cáo rằng màu nút mới "có ý nghĩa thống kê" trong việc tăng lượt nhấp 0,02%, với p < 0,0001. Giá trị p là hoàn hảo. Hiệu ứng thì vô giá trị.
Vì vậy, ý nghĩa thống kê mà không có kích thước hiệu ứng chỉ là nửa câu chuyện. Các câu hỏi của người ra quyết định là: hiệu ứng lớn đến mức nào, nó có đủ lớn để quan trọng cho quyết định này không, và giá trị của nó có vượt quá chi phí không? Một mức tăng 0,02% đòi hỏi một dự án kỹ thuật kéo dài sáu tháng sẽ thất bại về mặt thực tế bất kể nó có ý nghĩa thống kê đến đâu.
Hãy lật ngược lại vấn đề. Một kích thước hiệu ứng lớn, đầy hứa hẹn nhưng với khoảng tin cậy rộng (từ một thử nghiệm thiếu công suất) có thể là một cơ hội thực sự đáng để thực hiện một thử nghiệm tiếp theo lớn hơn, có công suất phù hợp. Ý nghĩa thống kê và kích thước hiệu ứng là hai núm chỉnh độc lập. Hãy đọc cả hai.
Có ý nghĩa thống kê nhưng đáng để triển khai không?
Đội ngũ nền tảng của bạn đã chạy một thử nghiệm nghiêm ngặt, có công suất thống kê cao trên 4 triệu phiên. Kết quả: "bố cục thanh toán mới làm tăng đáng kể số lượng đơn hàng hoàn tất, p < 0,001. Mức tăng là +0,05 điểm phần trăm (từ 4,10% lên 4,15% tỷ lệ hoàn tất)." Việc triển khai bố cục này đòi hỏi phải xây dựng lại trong hai tháng và sẽ làm phức tạp hóa mã nguồn. Đội ngũ lập luận rằng "nó có ý nghĩa thống kê, vì vậy chúng ta có nghĩa vụ phải triển khai."
Ai đã thu thập dữ liệu này, và nó có thể khái quát hóa không?
Các con số đến từ đâu
Trước bất kỳ p-value hay khoảng ước lượng nào, hãy hỏi xem dữ liệu đến từ đâu. Hai câu hỏi thực hiện phần lớn công việc: tỷ lệ nền (base rate) là gì, và mẫu này có thể khái quát hóa cho quần thể mà bạn quan tâm không?
Tỷ lệ nền (base rates) là điểm neo cho mọi tỷ lệ bạn đọc. Một bài kiểm tra "chính xác 95%" trong việc phát hiện gian lận nghe có vẻ tuyệt vời cho đến khi bạn nhận thấy gian lận chỉ xảy ra ở 0,1% các giao dịch: ở tỷ lệ nền đó, phần lớn các giao dịch bị cảnh báo là báo động giả, vì 5% của nhóm trung thực khổng lồ lớn hơn 95% của nhóm gian lận nhỏ bé. Bỏ qua tỷ lệ nền là cách một mô hình về mặt kỹ thuật chính xác tạo ra một luồng cảnh báo ồn ào và vô dụng. Luôn luôn hỏi tỷ lệ nền là gì trước khi đánh giá một con số về tỷ lệ phát hiện hoặc tỷ lệ phản hồi.
Nguồn gốc (Provenance) là chuỗi quản lý của con số. Ai đã thu thập nó? Bằng cách nào? Trên ai? Một cuộc khảo sát được trả lời bởi những người dùng tích cực nhất của bạn không mô tả những người dùng đã rời đi (churned). Một tỷ lệ chuyển đổi được đo trong một đợt khuyến mãi lễ hội không mô tả một ngày thứ Ba bình thường. Một bài kiểm chuẩn (benchmark) do nhà cung cấp bán sản phẩm thực hiện không phải là một phép đo trung lập. Phương pháp lấy mẫu, thời điểm, công cụ đo lường và ai được hưởng lợi từ kết quả đều ảnh hưởng đến việc một con số có thể khái quát hóa cho quyết định của bạn hay không.
Khái quát hóa (Generalization) là cổng kiểm tra cuối cùng. Dữ liệu được thu thập trong một bối cảnh (một quốc gia, một mùa, một tầng lớp khách hàng, một thiết bị) có thể không chuyển đổi được sang bối cảnh khác. Con số có thể được đo lường hoàn hảo và vẫn là con số sai cho câu hỏi của bạn. "Đúng ở đây" và "đúng cho quyết định của tôi" là những tuyên bố khác nhau.
Nghiên cứu tình huống trên trang web của nhà cung cấp
Trang đích của một nhà cung cấp phần mềm tuyên bố "các công ty sử dụng công cụ của chúng tôi đã thấy năng suất tăng 35%". Con số này đến từ một nghiên cứu tình huống của 3 công ty khách hàng do nhà cung cấp chọn và viết báo cáo, được đo lường bởi chính các công ty đó tự báo cáo số giờ tiết kiệm được, trong tháng đầu tiên sau khi được hỗ trợ tận tình (white-glove onboarding) bởi chính đội ngũ của nhà cung cấp.
Danh sách kiểm tra nghi ngờ trong hai phút
Áp dụng danh sách này cho bất kỳ nghiên cứu, bảng điều khiển, hoặc báo cáo tự động nào
Bạn giờ đã có năm phản xạ. Dưới đây là chúng dưới dạng một danh sách kiểm tra mà bạn có thể chạy trong chưa đầy hai phút đối với bất kỳ con số tự tin nào xuất hiện trên bàn làm việc của bạn.
1. Mẫu và công suất. Kích thước mẫu đằng sau con số này là bao nhiêu? Nó có đủ lớn để phát hiện một hiệu ứng đáng để hành động, hay đủ nhỏ để dao động chỉ vì một vài quan sát? Một tỷ lệ trên một nhóm nhỏ chủ yếu là nhiễu.
2. Khoảng, không phải điểm. Có khoảng tin cậy hoặc thanh sai số không, hay chỉ là một ước lượng điểm trần trụi? Một điểm không có khoảng là một cờ đỏ. Nếu hai thứ được so sánh, các khoảng của chúng có chồng lấn không? Chồng lấn có nghĩa là sự khác biệt chưa được xác lập.
3. Số lượng so sánh? Đây là một bài kiểm tra được tuyên bố trước, hay là lát cắt may mắn nhất trong số nhiều lát cắt? Hãy hỏi xem bao nhiêu chỉ số, phân khúc hoặc biến thể đã được xem xét. Một người chiến thắng "có ý nghĩa" được rút ra từ một cuộc tìm kiếm cần một nhóm giữ lại mới hoặc xác nhận được đăng ký trước khi bạn tin vào nó.
4. Kích thước hiệu ứng so với ý nghĩa thống kê. Đặt giá trị p sang một bên trong chốc lát: hiệu ứng lớn đến mức nào, và nó có đủ lớn để quan trọng cho quyết định này đối với chi phí của nó không? "Có ý nghĩa" trên một mẫu lớn vẫn có thể là nhỏ đến mức tầm thường.
5. Tỷ lệ nền và nguồn gốc. Tỷ lệ nền cơ bản mà con số này dựa vào là gì? Ai đã thu thập dữ liệu, bằng cách nào, trên ai, và ai được hưởng lợi từ kết quả? Bối cảnh mà nó được đo lường có khớp với quyết định bạn đang đưa ra không?
Một câu để mang theo khi rời đi: một con số là một tuyên bố, không phải một sự thật, cho đến khi bạn đã xem xét mẫu của nó, khoảng tin cậy của nó, các so sánh của nó và nguồn gốc của nó. Các công cụ sẽ tiếp tục đưa ra những con số đầy tự tin. Nhiệm vụ của bạn là đọc ra bốn điều mà chúng bỏ sót.
Tài liệu đọc thêm để tìm hiểu sâu hơn bao gồm "How to Lie with Statistics" của Darrell Huff, "Naked Statistics" của Charles Wheelan, các bài viết của Regina Nuzzo về p-hacking, và hướng dẫn CONSORT về cách đọc phương pháp của một nghiên cứu.