Dashborden ifrågasätter inte sig själva
Siffror anländer förutbestämda
Dashboards, A/B-testverktyg och automatiserad analys driver nu beslut inom handeln. De genererar siffror som ser slutgiltiga ut: "variant B ökar konverteringen med 12 %", "denna kohort har 3 gånger högre avhopp", "kampanjen gav 4,2 gånger avkastning". Gränssnittet visar varje siffra i ett självklart typsnitt, utan darr, utan fotnot, utan tvekan.
Problemet är att en stor del av dessa siffror kommer från stickprov som varierar kraftigt, från jämförelser som har plockats ut ur ur, eller från tester som tyst upprepat tills något passerade en gräns. Verktyget flaggar inget av detta. Det rapporterar siffran och går vidare.
Din fördel som beslutsfattare är inte att själv utföra statistiken. Det är att läsa stickprovet, intervallet, jämförelserna och effektstorleken tillräckligt väl för att veta vilka självklara siffror du kan lita på, vilka du bör behålla och vilka du bör skicka tillbaka för mer data.
Den här lektionen behandlar fem reflektioner: (1) stickningsstorlek och brus, (2) konfidensintervall och osäkerhet, (3) p-hacking och multipla jämförelser, (4) effektstorlek jämfört med statistisk signifikans, och (5) basfrekvenser och ursprung. Vi avslutar med en kontrolllista som du kan köra mot vilken studie eller rapport som helst på under två minuter.
A/B-resultatet som vände på sig
Ett konkret scenario att inleda med:
Ditt tillväxtteam lanserar en A/B-test på måndag. På tisdag visar verktyget att variant B vinner med 18 % med en grön "signifikant"-märke, baserat på 240 besökare per arm. Teamet vill skicka ut B till alla omedelbart. Du ber dem låta testet köra vidare. På följande måndag, vid 9 000 besökare per arm, ligger variant B faktiskt 1 % efter A, och märket är borta.
Små stickprov svänger kraftigt
Statistisk styrka i enkla ord
Varje mätning från ett stickprov är det sanna värdet plus brus. Ju mindre stickprovet är, desto större blir bruset i förhållande till signalen. Detta är inte ett fel som kan kringgås med kod. Det är aritmetiken att medelvärdesberäkna färre observationer.
En användlig tumregel: bruset i en uppskattning minskar med kvadratroten av stickprovsstorleken, inte med stickprovsstorleken själv. För att halvera osäkerheten krävs fyra gånger så mycket data. För att minska den till en tiondel krävs hundra gånger så mycket data. Det är därför tidiga resultat är så volatila och varför den sista sträckan av ett test känns långsam.
Statistisk styrka är sannolikheten att en test detekterar en verklig effekt av en given storlek, om den effekten verkligen existerar. Ett understyrkt test är ett med för få observationer för att tillförlitligt kunna se den effekt det letar efter. Understyrda test misslyckas på två sätt: de missar verkliga effekter och, när de ändå rapporterar ett "signifikant" resultat, är det resultatet mer troligt att vara ett brusigt överskattat värde. Det andra misslyckandet, den överdrivna vinnaren, är det som bränner beslutsfattare.
Den praktiska disciplinen: innan du kör ett test, bestäm den minsta effekt som är värd att agera på, beräkna sedan det stickprov som krävs för att detektera den. Kör till den storleken. Läs inte tecknen i kaffekoppen på dag ett.
Diagnostik av ett understyrkt rapport
En automatisk rapport hamnar på ditt skrivbord. Den jämför kundavhopp (churn) över 14 kundsegment i kvartalet. Rubriken säger "Segment 7:s avhopp steg till 22 %, långt över genomsnittet på 9 %, undersök akut". Du tittar på de små bokstäverna. Segment 7 innehåller 46 kunder i kvartalet. Segment 7 hade 41 kunder i föregående kvartal, då dess avhopp var 7 %.
En punktskattning utan intervall
Stolen runt punkten
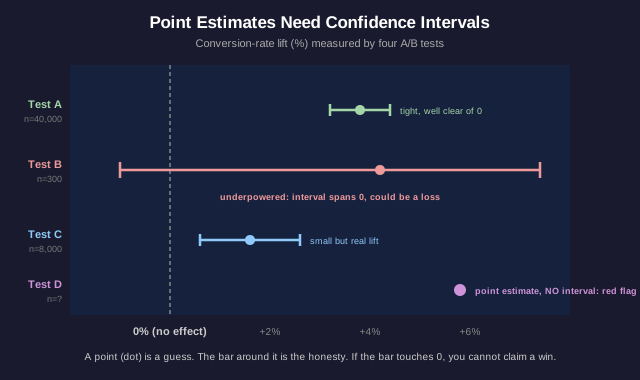
En punktskattning är ett enda bästa gissningsvärde: lyftet är 12 %, medelvärdet är 4,2, churn är 9 %. Ett konfidensintervall är det spann som det sanna värdet plausibelt kan ligga inom, givet bruset i datan: lyftet är 12 %, plus eller minus 9 %, så plausibelt någonstans mellan 3 % och 21 %.
Punktskattningen är gissningen. Intervallet är ärligheten. En rapport som visar en punktskattning utan intervall, utan felstolpe, utan spann, döljer det enda tal du absolut behöver. Behandla en "naken" punktskattning som en varning, inte som precision.
Överlappande intervall bär på en specifik lektion. Om variant A:s intervall är 3 % till 21 % och variant B:s intervall är 1 % till 19 %, överlappar dessa spann kraftigt. Du kan inte hävda att A slår B, eftersom datan är kompatibel med att de är lika, eller att B ligger i ledningen. Två punktskattningar kan skilja sig åt medan deras intervall visar att skillnaden är brus.
En subtilare fälla: ett brett intervall som ligger helt ovanför noll berättar att effekten är verklig men att dess storlek är osäker. Ett brett intervall som korsar noll berättar att du inte ens vet tecknet. Dessa kräver olika beslut. Intervallbredden är information, inte prydnad.
Att läsa två överlappande intervall
En säljare presenterar sitt rekommendationssystem. Deras bildtext lyder: "Vårt system höjde det genomsnittliga ordervärdet till 58,40 $ (95 % konfidensintervall 54,10 $ till 62,70 $). Kontrollgruppen hade ett genomsnitt på 55,90 $ (95 % konfidensintervall 51,30 $ till 60,50 $)." De drar slutsatsen, i fetstil, "en tydlig vinst på 2,50 $ per order, leverera det."
Testa tillräckligt många saker och något vinner
Ju mer du letar, desto mer hittar du
Ett p-värde på 0,05 betyder att om det faktiskt inte fanns någon effekt, skulle du se ett resultat av denna styrka ungefär 1 gång på 20 enbart på grund av slump. Det är ett acceptabelt risknivå när du kör ett ärligt test. Det blir dock en nära säkerhet för ett falskt positivt resultat när du tjugosådana.
Multipla jämförelser: om en dashboard skär upp dina användare efter 20 dimensioner (enhet, region, timme, hänvisare, planmässig nivå, och så vidare) och flaggar vilken skiva som ser "signifikant" ut, bör du förvänta dig ungefär en falsk vinnare per körning även när inget verkligt händer. Verktyget ljuger inte om något enskilt test. Det kör tyst många tester och rapporterar det mest lyckliga.
P-hacking är familjen av åtgärder som tillverkar signifikans: att prova många resultatmått och rapportera det som korsade gränsen, att lägga till och ta bort kontroller tills p-värdet sjunker, att stoppa datainsamlingen det ögonblick det ser signifikant ut, eller att dela upp datan i undergrupper tills en undergrupp "reagerar". Inget av detta kräver oärlighet; motiverade analytiker p-hackar utan att märka det.
Försvarsmekanismerna är strukturella. Förregistrering: skriv ner den enda hypotesen och det enda måttet innan du ser datan. En behållning: reservera en frisk del av datan och bekräfta att fyndet håller på data som inte hade någon chans att bli utvald med omsorg. Korrigering: när du måste köra många tester, höj kraven (Bonferroni, kontroll av falsk upptäcktsfrekvens) så att tröskeln tar hänsyn till antalet tittar. Ett fynd som överlever en behållning är värt mycket mer än ett som enbart korsade 0,05 vid första försöket.
Analysen som hittade en vinnare
En analytiker rapporterar "stora nyheter, vi har upptäckt att vår e-postkampanj ökade köpen signifikant (p = 0,03) bland användare som använder Android, i åldersgruppen 25–34 år, och som öppnade e-posten efter klockan 20.00". De begär budget för att skala upp kampanjen till alla. Du får veta att analytikern undersökte köpfrekvenser uppdelade efter enhet, åldersgrupp och tid på dagen innan de landade på just denna kombination.
Signifikant kan fortfarande betyda obetydligt
Två olika frågor
Statistisk signifikans besvarar en fråga: kan denna effekt skiljas från noll? Effektstorlek besvarar en annan: hur stor är effekten? En resultat kan vara överväldesande signifikant och helt och hållet trivialt samtidigt.
Länken är stickprovsstorleken. Med ett tillräckligt stort stickprov blir nästan vilken som helst skillnad statistiskt signifikant, eftersom intervallet krymper tills ens en mikroskopisk effekt inte längre rör vid noll. En test på 5 miljoner användare kan rapportera att en ny knappfärg "signifikant" ökar klick med 0,02 %, med p < 0,0001. p-värdet är felfritt. Effekten är värdelös.
Så signifikans utan effektstorlek är bara halva meningen. Beslutstagarens frågor är: hur stor är effekten, är den stor nog att ha betydelse för detta beslut, och överstiger dess värde dess kostnad? En ökning på 0,02 % som kräver ett ingreende projekt på sex månader misslyckas ur praktiska skäl oavsett hur signifikant den är.
Vänd på det också. En stor, lovande effektstorlek med ett brett intervall (från ett test med låg effekt) kan vara en genuin möjlighet som är värd ett större, korrekt dimensionerat uppföljande test. Signifikans och effektstorlek är två oberoende reglage. Läs båda.
Signifikant men värt att lansera?
Ditt plattformsteam genomförde en rigorös och väl-maktpålagd experiment på 4 miljoner sessioner. Resultatet: "Den nya kassan ökar signifikant antalet slutförda köp, p < 0,001. Ökningen är +0,05 procentenheter (från 4,10 % till 4,15 % slutförande)." Att skicka ut layouten kräver en ombyggnad på två månader och kommer att komplicera kodbasen. Teamet hävdar att "det är statistiskt signifikant, så vi är skyldiga att skicka ut det."
Vem samlade in detta, och kan det generaliseras?
Var kom siffrorna ifrån?
Innan du tittar på något p-värde eller intervall, fråga dig var data kommer ifrån. Två frågor gör det mesta av jobbet: Vad är basfrekvensen, och kan denna stickprov generaliseras till den population du bryr dig om?
Basfrekvenser är ankar för varje frekvens du läser. En test som är "95 % korrekt" vid detektion av bedrägeri låter utmärkt, tills du noterar att bedrägeri förekommer i 0,1 % av transaktionerna: vid den basfrekvensen är övervägande delen av de flaggade transaktionerna falska larm, eftersom 5 % av den enorma ärliga majoriteten övertrumfar 95 % av den lilla bedrägeriminoriteten. Att ignorera basfrekvensen är hur en tekniskt korrekt modell producerar en oanvändbar brusig larmström. Fråga alltid vad den underliggande frekvensen är innan du bedömer ett detektions- eller svarsfrekvenssifra.
Proveniens är kedjan av förvaring för siffran. Vem samlade in den? Hur? På vilka? En undersökning besvarad av dina mest engagerade användare beskriver inte dina avhoppade användare. En konverteringsfrekvens mätt under en högtidsförsäljning beskriver inte en vanlig tisdag. En benchmark körd av den säljare som säljer produkten är inte en neutral mätning. Urvalsmetod, tidpunkt, mätinstrument och vem som drar nytta av resultatet påverkar alla huruvida en siffra kan generaliseras till ditt beslut.
Generalisering är den sista grinden. Data insamlade i ett sammanhang (ett land, en säsong, en kundklass, en enhet) kan inte överföras till ett annat. Siffran kan vara perfekt mätt och ändå vara fel siffra för din fråga. "Sant här" och "sant för mitt beslut" är olika påståenden.
Fallstudien på säljarens webbplats
En mjukvarusäljares landningssida hävdar att "företag som använder vårt verktyg såg en 35 % ökning av produktiviteten". Siffran kommer från en fallstudie av 3 kundföretag som säljaren valde ut och skrev om, mätt genom att dessa företag själva rapporterade sparade timmar, under den första månaden efter en personlig "white-glove"-inbjudning av säljarens eget team.
Den tvåminuters skeptikers checklistan
Kör detta mot varje studie, instrumentpanel eller automatisk rapport
Du har nu de fem reflexerna. Här är de som en checklista som du kan köra på under två minuter mot varje självklart tal som hamnar på ditt bord.
1. Stickprov och styrka. Hur stort är stickprovet bakom detta tal? Är det stort nog att detektera en effekt som är värd att agera på, eller litet nog att det kan svänga på ett fåtal observationer? En rate på en liten grupp är mest brus.
2. Intervall, inte punkt. Finns det ett konfidensintervall eller ett felområde, eller bara en bar punktuppskattning? En punkt utan intervall är en varning. Om två saker jämförs, överlappar deras intervall? Överlappning innebär att skillnaden inte är etablerad.
3. Hur många jämförelser? Var detta en förutbestämd test, eller den mest lyckliga skivan av många? Fråga hur många metrik, segment eller varianter som undersöktes. En "signifikant" vinnare som plockas ur en sökning behöver ett nytt holdout eller förregistrerad bekräftelse innan du tror på den.
4. Effektnivå kontra signifikans. Lägg p-värdet åt sidan för en stund: hur stor är effekten, och är den stor nog att den spelar roll för detta beslut i förhållande till dess kostnad? "Signifikant" på ett enormt stickprov kan fortfarande vara försumbart litet.
5. Basrate och ursprung. Vad är den underliggande basraten som detta tal ligger mot? Vem samlade in datan, hur, på vilka, och vem gynnas av resultatet? Matchar sammanhanget det mättes i det beslut du gör?
En mening att ta med dig ut dörren: ett tal är ett påstående, inte en sanning, förrän du har sett dess urval, dess intervall, dess jämförelser och dess ursprung. Verktygen kommer att fortsätta att generera självsäkra siffror. Ditt jobb är att läsa de fyra sakerna de utelämnar.
Rekommenderad läsning för att fördjupa dig är Darrell Huff: "How to Lie with Statistics", Charles Wheelan: "Naked Statistics", Regina Nuzzos skrivelser om p-hacking, och CONSORT-riktlinjerna för att läsa en studiens metod.