El panel de control no se duda a sí mismo
Los números llegan predecididos
Los paneles de control, las herramientas de pruebas A/B y el análisis automatizado impulsan ahora las decisiones en todo el comercio. Emiten números que parecen definitivos: "la variante B aumenta la conversión un 12 %", "esta cohorte tiene una tasa de abandono 3 veces mayor", "la campaña tuvo un retorno de 4,2 veces". La interfaz renderiza cada uno con una tipografía confiable, sin vacilación, sin asterisco, sin duda.
El problema es que una gran parte de esos números proviene de muestras que fluctúan salvajemente, de comparaciones seleccionadas a dedo o de pruebas que se repitieron en silencio hasta que algo cruzó una línea. La herramienta no señala nada de eso. Informa el número y pasa al siguiente.
Tu ventaja como tomador de decisiones no es ejecutar tú mismo las estadísticas. Es leer la muestra, el intervalo, las comparaciones y el tamaño del efecto lo suficientemente bien para saber a qué números confiables confiar, cuáles retener y cuáles devolver para obtener más datos.
Esta lección cubre cinco reflejos: (1) tamaño de muestra y ruido, (2) intervalos de confianza e incertidumbre, (3) p-hacking y comparaciones múltiples, (4) tamaño del efecto frente a significancia estadística, y (5) tasas base y procedencia. Terminamos con una lista de verificación que puedes aplicar a cualquier estudio o informe en menos de dos minutos.
El resultado de la prueba A/B que se invirtió
Un escenario concreto para comenzar:
Tu equipo de crecimiento lanza una prueba A/B el lunes. Para el martes, la herramienta muestra que la variante B gana por un 18% con una insignia verde de "significativo", basada en 240 visitantes por brazo. El equipo quiere lanzar la B a todos de inmediato. Les pides que dejen que continúe. Para el lunes siguiente, con 9.000 visitantes por brazo, la variante B está en realidad un 1% por detrás de la A, y la insignia ha desaparecido.
Las muestras pequeñas fluctúan salvajemente
Potencia estadística en términos simples
Cada medición de una muestra es el valor verdadero más ruido. Cuanto más pequeña sea la muestra, mayor será el ruido en relación con la señal. Esto no es un defecto que se pueda evitar con código. Es la aritmética de promediar menos observaciones.
Una regla práctica útil: el ruido en una estimación disminuye con la raíz cuadrada del tamaño de la muestra, no con el tamaño de la muestra en sí. Para reducir a la mitad su incertidumbre, necesita cuatro veces más datos. Para reducirlo a una décima parte, necesita cien veces más datos. Por eso los resultados iniciales son tan volátiles y por qué el último tramo de una prueba se siente lento.
El potestad estadística es la probabilidad de que una prueba detecte un efecto real de un tamaño dado, si ese efecto existe verdaderamente. Una prueba con poca potencia es aquella que tiene demasiadas pocas observaciones para ver de manera fiable el efecto que busca. Las pruebas con poca potencia fallan en dos direcciones: se pierden efectos reales y, cuando sí reportan un resultado "significativo", es más probable que ese resultado sea una sobreestimación ruidosa. Este segundo fallo, el ganador exagerado, es el que quema a los tomadores de decisiones.
La disciplina práctica: antes de ejecutar una prueba, decide el efecto más pequeño que merece una acción y luego calcula el tamaño de muestra necesario para detectarlo. Ejecuta hasta ese tamaño. No intentes leer las hojas de té al primer día.
Diagnóstico de un informe con poca potencia
Un informe automatizado llega a tu escritorio. Compara la rotación (churn) entre 14 segmentos de clientes este trimestre. El titular dice: "La rotación del Segmento 7 saltó al 22%, muy por encima del promedio del 9%, investigar con urgencia". Miras las letras pequeñas. El Segmento 7 contiene 46 clientes este trimestre. El Segmento 7 tenía 41 clientes el trimestre pasado, cuando su rotación era del 7%.
Una estimación puntual sin intervalo
La barra alrededor del punto
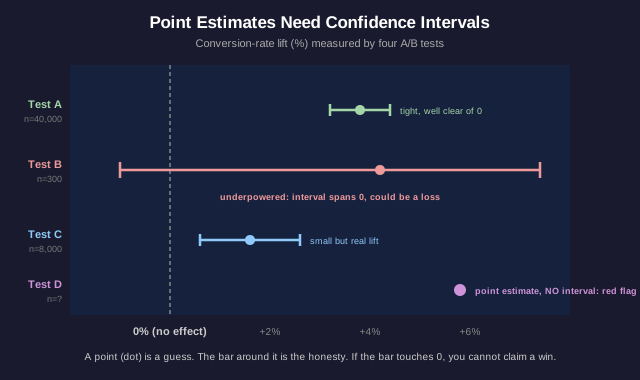
Una estimación puntual es un único número de mejor suposición: la mejora es del 12%, la media es 4,2, la cancelación es del 9%. Un intervalo de confianza es el rango que el valor verdadero ocupa plausiblemente dado el ruido en los datos: la mejora es del 12%, más o menos 9%, por lo que plausiblemente puede estar en cualquier parte entre el 3% y el 21%.
La estimación puntual es la suposición. El intervalo es la honestidad. Un informe que muestra una estimación puntual sin intervalo, sin barra de error, sin rango, está ocultando el número que más necesitas. Trata una estimación puntual desnuda como una bandera roja, no como precisión.
Los intervalos superpuestos llevan una lección específica. Si el intervalo de la variante A es del 3% al 21% y el intervalo de la variante B es del 1% al 19%, esos rangos se superponen en gran medida. No puedes afirmar que A supera a B, porque los datos son consistentes con que sean iguales, o con que B esté por delante. Dos estimaciones puntuales pueden diferir mientras sus intervalos indican que la diferencia es ruido.
Una trampa más sutil: un intervalo amplio que se sitúa por completo por encima de cero te indica que el efecto es real, pero que su magnitud es incierta. Un intervalo amplio que cruza por cero te indica que ni siquiera conoces el signo. Eso exige decisiones diferentes. El ancho del intervalo es información, no decoración.
Lectura de dos intervalos superpuestos
Un proveedor te presenta su motor de recomendaciones. Su diapositiva dice: "Nuestro motor elevó el valor medio del pedido a $58.40 (IC 95% de $54.10 a $62.70). El grupo de control promedió $55.90 (IC 95% de $51.30 a $60.50)". Concluyen, en negrita: "una clara ganancia de $2.50 por pedido, lánzalo".
Prueba Suficientes Cosas y Algo Ganará
Cuanto Más Buscas, Más Encuentras
Un valor p de 0,05 significa que si no hubiera ningún efecto real, verías un resultado tan fuerte aproximadamente 1 vez en 20 por puro azar. Es un riesgo tolerable cuando se realiza una única prueba honesta. Se convierte en una casi certeza de un falso positivo cuando se realizan veinte.
Comparaciones múltiples: si un panel de control divide a tus usuarios en 20 dimensiones (dispositivo, región, hora, referrer, nivel de plan, etc.) y marca como "significativo" cualquier segmento que lo parezca, debes esperar aproximadamente un "ganador" falso por cada ejecución, incluso cuando no está ocurriendo nada real. La herramienta no miente sobre ninguna prueba individual. Está ejecutando silenciosamente muchas pruebas e informando sobre la más afortunada.
El P-hacking es la familia de maniobras que fabrican la significancia: probar muchas métricas de resultado e informar solo sobre la que cruzó la línea, añadir y quitar controles hasta que el valor p baje, detener la recopilación de datos en el momento en que parece significativo, o dividir los datos en subgrupos hasta que un subgrupo "responda". Ninguna de estas acciones requiere deshonestidad; los analistas motivados hacen p-hacking sin darse cuenta.
Las defensas son estructurales. Pre-registro: escribir la única hipótesis y la única métrica antes de ver los datos. Un holdout (conjunto de retención): reservar una porción fresca de datos y confirmar que el hallazgo sobrevive en datos que no tuvieron la oportunidad de ser seleccionados a conveniencia. Corrección: cuando se deben realizar muchas pruebas, elevar la barra (Bonferroni, control de tasa de falsos descubrimientos) para que el umbral tenga en cuenta el número de observaciones. Un hallazgo que sobrevive a un holdout vale mucho más que uno que simplemente cruzó 0,05 en el primer intento.
El analista que encontró un ganador
Un analista informa: "grandes noticias, hemos descubierto que nuestra campaña de correo electrónico aumentó significativamente las compras (p = 0.03) entre los usuarios que usan Android, en el grupo de edad de 25 a 34 años, y que abrieron el correo después de las 8 p. m.". Están pidiendo presupuesto para escalar la campaña a todos. Descubres que el analista examinó las tasas de compra en diferentes segmentos por dispositivo, grupo de edad y hora del día antes de llegar a esta combinación.
Significativo puede significar diminuto
Dos preguntas diferentes
La significancia estadística responde a una pregunta: ¿se puede distinguir este efecto de cero? El tamaño del efecto responde a otra: ¿cuán grande es el efecto? Un resultado puede ser abrumadoramente significativo y, al mismo tiempo, completamente trivial.
El vínculo es el tamaño de la muestra. Con una muestra lo suficientemente grande, casi cualquier diferencia se vuelve estadísticamente significativa, porque el intervalo se reduce hasta que incluso un efecto microscópico ya no toca el cero. Una prueba con 5 millones de usuarios puede informar que un nuevo color de botón "aumenta significativamente" los clics en un 0,02 %, con p < 0,0001. El valor p es impecable. El efecto es inútil.
Por lo tanto, la significancia sin el tamaño del efecto es solo la mitad de una oración. Las preguntas del tomador de decisiones son: ¿cuán grande es el efecto, es lo suficientemente grande como para importar para esta decisión, y su valor supera su costo? Un aumento del 0,02 % que requiere un proyecto de ingeniería de seis meses falla en términos prácticos, no importa cuán significativo sea.
Dalo también la vuelta. Un tamaño de efecto grande y prometedor con un intervalo amplio (de una prueba con poca potencia) puede ser una oportunidad genuina que merece un seguimiento más grande y con la potencia adecuada. La significancia y el tamaño del efecto son dos controles independientes. Lee ambos.
¿Significativo pero con valor de implementación?
Tu equipo de plataforma realizó un experimento riguroso y con alta potencia estadística sobre 4 millones de sesiones. El resultado: "el nuevo diseño de la página de pago aumenta significativamente las compras completadas, p < 0.001. La mejora es de +0.05 puntos porcentuales (de un 4.10 % a un 4.15 % de finalización)". Implementar el diseño requiere una reconstrucción de dos meses y complicará la base de código. El equipo argumenta: "es estadísticamente significativo, por lo que estamos obligados a implementarlo".
¿Quién recopiló esto y es generalizable?
Los números provienen de algún lugar
Antes de cualquier valor p o intervalo, pregúntate de dónde provienen los datos. Dos preguntas hacen la mayor parte del trabajo: ¿cuál es la tasa base y esta muestra se generaliza a la población que te interesa?
Las tasas base anclan cada tasa que lees. Una prueba que es "95% precisa" para detectar fraude suena excelente hasta que notas que el fraude ocurre en el 0,1% de las transacciones: con esa tasa base, la gran mayoría de las transacciones marcadas son falsas alarmas, porque el 5% de la enorme mayoría honesta supera al 95% de la pequeña minoría fraudulenta. Ignorar la tasa base es la forma en que un modelo técnicamente preciso produce un flujo de alertas inútilmente ruidoso. Pregunta siempre cuál es la tasa subyacente antes de juzgar un número de tasa de detección o tasa de respuesta.
La procedencia es la cadena de custodia del número. ¿Quién lo recopiló? ¿Cómo? ¿Sobre quién? Una encuesta respondida por tus usuarios más comprometidos no describe a tus usuarios que abandonaron el servicio. Una tasa de conversión medida durante una promoción de temporada no describe un martes normal. Una prueba de rendimiento ejecutada por el vendedor que vende el producto no es una medición neutral. El método de muestreo, el momento, el instrumento y quién se beneficia del resultado determinan todo si un número se generaliza a tu decisión.
La generalización es la última barrera. Los datos recopilados en un contexto (un país, una temporada, un nivel de cliente, un dispositivo) pueden no transferirse a otro. El número puede estar perfectamente medido y aun así ser el número equivocado para tu pregunta. "Verdadero aquí" y "verdadero para mi decisión" son afirmaciones diferentes.
El estudio de caso en el sitio del proveedor
La página de inicio de un proveedor de software afirma: "las empresas que usan nuestra herramienta vieron un aumento del 35% en la productividad". La cifra proviene de un estudio de caso de 3 empresas clientes que el proveedor seleccionó y redactó, medido por la autodeclaración de horas ahorradas por esas empresas, durante el primer mes después de una capacitación presencial de alta gama realizada por el propio equipo del proveedor.
La lista de verificación de dos minutos del escéptico
Ejecuta esto contra cualquier estudio, panel de control o informe automatizado
Ahora tienes los cinco reflejos. Aquí los tienes como una lista de verificación que puedes ejecutar en menos de dos minutos contra cualquier número confiable que llegue a tu escritorio.
1. Muestra y potencia. ¿Qué tan grande es la muestra detrás de este número? ¿Es lo suficientemente grande para detectar un efecto que justifique una acción, o es tan pequeña que puede variar con solo unas pocas observaciones? Una tasa en un grupo diminuto es mayormente ruido.
2. Intervalo, no punto. ¿Hay un intervalo de confianza o una barra de error, o solo una estimación puntual desnuda? Un punto sin intervalo es una señal de alerta. Si se comparan dos cosas, ¿se solapan sus intervalos? El solapamiento significa que la diferencia no está establecida.
3. ¿Cuántas comparaciones? ¿Fue esta una prueba predeclarada, o el fragmento más afortunado de muchos? Pregunta cuántas métricas, segmentos o variantes se examinaron. Un ganador "significativo" extraído de una búsqueda necesita un grupo de control nuevo o una confirmación preregistrada antes de que lo creas.
4. Tamaño del efecto versus significancia. Deja el valor p de lado por un momento: ¿qué tan grande es el efecto y es lo suficientemente grande para importar en esta decisión frente a su costo? "Significativo" en una muestra enorme aún puede ser trivialmente pequeño.
5. Tasa base y procedencia. ¿Cuál es la tasa base subyacente contra la que se sitúa este número? ¿Quién recopiló los datos, cómo, en quién y quién se beneficia del resultado? ¿El contexto en el que se midió coincide con la decisión que estás tomando?
Una frase para llevarse al salir: un número es una afirmación, no un hecho, hasta que hayas visto su muestra, su intervalo, sus comparaciones y su origen. Las herramientas seguirán emitiendo cifras con confianza. Tu trabajo es leer las cuatro cosas que dejan fuera.
La lectura recomendada para profundizar es "How to Lie with Statistics" de Darrell Huff, "Naked Statistics" de Charles Wheelan, los escritos de Regina Nuzzo sobre el p-hacking y las directrices CONSORT sobre la lectura de los métodos de un estudio.