डैशबोर्ड खुद को संदेह नहीं करता
आंकड़े पहले से तय होकर आते हैं
व्यापार में निर्णयों को चलाने में अब डैशबोर्ड, A/B टेस्टिंग टूल्स और स्वचालित एनालिटिक्स की भूमिका है। ये ऐसे आंकड़े निकालते हैं जो अंतिम लगते हैं: "वैरिएंट B से कन्वर्जन 12% बढ़ा", "यह समूह 3x तेजी से चरम (churn) करता है", "कैंपेन ने 4.2x रिटर्न दिया"। इंटरफ़ेस प्रत्येक को आत्मविश्वास भरे अक्षरों में प्रस्तुत करता है, बिना किसी अस्थिरता के, बिना किसी एस्टेरिस्क के, और बिना किसी संदेह के।
समस्या यह है कि उन आंकड़ों का एक बड़ा हिस्सा उन नमूनों से आता है जो ज़ोरदार उतार-चढ़ाव दिखाते हैं, उन तुलनाओं से जो चुनिंदा रूप से चुनी गईं हैं, या उन परीक्षणों से जो चुपचाप दोहराए गए जब तक कि कुछ एक सीमा पार न कर जाए। टूल इनमें से किसी भी चीज़ का फ्लैग नहीं लगाता। यह आंकड़ा रिपोर्ट करता है और आगे बढ़ जाता है।
एक निर्णय लेने वाले के रूप में आपकी बढ़त स्वयं सांख्यिकी चलाकर नहीं है। यह नमूने, अंतराल, तुलनाओं और प्रभाव के आकार को इतनी अच्छी तरह पढ़ना है कि आप जान सकें कि किन आत्मविश्वास भरे आंकड़ों पर भरोसा करना है, किन्हें रोकना है, और किन्हें और डेटा के लिए वापस भेजना है।
यह पाठ पाँच प्रतिबिंबों (reflexes) को कवर करता है: (1) नमूना आकार और शोर (noise), (2) विश्वास अंतराल (confidence intervals) और अनिश्चितता, (3) p-hacking और बहु-तुलनाएँ (multiple comparisons), (4) प्रभाव का आकार (effect size) बनाम सांख्यिकीय महत्व (statistical significance), और (5) बेस रेट्स (base rates) और प्रामाणिकता (provenance)। हम एक चेकलिस्ट के साथ समाप्त करते हैं जिसे आप किसी भी अध्ययन या रिपोर्ट के विरुद्ध दो मिनट से कम समय में चला सकते हैं।
वह A/B परिणाम जो उलट गया
एक विशिष्ट दृश्य जिससे शुरुआत करने के लिए:
आपकी ग्रोथ टीम सोमवार को एक A/B टेस्ट शुरू करती है। मंगलवार तक टूल दिखाता है कि वेरिएंट B 18% से आगे है, एक हरे "महत्वपूर्ण" (significant) बैज के साथ, जो 240 विज़िटर प्रति आर्म (per arm) के आधार पर है। टीम B को तुरंत सभी के लिए शिप (ship) करना चाहती है। आप उन्हें इसे चलने देने के लिए कहते हैं। अगले सोमवार तक, 9,000 विज़िटर प्रति आर्म पर, वेरिएंट B वास्तव में A से 1% पीछे है, और बैज गायब है।
छोटे सैंपल ज़ोरदार उतार-चढ़ाव दिखाते हैं
सांख्यिकीय शक्ति (Statistical Power) सरल शब्दों में
सैंपल से प्राप्त हर मापन सच्चे मान (true value) और शोर (noise) का योग है। सैंपल जितना छोटा, संकेत (signal) के सापेक्ष शोर उतना बड़ा। यह कोई दोष नहीं है जिसे कोडिंग से दूर किया जा सके। यह कम अवलोकनों (observations) के औसत का गणित है।
एक उपयोगी नियम: अनुमान में शोर सैंपल साइज़ के वर्गमूल (square root) के साथ घटता है, सैंपल साइज़ के साथ नहीं। अपनी अनिश्चितता को आधा करने के लिए आपको चार गुना डेटा चाहिए। इसे दसवें हिस्से तक घटाने के लिए आपको सौ गुना डेटा चाहिए। इसीलिए प्रारंभिक परिणाम इतने अस्थिर होते हैं और टेस्ट के अंतिम हिस्से धीमे लगते हैं।
सांख्यिकीय शक्ति (Statistical power) वह संभावना है कि एक परीक्षण किसी वास्तविक प्रभाव को पकड़ लेता है, यदि वह प्रभाव वास्तव में मौजूद है। एक अपर्याप्त शक्ति वाला (underpowered) परीक्षण वह है जिसमें पर्याप्त अवलोकन (observations) नहीं होते ताकि वह जिस प्रभाव की खोज कर रहा है, उसे विश्वसनीय रूप से देख सकें। अपर्याप्त शक्ति वाले परीक्षण दो दिशाओं में विफल होते हैं: वे वास्तविक प्रभावों को चूक जाते हैं, और जब वे "महत्वपूर्ण" परिणाम रिपोर्ट करते हैं, तो वह परिणाम शोरदार (noisy) अतिरिक्त अनुमान (overestimate) होने की अधिक संभावना रखता है। यह दूसरी विफलता, अर्थात बढ़ा-चढ़ाकर पेश किया गया विजेता (exaggerated winner), ही निर्णय लेने वालों के लिए सबसे हानिकारक होती है।
व्यावहारिक अनुशासन: किसी भी परीक्षण को चलाए जाने से पहले, सबसे छोटा प्रभाव तय करें जिस पर कार्रवाई करने लायक है, फिर उस प्रभाव को पकड़ने के लिए आवश्यक नमूना आकार (sample size) की गणना करें। उस आकार तक ही परीक्षण चलाएं। पहले दिन ही अंदाजे (tea leaves) पढ़ने की कोशिश न करें।
अपर्याप्त शक्ति वाले रिपोर्ट का निदान
आपके डेस्क पर एक स्वचालित रिपोर्ट आती है। यह इस तिमाही में 14 ग्राहक खंडों (customer segments) के बीच चरन (churn) की तुलना करती है। शीर्षक में लिखा है, "खंड 7 का चरन 22% तक बढ़ गया है, जो 9% के औसत से बहुत ऊपर है, तुरंत जांच करें।" आप बारीकियों (fine print) को देखते हैं। इस तिमाही में खंड 7 में 46 ग्राहक हैं। पिछली तिमाही में खंड 7 में 41 ग्राहक थे, जब उसका चरन 7% था।
अंतराल के बिना एक बिंदु अनुमान
बिंदु के चारों ओर की पट्टी
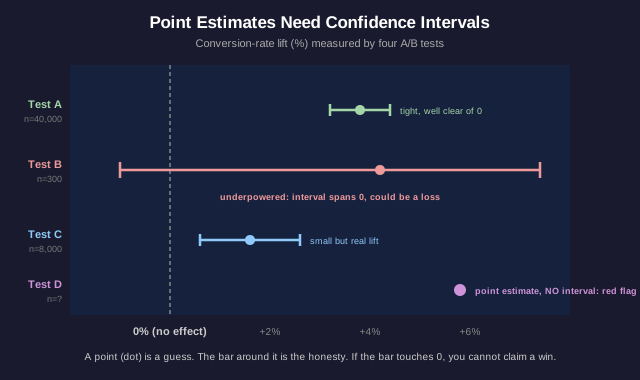
एक बिंदु अनुमान (point estimate) एक एकल सर्वोत्तम अनुमानित संख्या है: लिफ्ट 12% है, माध्य 4.2 है, चर्न 9% है। एक विश्वास अंतराल (confidence interval) वह दायरा है जिसमें सत्य मान डेटा में शोर (noise) को देखते हुए संभावित रूप से आता है: लिफ्ट 12% है, नौसे नौ (plus or minus 9%), इसलिए संभावित रूप से कहीं भी 3% से 21% के बीच हो सकता है।
बिंदु अनुमान अनुमान है। अंतराल ईमानदारी है। एक रिपोर्ट जो बिना किसी अंतराल, बिना किसी त्रुटि पट्टी (error bar), और बिना किसी दायरे के एक बिंदु अनुमान दिखाती है, वह वह एकमात्र संख्या छुपा रही है जिसकी आपको सबसे ज़रूरत है। एक नंगे बिंदु अनुमान को एक लाल झंडा (red flag) के रूप में मानें, सटीकता के रूप में नहीं।
ओवरलैपिंग अंतराल (Overlapping intervals) एक विशिष्ट पाठ ले जाते हैं। यदि वेरिएंट A का अंतराल 3% से 21% है और वेरिएंट B का अंतराल 1% से 19% है, तो ये दायरे भारी रूप से ओवरलैप करते हैं। आप यह दावा नहीं कर सकते कि A, B से बेहतर है, क्योंकि डेटा इस बात के अनुकूल है कि वे समान हैं, या B आगे है। दो बिंदु अनुमान अलग हो सकते हैं, जबकि उनके अंतराल यह कहते हैं कि अंतर शोर (noise) है।
एक सूक्ष्म जाल: एक चौड़ा अंतराल (wide interval) जो शून्य के ऊपर पूरी तरह से स्थित है, आपको बताता है कि प्रभाव वास्तविक है, लेकिन उसका आकार अनिश्चित है। एक चौड़ा अंतराल जो शून्य को पार करता है (straddles zero), आपको बताता है कि आपको चिह्न (sign) के बारे में भी पता नहीं है। इन दोनों स्थितियों में अलग-अलग निर्णय लेने की आवश्यकता होती है। अंतराल की चौड़ाई जानकारी है, सजावट नहीं।
दो ओवरलैपिंग (अतिव्यापक) अंतरालों को पढ़ना
एक विक्रेता आपको अपनी सिफारिश इंजन (recommendation engine) का प्रस्ताव प्रस्तुत करता है। उनकी स्लाइड पर लिखा है: "हमारा इंजन औसत ऑर्डर मूल्य को $58.40 तक बढ़ाया है (95% CI $54.10 से $62.70)। नियंत्रण समूह (control) का औसत $55.90 था (95% CI $51.30 से $60.50)।" वे बोल्ड में निष्कर्ष निकालते हैं, "प्रति ऑर्डर $2.50 की स्पष्ट जीत, इसे शिप करें।"
जितनी चीज़ों का परीक्षण करें, उतना ही कुछ जीतता है
जितना आप देखते हैं, उतना ही आप पाते हैं
0.05 का p-value इसका अर्थ है कि यदि वास्तव में कोई प्रभाव न हो, तो शुद्ध संयोग से आपको लगभग 20 में से 1 बार इतना मजबूत परिणाम दिखेगा। जब आप एक ईमानदार परीक्षण चलाते हैं, तो यह एक सहनशील जोखिम है। लेकिन जब आप बीस परीक्षण चलाते हैं, तो यह एक झूठे सकारात्मक (false positive) की लगभग निश्चितता बन जाता है।
Multiple comparisons: यदि एक डैशबोर्ड आपके उपयोगकर्ताओं को 20 आयामों (डिवाइस, क्षेत्र, घंटा, रेफरर, प्लान टियर, आदि) के अनुसार काटता है और यह फ्लैग करता है कि कौन सा स्लाइस "महत्वपूर्ण" (significant) लग रहा है, तो आपको उम्मीद करनी चाहिए कि जब कुछ वास्तविक हो रहा नहीं होता है, तब भी हर चालान में लगभग एक झूठा विजेता होगा। टूल किसी एकल परीक्षण के बारे में झूठ नहीं बोल रहा है। यह चुपचाप कई परीक्षण चला रहा है और सबसे भाग्यशाली (luckiest) को रिपोर्ट कर रहा है।
P-hacking उन चालों का परिवार है जो महत्व (significance) को बनाती हैं: कई आउटकम मेट्रिक्स की कोशिश करना और वह रिपोर्ट करना जो सीमा पार कर गया, p-value गिरने तक कंट्रोल जोड़ना और हटाना, डेटा संग्रह तब रोकना जब वह महत्वपूर्ण दिखने लगे, या डेटा को उपसमूहों (subgroups) में बांटना जब तक कि एक उपसमूह "प्रतिक्रिया" न दे। इनमें से किसी के लिए भी अमानिता की आवश्यकता नहीं है; प्रेरित विश्लेषक बिना ध्यान दिए p-hack कर जाते हैं।
रक्षात्मक उपाय संरचनात्मक (structural) हैं। Pre-registration: डेटा देखने से पहले एक परिकल्पना (hypothesis) और एक मेट्रिक लिख लें। A holdout: डेटा का एक नया स्लाइस आरक्षित करें और पुष्टि करें कि खोज उस डेटा पर भी टिकती है जिसकी चुनिंदा (cherry-picked) होने की कोई संभावना नहीं थी। Correction: जब आपको कई परीक्षण करने हों, तो मानक (bar) ऊपर उठाएं (Bonferroni, false-discovery-rate control) ताकि सीमा (threshold) देखने की संख्या को ध्यान में रखे। एक खोज जो holdout पर टिकती है, उसकी कीमत बहुत अधिक होती है, बजाय उस खोज की जो केवल पहली बार 0.05 पार करती है।
वह विश्लेषक जिसने विजेता खोजा
एक विश्लेषक ने रिपोर्ट किया, "बहुत अच्छी खबर है, हमने पाया कि हमारी ईमेल अभियान ने उन उपयोगकर्ताओं के बीच खरीदारी को महत्वपूर्ण रूप से बढ़ाया है (p = 0.03) जो Android पर हैं, 25-34 की आयु वर्ग में हैं, और जिन्होंने रात 8 बजे के बाद ईमेल खोला।" वे अभियान को सभी के लिए बढ़ाने के लिए बजट मांग रहे हैं। आपको पता चला कि विश्लेषक ने इस संयोजन पर पहुंचने से पहले डिवाइस, आयु वर्ग और समय-ofday (दिन के समय) के खंडों में खरीदारी दरों का विश्लेषण किया था।
महत्वपूर्ण होना छोटा भी हो सकता है
दो अलग-अलग प्रश्न
सांख्यिकीय महत्व एक प्रश्न का उत्तर देता है: क्या यह प्रभाव शून्य से अलग पहचाना जा सकता है? प्रभाव का आकार एक अलग प्रश्न का उत्तर देता है: प्रभाव कितना बड़ा है? एक परिणाम एक ही समय में बेहद महत्वपूर्ण और बिल्कुल बेमानी हो सकता है।
यह लिंक नमूना आकार (sample size) है। एक पर्याप्त बड़े नमूने के साथ, लगभग कोई भी अंतर सांख्यिकीय रूप से महत्वपूर्ण हो जाता है, क्योंकि अंतराल (interval) इतना सिकुड़ जाता है कि एक सूक्ष्म प्रभाव भी अब शून्य को स्पर्श नहीं करता। 5 मिलियन उपयोगकर्ताओं पर एक परीक्षण यह रिपोर्ट कर सकता है कि एक नया बटन रंग क्लिक्स को "महत्वपूर्ण रूप से" 0.02% बढ़ाता है, जिसमें p < 0.0001 है। p-मान (p-value) अतुलनीय है। प्रभाव बेकार है।
तो प्रभाव के आकार के बिना महत्व केवल एक वाक्य का आधा हिस्सा है। निर्णय लेने वाले के प्रश्न हैं: प्रभाव कितना बड़ा है, क्या यह इतना बड़ा है कि यह इस निर्णय के लिए महत्वपूर्ण हो, और क्या इसकी कीमत इसकी लागत से अधिक है? एक 0.02% की वृद्धि, जिसके लिए छह महीने का इंजीनियरिंग प्रोजेक्ट आवश्यक है, भले ही वह कितना भी महत्वपूर्ण हो, व्यावहारिक आधारों पर विफल हो जाती है।
इसे उल्टा भी देखें। एक बड़ा, वादा करने वाला प्रभाव का आकार जिसका अंतराल (interval) चौड़ा हो (अपर्याप्त शक्ति वाले परीक्षण से), वह एक वास्तविक अवसर हो सकता है जिसके लिए एक बड़ा, सही ढंग से शक्तिशाली (properly powered) अनुवर्ती परीक्षण करने लायक है। महत्व और प्रभाव का आकार दो स्वतंत्र डायल हैं। दोनों को पढ़ें।
महत्वपूर्ण है, लेकिन शिप करने लायक?
आपकी प्लेटफ़ॉर्म टीम ने 4 मिलियन सेशन पर एक कठोर, अच्छी तरह से सशक्त (well-powered) प्रयोग चलाया। परिणाम यह है कि "नया चेकआउट लेआउट पूर्ण किए गए खरीदों को महत्वपूर्ण रूप से बढ़ाता है, p < 0.001। वृद्धि +0.05 प्रतिशत अंक है (4.10% से 4.15% पूर्णता तक)।" इस लेआउट को शिप करने के लिए दो महीने का पुनर्निर्माण आवश्यक है और यह कोडबेस को जटिल कर देगा। टीम का तर्क है कि "यह सांख्यिकीय रूप से महत्वपूर्ण है, इसलिए हम इसे शिप करने के लिए बाध्य हैं।"
इसे कौन एकत्र किया, और क्या यह सामान्यीकरण योग्य है?
आँकड़े कहीं से आए
किसी भी p-value या अंतराल (interval) से पहले, यह पूछें कि डेटा कहाँ से आया। दो प्रश्न अधिकांश काम करते हैं: बेस रेट (base rate) क्या है, और क्या यह नमूना (sample) उस जनसंख्या तक सामान्यीकृत होता है जिसके बारे में आपकी चिंता है?
बेस रेट (base rates) हर उस दर (rate) को आधार देते हैं जिसे आप पढ़ते हैं। एक टेस्ट जो धोखाधड़ी का पता लगाने में "95% सटीक" है, शानदार लगता है, जब तक आप यह न नोट करें कि धोखाधड़ी केवल 0.1% लेन-देन में होती है: उस बेस रेट पर, फ्लैग किए गए लेन-देन का अधिकांश हिस्सा झूठे अलार्म (false alarms) होते हैं, क्योंकि विशाल ईमानदार बहुमत का 5% छोटी धोखाधड़ी वाले अल्पसंख्यक का 95% से कहीं बड़ा होता है। बेस रेट को नजरअंदाज करना वही तरीका है जिससे एक तकनीकी रूप से सटीक मॉडल एक बेकार शोर भरी अलार्म स्ट्रीम (noisy alert stream) उत्पन्न करता है। हमेशा यह पूछें कि मूल दर (underlying rate) क्या है, इससे पहले कि आप डिटेक्शन दर (rate-of-detection) या प्रतिक्रिया दर (rate-of-response) की संख्या का मूल्यांकन करें।
प्रोवेंन्स (Provenance) संख्या की कस्टडी की श्रृंखला (chain of custody) है। इसे कौन एकत्र किया? कैसे? किस पर? एक सर्वेक्षण जो आपके सबसे सक्रिय उपयोगकर्ताओं द्वारा उत्तरित किया गया है, आपके उन उपयोगकर्ताओं का वर्णन नहीं करता जो छोड़ गए हैं (churned users)। एक कन्वर्जन दर (conversion rate) जो किसी त्योहारी प्रमोशन के दौरान मापी गई है, सामान्य मंगलवार का वर्णन नहीं करती। उत्पाद बेचने वाले विक्रेता द्वारा चलाया गया कोई भी बेंचमार्क (benchmark) एक तटस्थ मापन नहीं है। सैंपलिंग विधि, समय, उपकरण, और परिणाम से किसे लाभ होता है, ये सभी यह तय करते हैं कि कोई संख्या आपके निर्णय तक सामान्यीकृत होती है या नहीं।
सामान्यीकरण (Generalization) अंतिम गेट है। एक संदर्भ (एक देश, एक मौसम, एक ग्राहक स्तर, एक डिवाइस) में एकत्र किया गया डेटा दूसरे संदर्भ में स्थानांतरित नहीं हो सकता। संख्या पूरी तरह से मापी गई हो सकती है और फिर भी आपके प्रश्न के लिए गलत संख्या हो सकती है। "यहाँ सच" और "मेरे निर्णय के लिए सच" अलग-अलग दावे हैं।
विक्रेता की साइट पर केस स्टडी
एक सॉफ्टवेयर विक्रेता की लैंडिंग पेज पर दावा किया गया है कि "हमारे टूल का उपयोग करने वाली कंपनियों को उत्पादकता में 35% की वृद्धि देखी गई।" यह आंकड़ा 3 ग्राहक कंपनियों की एक केस स्टडी से आया है, जिसे विक्रेता ने चुना और लिखा था, जिनकी मापन उन कंपनियों द्वारा स्वयं-रिपोर्ट किए गए बचे हुए घंटों (hours saved) के माध्यम से किया गया था, और यह मापन विक्रेता की अपनी टीम द्वारा हाथ से (hands-on) व्हाइट-ग्लोव ऑनबोर्डिंग (white-glove onboarding) के बाद पहले महीने के दौरान किया गया था।
दो-मिनट के संदेहवादी की चेकलिस्ट
किसी भी अध्ययन, डैशबोर्ड, या स्वचालित रिपोर्ट के विरुद्ध इसे चलाएं
अब आपके पास पाँच रिफ्लेक्स (reflexes) हैं। ये एक चेकलिस्ट के रूप में हैं जिसे आप किसी भी आत्मविश्वास से भरे नंबर के लिए, जो आपके डेस्क पर आता है, दो मिनट से कम समय में चला सकते हैं।
1. सैंपल और पावर। इस नंबर के पीछे का सैंपल कितना बड़ा है? क्या यह इतना बड़ा है कि वह एक ऐसा प्रभाव पकड़ सके जिस पर कार्रवाई करने लायक है, या इतना छोटा कि वह कुछ ही अवलोकनों (observations) पर झूल सके? एक छोटे से समूह पर दर (rate) ज्यादातर शोर (noise) होती है।
2. अंतराल, बिंदु नहीं। क्या कोई विश्वास अंतराल (confidence interval) या त्रुटि पट्टी (error bar) है, या केवल एक नंगे बिंदु का अनुमान (naked point estimate)? बिना अंतराल के बिंदु एक लाल झंडा (red flag) है। यदि दो चीज़ों की तुलना की जाती है, तो क्या उनके अंतराल एक-दूसरे के साथ ओवरलैप करते हैं? ओवरलैप का मतलब है कि अंतर स्थापित (established) नहीं है।
3. कितनी तुलनाएँ? क्या यह एक पूर्व-घोषित (pre-declared) परीक्षण था, या कई में से सबसे भाग्यशाली टुकड़ा? पूछें कि कितने मेट्रिक्स, खंड (segments), या भिन्नताएँ (variants) जांचे गए थे। खोज से निकाला गया एक "महत्वपूर्ण" विजेता को आपकी मानने से पहले एक नए होल्डआउट (holdout) या पूर्व-पंजीकृत (pre-registered) पुष्टि की आवश्यकता होती है।
4. प्रभाव का आकार बनाम महत्वता। एक पल के लिए p-मान (p-value) को एक तरफ रख दें: प्रभाव कितना बड़ा है, और क्या यह इस निर्णय के लिए उसके लागत के सापेक्ष पर्याप्त बड़ा है? एक विशाल सैंपल पर "महत्वपूर्ण" होना भी बहुत छोटा हो सकता है।
5. बेस रेट और प्रोवेनेंस (provenance)। यह नंबर किस मूल दर (base rate) के विरुद्ध है? डेटा कौन, कैसे, किस पर, और परिणाम से किसे लाभ होता है, उसने इकट्ठा किया? क्या वह संदर्भ जिसमें यह मापा गया था, आपके द्वारा किए जा रहे निर्णय से मेल खाता है?
दरवाज़े से बाहर निकलने के लिए एक वाक्य: जब तक आप उसकी नमूना (sample), उसका अंतराल (interval), उसकी तुलनाएँ, और उसकी उत्पत्ति नहीं देख लेते, तब तक कोई संख्या एक दावा है, तथ्य नहीं। उपकरण निरंतर आत्मविश्वास से आँकड़े निकालते रहेंगे। आपका काम उन चार चीज़ों को पढ़ना है जो वे छोड़ देते हैं।
गहरी समझ के लिए अनुशंसित पठन में डैरेल हफ़ के "How to Lie with Statistics", चार्ल्स वीलन के "Naked Statistics", रेजिना नुज़ो के p-hacking पर लेखन, और किसी अध्ययन की विधियों को पढ़ने के लिए CONSORT मार्गदर्शन शामिल हैं।