Дашборд не сомневается в себе
Цифры приходят уже предопределёнными
Дашборды, инструменты A/B-тестирования и автоматизированная аналитика сейчас управляют решениями во всём коммерческом секторе. Они выдают цифры, которые выглядят окончательными: «вариант B повышает конверсию на 12%», «этот когорт отток в 3 раза выше», «кампания окупилась в 4,2 раза». Интерфейс отображает каждую из них уверенным шрифтом, без колебаний, без звёздочек, без сомнений.
Проблема в том, что значительная часть этих цифр происходит из выборок, которые сильно колеблются, из сравнений, отобранных по принципу «виноградной лозы» (cherry-picked), или из тестов, которые тихо повторяли, пока что-то не пересекло порог. Инструмент не помечает ни одно из этих обстоятельств. Он просто сообщает цифру и переходит к следующему.
Ваше преимущество как лица, принимающего решения, заключается не в том, чтобы самому проводить статистические расчёты. Оно заключается в том, чтобы достаточно хорошо понимать выборку, интервал, сравнения и размер эффекта, чтобы знать, каким уверенным цифрам доверять, какие отложить, а какие отправить на доработку с дополнительными данными.
В этом уроке мы рассмотрим пять инстинктивных реакций: (1) размер выборки и шум, (2) доверительные интервалы и неопределенность, (3) p-hacking и множественные сравнения, (4) размер эффекта в противовес статистической значимости и (5) базовые частоты и происхождение данных. В завершение мы представим чек-лист, который можно применить к любому исследованию или отчету менее чем за две минуты.
Результат A/B-теста, который изменился на противоположный
Конкретный сценарий для начала:
Ваша команда роста запускает A/B-тест в понедельник. К вторнику инструмент показывает, что вариант B выигрывает с преимуществом в 18% и имеет зеленый значок «статистически значимо», основанный на 240 посетителях в каждой группе. Команда хочет сразу же внедрить вариант B для всех. Вы просите их дать тесту поработать. К следующему понедельнику, при 9 000 посетителей в каждой группе, вариант B на самом деле отстает от A на 1%, и значок исчез.
Маленькие выборки сильно колеблются
Статистическая мощность простыми словами
Любое измерение по выборке представляет собой истинное значение плюс шум. Чем меньше выборка, тем больше шум относительно сигнала. Это не дефект, который можно обойти в коде. Это арифметика усреднения меньшего числа наблюдений.
Полезное правило: шум в оценке уменьшается пропорционально квадратному корню из размера выборки, а не самому размеру выборки. Чтобы вдвое сократить неопределённость, нужно в четыре раза больше данных. Чтобы сократить её в десять раз, нужно в сто раз больше данных. Именно поэтому ранние результаты так нестабильны и почему последний этап теста ощущается медленным.
Статистическая мощность — это вероятность того, что тест обнаружит реальный эффект заданного размера, если этот эффект действительно существует. Тест с недостаточной мощностью — это тест, в котором слишком мало наблюдений, чтобы надежно обнаружить искомый эффект. Тесты с недостаточной мощностью дают сбой в двух направлениях: они пропускают реальные эффекты, а когда все же сообщают о «значимом» результате, этот результат с большей вероятностью является зашумленной переоценкой. Именно этот второй тип сбоя — преувеличенный победитель — наносит наибольший ущерб лицам, принимающим решения.
Практическая дисциплина: перед запуском теста определите минимальный эффект, который стоит учитывать, затем рассчитайте необходимый размер выборки для его обнаружения. Проводите тест до достижения этого размера. Не пытайтесь гадать по чайной гуще на первый день.
Диагностика отчета с недостаточной мощностью
На ваш стол попадает автоматический отчет. В нем сравнивается отток клиентов по 14 сегментам за этот квартал. Заголовок гласит: «Отток в сегменте 7 вырос до 22%, что значительно выше среднего показателя в 9%, требуется срочное расследование». Вы смотрите в мелкий шрифт. В сегменте 7 в этом квартале 46 клиентов. В сегменте 7 в прошлом квартале было 41 клиент, и тогда отток составлял 7%.
Точечная оценка без интервала
Полоса вокруг точки
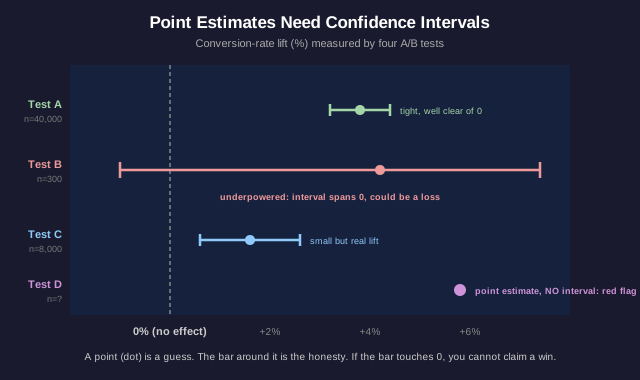
Точечная оценка — это единственное число, представляющее лучшую догадку: прирост составляет 12%, среднее значение равно 4,2, отток — 9%. Доверительный интервал — это диапазон, в котором, вероятно, находится истинное значение с учетом шума в данных: прирост составляет 12%, плюс-минус 9%, то есть, вероятно, где-то от 3% до 21%.
Точечная оценка — это догадка. Интервал — это честность. Отчет, в котором представлена точечная оценка без интервала, без полосы ошибок, без диапазона, скрывает то самое число, которое вам нужнее всего. Рассматривайте «голую» точечную оценку как тревожный сигнал, а не как точность.
Пересекающиеся интервалы несут в себе конкретный урок. Если интервал варианта А составляет от 3% до 21%, а интервал варианта B — от 1% до 19%, то эти диапазоны сильно пересекаются. Вы не можете утверждать, что вариант A лучше варианта B, поскольку данные согласуются с тем, что они равны, или с тем, что вариант B впереди. Две точечные оценки могут различаться, в то время как их интервалы говорят о том, что это различие — просто шум.
Более тонкая ловушка: широкий интервал, который всё же полностью находится выше нуля, говорит вам, что эффект реален, но его размер неопределён. Широкий интервал, пересекающий ноль, говорит вам, что вы даже не знаете знак эффекта. Эти ситуации требуют разных решений. Ширина интервала — это информация, а не украшение.
Чтение двух пересекающихся интервалов
Поставщик предлагает вам свой рекомендательный движок. На их слайде написано: «Наш движок поднял средний чек до $58.40 (95% ДИ: от $54.10 до $62.70). В контрольной группе средний чек составил $55.90 (95% ДИ: от $51.30 до $60.50)». Они делают вывод, выделенный жирным шрифтом: «Очевидная выгода в $2.50 на заказ, запускаем».
Тестируй достаточно много вещей, и что-то победит
Чем больше смотришь, тем больше находишь
P-значение 0,05 означает, что если бы эффекта действительно не было, вы бы увидели результат такой силы примерно в 1 случае из 20 исключительно из-за случайности. Это приемлемый риск, когда вы проводите один честный тест. Но это становится почти гарантией ложноположительного результата, когда вы проводите двадцать тестов.
Множественные сравнения: если дашборд разбивает ваших пользователей по 20 измерениям (устройство, регион, час, источник перехода, тарифный план и т. д.) и выделяет тот срез, который выглядит «значимым», вы должны ожидать примерно одного ложного победителя за каждый запуск, даже если ничего реального не происходит. Инструмент не лжет ни в одном отдельном тесте. Он молча проводит множество тестов и сообщает о самом удачном.
P-хакерство — это семейство приемов, которые искусственно создают значимость: пробовать множество метрик результата и сообщать о той, которая пересекла порог; добавлять и убирать контрольные группы, пока p-значение не снизится; останавливать сбор данных в тот момент, когда результат выглядит значимым; или делить данные на подгруппы, пока одна из подгрупп не «отреагирует». Ни одно из этих действий не требует нечестности; мотивированные аналитики занимаются p-хакерством, не замечая этого.
Защитные меры носят структурный характер. Предварительная регистрация: записать одну гипотезу и одну метрику до просмотра данных. Удерживаемая выборка (holdout): зарезервировать свежий срез данных и убедиться, что открытие сохраняется на данных, которые не имели возможности быть отобраны выборочно. Коррекция: когда необходимо провести множество тестов, повысить планку (коррекция Бонферрони, контроль ложной обнаружительной доли), чтобы порог учитывал количество попыток. Открытие, которое выдерживает проверку на удерживаемой выборке, стоит гораздо дороже, чем то, которое просто пересекло 0,05 при первой попытке.
Аналитик, который нашёл «выигрышную» комбинацию
Аналитик докладывает: «Отличные новости, мы выяснили, что наша email-кампания значительно увеличила объём покупок (p = 0,03) среди пользователей Android в возрастной группе 25–34 лет, открывших письмо после 20:00». Они просят бюджет для масштабирования кампании на всех пользователей. Вы узнаёте, что аналитик рассматривал показатели покупок по срезам: тип устройства, возрастная группа и время суток, прежде чем остановиться на этой конкретной комбинации.
Значимое может быть ничтожным
Два разных вопроса
Статистическая значимость отвечает на один вопрос: можно ли отличить этот эффект от нуля? Размер эффекта отвечает на другой вопрос: насколько велик эффект? Результат может быть безоговорочно значимым и при этом абсолютно незначительным.
Ключевым фактором здесь является размер выборки. При достаточно большом объёме выборки почти любое различие становится статистически значимым, поскольку доверительный интервал сужается до тех пор, пока даже микроскопический эффект перестаёт пересекаться с нулём. Тест на 5 миллионах пользователей может показать, что новый цвет кнопки «значительно» увеличивает количество кликов на 0,02%, при p < 0,0001. P-значение безупречно. Эффект бесполезен.
Таким образом, значимость без указания размера эффекта — это лишь половина фразы. Вопросы, на которые должен ответить принимающий решение, звучат так: каков размер эффекта, достаточно ли он велик, чтобы иметь значение для этого решения, и превышает ли его ценность связанные с ним затраты? Увеличение на 0,02%, требующее шестимесячного инженерного проекта, проигрывает с практической точки зрения, каким бы статистически значимым оно ни было.
Посмотрите на это и с другой стороны. Большой, многообещающий размер эффекта с широким доверительным интервалом (полученный в результате теста с недостаточной мощностью) может представлять собой реальную возможность, заслуживающую более крупного последующего исследования с надлежащей мощностью. Статистическая значимость и размер эффекта — это два независимых регулятора. Оценивайте оба.
Значимо, но стоит ли запускать?
Ваша продуктовая команда провела строгий, статистически мощный эксперимент на 4 миллионах сессий. Результат: «новая раскладка оформления заказа значительно увеличивает количество завершённых покупок, p < 0,001. Прирост составляет +0,05 процентных пункта (с 4,10% до 4,15% завершённых покупок)». Внедрение этой раскладки потребует двухмесячной переработки кода и усложнит кодовую базу. Команда утверждает: «Это статистически значимо, поэтому мы обязаны это внедрить».
Кто собрал эти данные и можно ли их обобщить?
Откуда взялись эти цифры
Прежде чем смотреть на p-значение или доверительный интервал, спросите, откуда взялись данные. Два вопроса решают большую часть работы: какова базовая частота (base rate) и можно ли обобщить эту выборку на ту популяцию, которая вас интересует?
Базовые частоты (base rates) служат опорой для любой частоты, которую вы читаете. Тест, который «на 95% точно» обнаруживает мошенничество, звучит отлично, пока вы не заметите, что мошенничество составляет всего 0,1% от всех транзакций: при такой базовой частоте подавляющее большинство помеченных транзакций будут ложными срабатываниями, потому что 5% от огромного большинства честных транзакций затмевает 95% от крошечного меньшинства мошеннических. Игнорирование базовой частоты — это путь, по которому технически точная модель производит бесполезный поток шумных оповещений. Всегда спрашивайте, какова фоновая частота, прежде чем оценивать показатель обнаружения или показатель отклика.
Происхождение данных (provenance) — это цепочка владения цифрой. Кто её собрал? Как? На ком? Опрос, заполненный вашими самыми вовлеченными пользователями, не описывает ваших ушедших пользователей. Конверсия, измеренная во время праздничной акции, не описывает обычный вторник. Бенчмарк, проведенный вендором, продающим продукт, — это не нейтральное измерение. Метод выборки, время, инструмент и то, кто выигрывает от результата, — все это влияет на то, можно ли обобщить цифру на ваше решение.
Обобщаемость — это последний рубеж. Данные, собранные в одном контексте (одна страна, один сезон, один сегмент клиентов, одно устройство), могут не переноситься на другой контекст. Цифра может быть измерена идеально точно, но при этом оказаться неправильной для вашего вопроса. «Это верно здесь» и «это верно для моего решения» — это разные утверждения.
Кейс на сайте вендора
На главной странице сайта программного вендора утверждается: «Компании, использующие наш инструмент, увидели рост производительности на 35%». Эта цифра взята из кейса о 3 клиентских компаниях, которые вендор сам выбрал и описал; метрикой служило самоотчетное количество сэкономленных часов, измеренное в первый месяц после персонального «белого перчаточного» внедрения, проведенного командой самого вендора.
Двухминутный чек-лист скептика
Проведите этот анализ для любого исследования, дашборда или автоматического отчета
Теперь у вас есть пять рефлексов. Вот они в виде чек-листа, который можно выполнить менее чем за две минуты для любого уверенного числа, попавшего на ваш стол.
1. Выборка и мощность. Каков размер выборки, лежащей в основе этого числа? Достаточно ли он велик, чтобы обнаружить эффект, заслуживающий действий, или настолько мал, что может колебаться из-за нескольких наблюдений? Показатель на небольшой группе — это в основном шум.
2. Интервал, а не точка. Есть ли доверительный интервал или ошибка, или это просто «голое» точечное значение? Точка без интервала — тревожный сигнал. Если сравниваются две вещи, пересекаются ли их интервалы? Пересечение означает, что разница не установлена.
3. Сколько сравнений? Это был один заранее объявленный тест или самый удачный срез из множества? Спросите, сколько метрик, сегментов или вариантов было изучено. «Значимому» победителю, выделенному в ходе поиска, требуется свежий холдаут или предварительная регистрация для подтверждения, прежде чем вы ему поверите.
4. Размер эффекта против значимости. Отложите p-значение в сторону на мгновение: каков размер эффекта и достаточно ли он велик, чтобы иметь значение для этого решения с учетом его стоимости? «Значимый» результат на огромной выборке может быть ничтожно малым.
5. Базовая частота и происхождение. Какова базовая частота, относительно которой рассматривается это число? Кто собрал данные, как, на ком и кто выигрывает от результата? Соответствует ли контекст, в котором проводилось измерение, решению, которое вы принимаете?
Одно предложение, которое стоит взять с собой: число — это утверждение, а не факт, пока вы не увидели его выборку, доверительный интервал, сравнения и источник. Инструменты будут продолжать выдавать уверенные цифры. Ваша задача — читать четыре вещи, которые они опускают.
Рекомендуемая литература для более глубокого изучения: «Как обманывать статистикой» Дэрелла Хаффа, «Голые статистики» Чарльза Уилана, статьи Регины Нуссо о p-хаккинге и рекомендации CONSORT по чтению методов исследования.