Dashboard nie wątpi w siebie
Liczby przychodzą z góry zadecydowane
Dashboards, narzędzia do testów A/B i automatyczna analityka napędzają obecnie decyzje w handlu. Generują liczby, które wyglądają na ostateczne: „wariant B zwiększa konwersję o 12%”, „ta kohorta odchodzi 3 razy szybciej”, „kampania zwróciła 4,2x”. Interfejs wyświetla każdą z nich pewnym fontem, bez wahania, bez gwiazdki, bez wątpliwości.
Problemem jest to, że duża część tych liczb pochodzi z próbek, które silnie się wahają, z porównań wybranych z czubka (cherry-picked) lub z testów, które były cicho powtarzane, aż coś przekroczyło próg. Narzędzie nie zaznacza żadnego z tych problemów. Raportuje liczbę i przechodzi dalej.
Twoją przewagą jako decydenta nie jest samodzielne przeprowadzanie statystyk. To czytanie próby, przedziałów, porównań i wielkości efektu na tyle dobrze, aby wiedzieć, którym pewnym liczbom ufać, które odłożyć, a które odesłać w celu zebrania więcej danych.
Ten lekcja obejmuje pięć refleksji: (1) rozmiar próby i szum, (2) przedziały ufności i niepewność, (3) p-hacking i porównania wielokrotne, (4) rozmiar efektu w porównaniu ze znaczeniem statystycznym oraz (5) stopy bazowe i pochodzenie. Zamykamy ją listą kontrolną, którą można przeprowadzić w dowolnym badaniu lub raporcie w mniej niż dwie minuty.
Wynik testu A/B, który się odwrócił
Konkretny scenariusz na otwarcie:
Twój zespół growth uruchamia test A/B w poniedziałek. We wtorek narzędzie pokazuje, że wariant B wygrywa z przewagą 18% z zieloną odznaką „istotny statystycznie”, na podstawie 240 odwiedzających na wariant. Zespół chce natychmiast wdrożyć B dla wszystkich. Prosisz ich, aby pozwolili testowi działać dalej. W następnym poniedziałku, przy 9 000 odwiedzających na wariant, wariant B jest w rzeczywistości o 1% za wariantem A, a odznaka zniknęła.
Małe próbki dają silnie zmienną zmienność
Moc statystyczna prostym językiem
Każdy pomiar z próby to wartość prawdziwa plus szum. Im mniejsza próba, tym większy szum w stosunku do sygnału. To nie jest wada, którą można obejść w kodzie. To jest arytmetyka średniej z mniejszej liczby obserwacji.
Przydatna zasada kciukowa: szum w szacunku maleje z pierwiastkiem kwadratowym z rozmiaru próby, a nie z samym rozmiarem próby. Aby zmniejszyć niepewność o połowę, potrzebujesz czterokrotnie więcej danych. Aby zmniejszyć ją do jednej dziesiątej, potrzebujesz setek razy więcej danych. Dlatego wczesne wyniki są tak zmienne i dlatego ostatni etap testu wydaje się powolny.
Moc statystyczna to prawdopodobieństwo, że test wykryje rzeczywisty efekt o danej wielkości, jeśli taki efekt faktycznie istnieje. Test o niewystarczającej mocy to taki, który ma zbyt mało obserwacji, aby wiarygodnie dostrzec efekt, którego szuka. Testy o niewystarczającej mocy zawiodą w dwóch kierunkach: pomijają rzeczywiste efekty, a gdy raportują wynik „istotny statystycznie”, jest on z większym prawdopodobieństwem szumną nadestymacją. To drugie zawalenie, czyli zawyżony wynik zwycięzcy, to ten, który najbardziej szkodzi decydentom.
Praktyczna dyscyplina: przed uruchomieniem testu określ najmniejszy efekt, który jest wart podjęcia działań, a następnie oblicz rozmiar próby potrzebny do jego wykrycia. Wykonaj test do tego rozmiaru. Nie interpretuj przesłanek na pierwszy dzień.
Diagnoza raportu o niewystarczającej mocy
Na Twoim biurku ląduje automatyczny raport. Porównuje on churn (odpływ klientów) w 14 segmentach klientów w tym kwartale. Nagłówek głosi: „Churn w segmencie 7 wzrósł do 22%, co znacznie przekracza średnią 9%, wymaga pilnego zbadania”. Spoglądasz na drobny druk. Segment 7 zawiera w tym kwartale 46 klientów. W poprzednim kwartale segment 7 miał 41 klientów, a jego churn wynosił 7%.
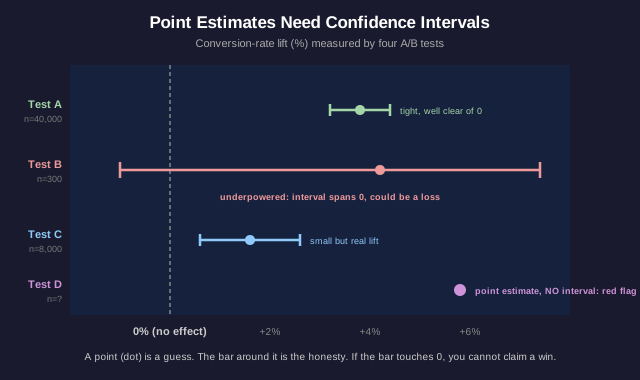
Szacunek punktowy bez interwału
Pasek wokół kropki
Szacunek punktowy to pojedyncza najlepsza wartość szacunkowa: wzrost wynosi 12%, średnia to 4,2, a odsetek odejść to 9%. Interwał ufności to zakres, w którym prawdziwa wartość prawdopodobnie się znajduje, z uwzględnieniem szumu w danych: wzrost wynosi 12%, plus lub minus 9%, więc prawdopodobnie mieści się gdzieś między 3% a 21%.
Szacunek punktowy to zgadywanie. Interwał to uczciwość. Raport, który pokazuje szacunek punktowy bez interwału, bez błędu, bez zakresu, ukrywa tę jedną liczbę, której najbardziej potrzebujesz. Traktuj „goły” szacunek punktowy jako sygnał ostrzegawczy, a nie jako precyzję.
Nakładające się interwały niosą konkretną lekcję. Jeśli interwał wariantu A to 3% do 21%, a interwał wariantu B to 1% do 19%, te zakresy w dużej mierze się nakładają. Nie możesz twierdzić, że A jest lepsze od B, ponieważ dane są spójne z tezą, że są równe, lub że B jest lepsze. Dwa szacunki punktowe mogą się różnić, podczas gdy ich interwały wskazują, że różnica to tylko szum.
Subtelniejsza pułapka: szeroki przedział, który nadal leży całkowicie powyżej zera, mówi Ci, że efekt jest rzeczywisty, ale jego wielkość jest niepewna. Szeroki przedział, który przecina zero, mówi Ci, że nie wiesz nawet o znaku efektu. Wymagają one różnych decyzji. Szerokość przedziału to informacja, a nie dekoracja.
Czytanie dwóch nakładających się przedziałów
Dostawca prezentuje Ci swój silnik rekomendacji. Na slajdzie czytamy: „Nasz silnik podniósł średnią wartość zamówienia do 58,40 USD (95% przedział ufności od 54,10 do 62,70 USD). Grupa kontrolna miała średnio 55,90 USD (95% przedział ufności od 51,30 do 60,50 USD)”. Wniosek, wypisany pogrubioną czcionką, brzmi: „jasny zysek 2,50 USD na zamówienie, wdrażaj”.
Przetestuj wystarczająco wiele rzeczy, a coś wygra
Im więcej szukasz, tym więcej znajdujesz
Wartość p wynosząca 0,05 oznacza, że gdyby w rzeczywistości nie było żadnego efektu, wynik tak silny wystąpiłby z prawdopodobieństwem około 1 na 20 wyłącznie z przypadku. Jest to akceptowalne ryzyko, gdy wykonujesz jeden uczciwy test. Staje się jednak niemal pewnym fałszywie dodatnim wynikiem, gdy wykonujesz dwadzieścia testów.
Porównania wielokrotne: jeśli tablica rozdzielczości (dashboard) dzieli Twoich użytkowników według 20 wymiarów (urządzenie, region, godzina, źródło, poziom planu itp.) i oznacza ten wycinek, który wygląda na „istotny statystycznie”, należy się spodziewać około jednego fałszywego zwycięzcy przy każdym uruchomieniu, nawet gdy nie dzieje się nic realnego. Narzędzie nie kłamie w odniesieniu do żadnego pojedynczego testu. Cicho wykonuje wiele testów i raportuje ten, który wyszedł najkorzystniej z przypadku.
P-hacking to rodzina działań, które sztucznie tworzą istotność statystyczną: próbowanie wielu metryk wyników i raportowanie tej, która przekroczyła próg, dodawanie i usuwanie zmiennych kontrolnych, aż wartość p spadnie, przerywanie zbierania danych w momencie, gdy wyniki wyglądają na istotne, lub dzielenie danych na podgrupy, aż jedna z podgrup „zareaguje”. Żadne z tych działań nie wymaga nieuczciwości; analitycy z motywacją p-hackują, nie zdając sobie z tego sprawy.
Obrona ma charakter strukturalny. Pre-rejestracja: zapisz jedną hipotezę i jedną metrykę przed obejrzeniem danych. Zbiór wstrzymany (holdout): wyodrębnij świeży wycinek danych i potwierdź, że odkrycie przetrwa na danych, które nie miały szansy na selekcję. Korekta: gdy musisz wykonać wiele testów, podnieś poprzeczkę (korekta Bonferroniego, kontrola stopy fałszywych odkryć), aby próg uwzględniał liczbę prób. Odkrycie, które przetrwa na zbiorze wstrzymanym, jest znacznie cenniejsze niż takie, które po prostu przekroczyło 0,05 przy pierwszym podejściu.
Analityk, który znalazł zwycięzcę
Analityk raportuje: „Świetne wieści, odkryliśmy, że nasza kampania e-mailowa znacząco zwiększyła zakupy (p = 0,03) wśród użytkowników korzystających z Androida, w przedziale wiekowym 25–34 lata, którzy otworzyli e-maila po godzinie 20:00”. Prosi o budżet na rozszerzenie kampanii na wszystkich. Dowiadujesz się, że analityk analizował wskaźniki zakupów w podziałach według urządzenia, przedziału wiekowego i pory dnia, zanim wybrał tę konkretną kombinację.
Istotne może wciąż oznaczać znikome
Dwa różne pytania
Istotność statystyczna odpowiada na jedno pytanie: czy ten efekt jest odróżnialny od zera? Wielkość efektu odpowiada na inne: jak duży jest ten efekt? Wynik może być jednocześnie bezwzględnie istotny statystycznie i całkowicie trywialny.
Kluczem jest rozmiar próby. Przy wystarczająco dużej próbie niemal każda różnica staje się statystycznie istotna, ponieważ przedział ufności kurczy się do tego stopnia, że nawet mikroskopijny efekt przestaje dotykać zera. Test na 5 milionach użytkowników może wykazać, że nowy kolor przycisku „istotnie” zwiększa liczbę kliknięć o 0,02%, przy p < 0,0001. Wartość p jest nienaganna. Efekt jest bezwartościowy.
Zatem istotność bez wielkości efektu to tylko połowa zdania. Pytania decydenta brzmią: jak duży jest efekt, czy jest wystarczająco duży, aby mieć znaczenie dla tej decyzji, i czy jego wartość przewyższa jego koszt? Zysk 0,02%, który wymaga projektu inżynieryjnego trwającego sześć miesięcy, nie spełnia kryteriów praktycznych, niezależnie od tego, jak bardzo jest istotny statystycznie.
Należy też odwrócić perspektywę. Duży, obiecujący efekt z szerokim przedziałem ufności (wynikający z testu o niskiej mocy) może być prawdziwą okazją wartą przeprowadzenia większego, odpowiednio dozorowanego badania kontrolnego. Istotność statystyczna i wielkość efektu to dwa niezależne wskaźniki. Odczytuj oba.
Istotne, ale czy warto to wdrożyć?
Twój zespół platformowy przeprowadził rygorystyczny, dobrze dofinansowany eksperyment na 4 milionach sesji. Wynik: „nowy układ ekranu finalizacji zakupów znacząco zwiększa liczbę zakończonych zakupów, p < 0,001. Zysk wynosi +0,05 punktu procentowego (z 4,10% do 4,15% konwersji)”. Wdrożenie układu wymaga dwumiesięcznej przebudowy i skomplikuje bazę kodu. Zespół argumentuje: „jest to statystycznie istotne, więc jesteśmy zobowiązani do wdrożenia”.
Kto to zbierał i czy wynik da się uogólnić?
Skąd wzięły się te liczby?
Zanim zaczniesz analizować wartość p lub przedział ufności, zapytaj, skąd pochodziły dane. Dwa pytania wykonują większość pracy: jaka jest stawka bazowa i czy ta próba da się uogólnić na populację, która Cię interesuje?
Stawki bazowe stanowią punkt odniesienia dla każdej stawki, którą czytasz. Test, który jest „95% dokładny” w wykrywaniu oszustw, brzmi świetnie, dopóki nie zauważysz, że oszustwa występują w 0,1% transakcji: przy tej stawce bazowej zdecydowana większość oznaczonych transakcji to fałszywe alarmy, ponieważ 5% ogromnej uczciwej większości przewyższa 95% małej nieuczciwej mniejszości. Ignorowanie stawki bazowej to sposób, w jaki technicznie dokładny model generuje bezużyteczny, szumny strumień alertów. Zawsze pytaj, jaka jest stawka bazowa, zanim ocenisz wskaźnik wykrywalności lub wskaźnik odpowiedzi.
Pochodzenie danych to łańcuch odpowiedzialności za liczbę. Kto ją zbierał? Jak? Na kim? Ankieta wypełniona przez Twoich najbardziej zaangażowanych użytkowników nie opisuje Twoich użytkowników, którzy odeszli. Wskaźnik konwersji zmierzony podczas świątecznej promocji nie opisuje zwykłego wtorku. Benchmark wykonany przez dostawcę sprzedającego produkt nie jest pomiarem neutralnym. Metoda pobierania próby, czas, narzędzie pomiarowe oraz to, kto zyskuje na wyniku, kształtują to, czy liczba da się uogólnić na Twoją decyzję.
Uogólnianie to ostatnia bariera. Dane zebrane w jednym kontekście (jeden kraj, jeden sezon, jedna klasa klientów, jedno urządzenie) mogą nie przenosić się na inny kontekst. Liczba może być zmierzona idealnie i nadal być błędną liczbą dla Twojego pytania. „Prawda tutaj” i „prawda dla mojej decyzji” to różne twierdzenia.
Studium przypadku na stronie dostawcy
Strona główna dostawcy oprogramowania twierdzi, że „firmy korzystające z naszego narzędzia odnotowały 35% wzrost produktywności”. Ta liczba pochodzi ze studium przypadku trzech firm-klientów, które dostawca wybrał i opisał, mierzonego przez te firmy na podstawie samodzielnego raportowania oszczędzonych godzin, w ciągu pierwszego miesiąca po osobistym, kompleksowym wdrożeniu wykonanym przez własny zespół dostawcy.
Dwuminutowa checklista sceptyka
Przeprowadź to weryfikację dla dowolnego badania, dashboardu lub raportu automatycznego
Masz już pięć odruchów. Oto one w formie listy kontrolnej, którą możesz przejść w mniej niż dwie minuty dla każdego pewnego siebie numeru trafiającego na Twój pulpit.
1. Próba i moc. Jak duża jest próba stojąca za tą liczbą? Czy jest wystarczająco duża, aby wykryć efekt wart podjęcia działań, czy też wystarczająco mała, by wynik mógł się zmienić z powodu kilku obserwacji? Stawka na bardzo małej grupie to w dużej mierze szum.
2. Przedział, a nie punkt. Czy istnieje przedział ufności lub pasek błędu, czy też tylko goły szacunek punktowy? Punkt bez przedziału to sygnał ostrzegawczy. Jeśli porównuje się dwie rzeczy, czy ich przedziały się nakładają? Nakładanie się oznacza, że różnica nie jest ustalona.
3. Ile porównań? Czy był to jeden test zadeklarowany z góry, czy też najszczęśliwszy wycinek z wielu? Zapytaj, ile metryk, segmentów lub wariantów zostało przebadanych. „Istotny” zwycięzca wybrany z przeszukania wymaga świeżego holdoutu lub potwierdzenia zarejestrowanego z góry, zanim mu uwierzysz.
4. Rozmiar efektu a istotność. Odłóż na chwilę wartość p: jak duży jest efekt i czy jest wystarczająco duży, aby mieć znaczenie dla tej decyzji w stosunku do jego kosztu? „Istotny” na ogromnej próbie może nadal być trywialnie mały.
5. Stawka bazowa i pochodzenie. Jaka jest podstawowa stawka bazowa, wobec której ta liczba jest odniesiona? Kto zbierał dane, w jaki sposób, na kim i kto zyskuje na wyniku? Czy kontekst, w którym mierzono, odpowiada decyzji, którą podejmujesz?
Jedno zdanie, które warto wynieść ze sobą: liczba jest twierdzeniem, a nie faktem, dopóki nie zobaczysz jej próby, przedziału, porównań i źródła. Narzędzia będą nadal generować pewne siebie liczby. Twoim zadaniem jest odczytanie czterech rzeczy, których one pomijają.
Zalecana lektura do pogłębienia wiedzy to „Jak kłamać za pomocą statystyki” Darrella Huffa, „Naga statystyka” Charlesa Wheelana, artykuły Reginy Nuzzo na temat p-hackingu oraz wytyczne CONSORT dotyczące czytania metodologii badań.