Das Dashboard zweifelt nicht an sich selbst
Zahlen treffen vorbestimmt ein
Dashboards, A/B-Testing-Tools und automatisierte Analysen treiben heute Entscheidungen im gesamten Handel. Sie liefern Zahlen, die endgültig wirken: „Variante B erhöht die Konversionsrate um 12 %“, „diese Kohorte bricht 3-mal schneller ab“, „die Kampagne erbrachte 4,2-fach“. Die Oberfläche rendert jede dieser Zahlen in selbstbewusster Schrift, ohne Wackeln, ohne Sternchen, ohne Zweifel.
Das Problem ist, dass ein großer Teil dieser Zahlen aus Stichproben stammt, die stark schwanken, aus willkürlich ausgewählten Vergleichen oder aus Tests, die stillschweigend wiederholt wurden, bis etwas eine Schwelle überschritt. Das Tool kennzeichnet keines davon. Es meldet die Zahl und geht weiter.
Ihr Vorteil als Entscheidungsträger besteht nicht darin, die Statistik selbst durchzuführen. Es besteht darin, die Stichprobe, das Intervall, die Vergleiche und die Effektstärke gut genug zu lesen, um zu wissen, welchen selbstbewussten Zahlen Sie vertrauen, welche Sie zurückhalten und welche Sie für weitere Daten zurückgeben sollten.
Diese Lektion behandelt fünf Reflexe: (1) Stichprobenumfang und Rauschen, (2) Konfidenzintervalle und Unsicherheit, (3) P-Hacking und multiple Vergleiche, (4) Effektgröße im Vergleich zur statistischen Signifikanz und (5) Basissätze und Herkunft. Wir schließen mit einer Checkliste ab, die du in unter zwei Minuten auf jede Studie oder jeden Bericht anwenden kannst.
Das A/B-Test-Ergebnis, das sich umkehrte
Ein konkretes Szenario zum Einstieg:
Dein Growth-Team startet am Montag einen A/B-Test. Am Dienstag zeigt das Tool, dass Variante B mit 18 % in Führung liegt, mit einem grünen „signifikant“-Badge, basierend auf 240 Besuchern pro Arm. Das Team möchte B sofort für alle ausrollen. Du bittest sie, den Test laufen zu lassen. Am darauffolgenden Montag, bei 9.000 Besuchern pro Arm, liegt Variante B tatsächlich 1 % hinter A, und das Badge ist verschwunden.
Kleine Stichproben schwanken stark
Statistische Power in einfachen Worten
Jede Messung aus einer Stichprobe ist der wahre Wert plus Rauschen. Je kleiner die Stichprobe, desto größer ist das Rauschen im Verhältnis zum Signal. Das ist kein Mangel, den man im Code umgehen kann. Es ist die Arithmetik des Mittelns weniger Beobachtungen.
Eine nützliche Faustregel: Das Rauschen in einer Schätzung schrumpft mit der Quadratwurzel der Stichprobengröße, nicht mit der Stichprobengröße selbst. Um Ihre Unsicherheit zu halbieren, benötigen Sie viermal so viele Daten. Um sie auf ein Zehntel zu reduzieren, benötigen Sie hundertmal so viele Daten. Deshalb sind frühe Ergebnisse so volatil und das letzte Stück eines Tests fühlt sich langsam an.
Die statistische Power ist die Wahrscheinlichkeit, dass ein Test einen realen Effekt einer bestimmten Größe erkennt, sofern dieser Effekt tatsächlich existiert. Ein unterpowerter Test ist ein Test mit zu wenigen Beobachtungen, um den gesuchten Effekt zuverlässig zu erkennen. Unterpowerter Tests scheitern in zwei Richtungen: Sie übersehen reale Effekte und wenn sie ein „signifikantes“ Ergebnis melden, ist dieses Ergebnis mit höherer Wahrscheinlichkeit eine verrauschte Überschätzung. Dieser zweite Fehler, der übertriebene Gewinner, ist derjenige, der Entscheidungsträger am meisten schadet.
Die praktische Disziplin: Bevor man einen Test durchführt, bestimmt man den kleinsten Effekt, der eine Handlung wert ist, und berechnet dann die benötigte Stichprobengröße, um ihn zu erkennen. Man führt den Test bis zu dieser Größe durch. Man liest nicht schon am ersten Tag die Kaffeesatzlesungen.
Diagnose eines unterpowernden Berichts
Ein automatisierter Bericht landet auf Ihrem Schreibtisch. Er vergleicht die Kündigungsquote (Churn) über 14 Kundensegmente in diesem Quartal. Die Schlagzeile lautet: „Die Kündigungsquote im Segment 7 ist auf 22 % gestiegen, weit über dem Durchschnitt von 9 %, bitte dringend untersuchen.“ Sie sehen sich die Kleingedruckten an. Segment 7 enthält in diesem Quartal 46 Kunden. Im letzten Quartal hatte Segment 7 41 Kunden, als seine Kündigungsquote bei 7 % lag.
Eine Punktschätzung ohne Intervall
Der Balken um den Punkt
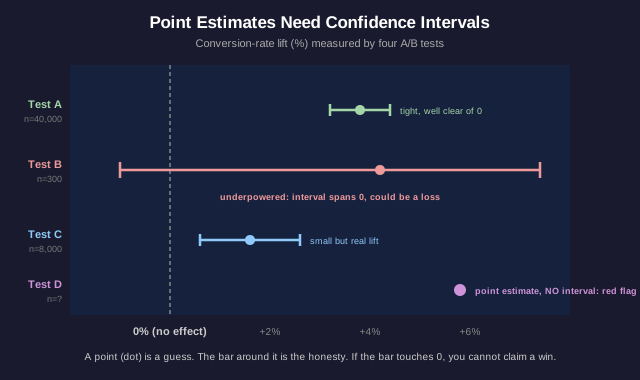
Eine Punktschätzung ist eine einzelne beste Schätzung: Die Steigerung liegt bei 12 %, der Mittelwert bei 4,2, die Kündigungsquote bei 9 %. Ein Konfidenzintervall ist der Bereich, den der wahre Wert angesichts des Rauschens in den Daten plausibel einnimmt: Die Steigerung liegt bei 12 %, plus oder minus 9 %, also plausibel irgendwo zwischen 3 % und 21 %.
Die Punktschätzung ist die Schätzung. Das Intervall ist die Ehrlichkeit. Ein Bericht, der eine Punktschätzung ohne Intervall, ohne Fehlerbalken, ohne Bereich zeigt, versteckt genau die eine Zahl, die du am dringendsten brauchst. Behandle eine nackte Punktschätzung als Warnsignal und nicht als Präzision.
Überlappende Intervalle beinhalten eine spezifische Lektion. Wenn das Intervall von Variante A von 3 % bis 21 % reicht und das Intervall von Variante B von 1 % bis 19 %, überlappen sich diese Bereiche stark. Du kannst nicht behaupten, dass A besser ist als B, da die Daten mit der Möglichkeit vereinbar sind, dass sie gleich sind oder dass B in Führung liegt. Zwei Punktschätzungen können sich unterscheiden, während ihre Intervalle aussagen, dass der Unterschied nur Rauschen ist.
Eine subtilere Falle: Ein breites Intervall, das sich vollständig über null befindet, zeigt, dass der Effekt real ist, aber seine Größe unsicher ist. Ein breites Intervall, das null überschneidet, zeigt, dass man nicht einmal das Vorzeichen kennt. Das erfordert unterschiedliche Entscheidungen. Die Breite des Intervalls ist Information, keine Dekoration.
Zwei sich überlappende Intervalle lesen
Ein Anbieter wirbt für seine Empfehlungsmaschine. Ihre Folie lautet: „Unsere Maschine hat den durchschnittlichen Bestellwert auf 58,40 $ erhöht (95 % KI 54,10 $ bis 62,70 $). Die Kontrollgruppe lag im Durchschnitt bei 55,90 $ (95 % KI 51,30 $ bis 60,50 $).“ Sie schlussfolgern in fetter Schrift: „Ein klarer Gewinn von 2,50 $ pro Bestellung, ausliefern.“
Teste genug Dinge, und etwas wird gewinnen
Je mehr man schaut, desto mehr findet man
Ein p-Wert von 0,05 bedeutet, dass man, wenn es tatsächlich keinen Effekt gäbe, ein Ergebnis dieser Stärke etwa 1 Mal in 20 rein zufällig sehen würde. Das ist ein tragbares Risiko, wenn man einen ehrlichen Test durchführt. Es wird jedoch zu einer fast sicheren Fehlklassifikation (False Positive), wenn man zwanzig Tests durchführt.
Multiple Vergleiche: Wenn ein Dashboard Ihre Nutzer nach 20 Dimensionen (Gerät, Region, Stunde, Referrer, Tarifstufe usw.) aufschlüsselt und welchen Ausschnitt auch immer als „signifikant“ markiert, sollten Sie bei jedem Lauf etwa einen falschen Gewinner erwarten, selbst wenn nichts Reales passiert. Das Tool lügt nicht über einen einzelnen Test. Es führt stillschweigend viele Tests durch und meldet den glücklichsten.
P-Hacking ist die Familie von Vorgehensweisen, die Signifikanz künstlich erzeugen: viele Ergebnismetriken testen und diejenige berichten, die die Schwelle überschritten hat; Kontrollen hinzufügen und entfernen, bis der p-Wert sinkt; die Datenerhebung in dem Moment stoppen, in dem es signifikant aussieht; oder die Daten in Teilgruppen aufteilen, bis eine Teilgruppe „reagiert“. Keines davon erfordert Unehrlichkeit; motivierte Analysten p-hacken, ohne es zu bemerken.
Die Abwehrmaßnahmen sind strukturell. Vorregistrierung: Schreiben Sie die eine Hypothese und die eine Metrik fest, bevor Sie die Daten sehen. Holdout: Reservieren Sie einen frischen Datenausschnitt und bestätigen Sie, dass die Erkenntnis auf Daten übersteht, die keine Chance hatten, selektiv ausgewählt zu werden. Korrektur: Wenn Sie viele Tests durchführen müssen, senken Sie die Latte (Bonferroni, False-Discovery-Rate-Kontrolle), damit die Schwelle die Anzahl der Prüfungen berücksichtigt. Eine Erkenntnis, die einen Holdout übersteht, ist weit mehr wert als eine, die lediglich beim ersten Durchgang 0,05 überschritten hat.
Die Analystin, die einen Gewinner fand
Eine Analystin meldet „großartige Neuigkeiten: Wir haben festgestellt, dass unsere E-Mail-Kampagne die Käufe signifikant gesteigert hat (p = 0,03), und zwar bei Nutzern, die Android verwenden, im Alterssegment 25–34 Jahre und die die E-Mail nach 20 Uhr geöffnet haben“. Sie bittet um ein Budget, um die Kampagne auf alle auszuweiten. Du erfährst, dass die Analystin die Kaufquoten über verschiedene Schnitte nach Gerät, Alterssegment und Tageszeit betrachtet hat, bevor sie auf diese Kombination gestoßen ist.
Signifikant kann immer noch winzig bedeuten
Zwei verschiedene Fragen
Statistische Signifikanz beantwortet eine Frage: Ist dieser Effekt von null unterscheidbar? Die Effektstärke beantwortet eine andere: Wie groß ist der Effekt? Ein Ergebnis kann gleichzeitig erdrückend signifikant und völlig trivial sein.
Der Zusammenhang ist die Stichprobengröße. Mit einer ausreichend großen Stichprobe wird fast jeder Unterschied statistisch signifikant, weil das Intervall schrumpft, bis selbst ein mikroskopisch kleiner Effekt nicht mehr null berührt. Ein Test mit 5 Millionen Nutzern kann berichten, dass eine neue Knopf-Farbe die Klicks „signifikant“ um 0,02 % steigert, mit p < 0,0001. Der p-Wert ist einwandfrei. Der Effekt ist wertlos.
Signifikanz ohne Effektstärke ist daher nur ein halber Satz. Die Fragen der Entscheidungsträger lauten: Wie groß ist der Effekt, ist er groß genug, um für diese Entscheidung relevant zu sein, und übersteigt sein Wert seinen Kosten? Ein Anstieg von 0,02 %, der ein sechswöchiges Ingenieursprojekt erfordert, scheitert aus praktischen Gründen, egal wie signifikant er ist.
Man kann es auch umdrehen. Eine große, vielversprechende Effektstärke mit einem weiten Intervall (aus einem Test mit zu geringer Power) kann eine echte Chance sein, die eine größere, korrekt dimensionierte Folgestudie wert ist. Signifikanz und Effektstärke sind zwei unabhängige Regler. Lies beide ab.
Signifikant, aber lohnenswert für den Launch?
Ihr Plattformteam hat ein rigoroses, gut ausgelegtes Experiment an 4 Millionen Sitzungen durchgeführt. Ergebnis: „Das neue Checkout-Layout erhöht die Anzahl abgeschlossener Käufe signifikant, p < 0,001. Die Steigerung beträgt +0,05 Prozentpunkte (von 4,10 % auf 4,15 % Abschlussquote).“ Die Einführung des Layouts erfordert einen zwei Monate dauernden Neuaufbau und wird den Codebestand komplizierter machen. Das Team argumentiert: „Es ist statistisch signifikant, daher sind wir verpflichtet, es einzuführen.“
Wer hat dies erhoben, und lässt sich das verallgemeinern?
Die Zahlen haben einen Ursprung
Bevor Sie einen p-Wert oder ein Intervall betrachten, fragen Sie, woher die Daten stammen. Zwei Fragen leisten den Großteil der Arbeit: Was ist die Grundrate, und lässt sich diese Stichprobe auf die Population verallgemeinern, die für Sie relevant ist?
Grundraten bilden den Anker für jede Rate, die Sie lesen. Ein Test, der Betrug „zu 95 % genau“ erkennt, klingt hervorragend, bis man feststellt, dass Betrug nur in 0,1 % der Transaktionen auftritt: Bei dieser Grundrate sind die überwiegende Mehrheit der markierten Transaktionen Fehlalarme, da 5 % der riesigen ehrlichen Mehrheit 95 % der winzigen betrügerischen Minderheit in den Schatten stellen. Die Ignorierung der Grundrate ist der Grund, warum ein technisch genaues Modell einen nutzlos verrauschten Alarmstrom erzeugt. Fragen Sie immer, was die zugrunde liegende Rate ist, bevor Sie eine Erkennungsrate oder Reaktionsrate bewerten.
Herkunft ist die Kette der Verwahrung der Zahl. Wer hat sie erhoben? Wie? An wem? Eine Umfrage, die von Ihren engagiertesten Nutzern beantwortet wird, beschreibt nicht Ihre abgewanderten Nutzer. Eine Konversionsrate, die während eines Feiertagsangebots gemessen wird, beschreibt keinen normalen Dienstag. Ein Benchmark, der vom Hersteller des Produkts durchgeführt wird, ist keine neutrale Messung. Die Stichprobenmethode, der Zeitpunkt, das Messinstrument und wer vom Ergebnis profitiert, beeinflussen allesamt, ob sich eine Zahl auf Ihre Entscheidung verallgemeinern lässt.
Verallgemeinerbarkeit ist das letzte Tor. Daten, die in einem Kontext gesammelt wurden (ein Land, eine Saison, eine Kundengruppe, ein Gerät), lassen sich möglicherweise nicht auf einen anderen übertragen. Die Zahl kann perfekt gemessen sein und dennoch die falsche Zahl für Ihre Frage sein. „Hier wahr“ und „wahr für meine Entscheidung“ sind unterschiedliche Behauptungen.
Die Fallstudie auf der Website des Anbieters
Die Landing Page eines Softwareanbieters behauptet: „Unternehmen, die unser Tool nutzen, verzeichneten eine Produktivitätssteigerung von 35 %.“ Die Zahl stammt aus einer Fallstudie von 3 Kundenunternehmen, die der Anbieter auswählte und aufbereitete, gemessen durch die Selbstauskunft dieser Unternehmen über gesparte Stunden, im ersten Monat nach einer persönlichen, umfassenden Einarbeitung durch das eigene Team des Anbieters.
Die Zweiminuten-Skeptiker-Checkliste
Führe dies für jede Studie, jedes Dashboard oder jeden automatisierten Bericht durch
Sie haben nun die fünf Reflexe. Hier sind sie als eine Checkliste, die Sie in unter zwei Minuten auf jede selbstbewusste Zahl anwenden können, die auf Ihrem Schreibtisch landet.
1. Stichprobe und Power. Wie groß ist die Stichprobe hinter dieser Zahl? Ist sie groß genug, um einen Effekt zu erkennen, der eine Handlung wert ist, oder klein genug, um durch eine Handvoll Beobachtungen zu schwanken? Eine Rate auf einer winzigen Gruppe ist größtenteils Rauschen.
2. Intervall, nicht Punkt. Gibt es ein Konfidenzintervall oder einen Fehlerbalken, oder nur eine nackte Punktschätzung? Ein Punkt ohne Intervall ist ein Warnsignal. Wenn zwei Dinge verglichen werden, überlappen sich ihre Intervalle? Überlappung bedeutet, dass der Unterschied nicht gesichert ist.
3. Wie viele Vergleiche? War dies ein vorab deklariertes Test, oder der glücklichste Ausschnitt aus vielen? Fragen Sie, wie viele Metriken, Segmente oder Varianten untersucht wurden. Ein „signifikanter“ Gewinner, der aus einer Suche gezogen wurde, benötigt eine frische Holdout-Gruppe oder eine vorregistrierte Bestätigung, bevor man ihm glaubt.
4. Effektgröße versus Signifikanz. Legen Sie den p-Wert für einen Moment beiseite: Wie groß ist der Effekt, und ist er groß genug, um für diese Entscheidung im Verhältnis zu seinen Kosten von Bedeutung zu sein? „Signifikant“ auf einer riesigen Stichprobe kann immer noch trivial klein sein.
5. Grundrate und Herkunft. Wie hoch ist die zugrunde liegende Grundrate, gegen die diese Zahl gemessen wird? Wer hat die Daten gesammelt, wie, an wem, und wer profitiert vom Ergebnis? Passt der Kontext, in dem gemessen wurde, zur Entscheidung, die Sie treffen?
Ein Satz, den man mitnimmt: Eine Zahl ist eine Behauptung, keine Tatsache, bis man ihre Stichprobe, ihr Intervall, ihre Vergleiche und ihre Herkunft gesehen hat. Die Werkzeuge werden weiterhin selbstbewerte Zahlen ausgeben. Ihre Aufgabe besteht darin, die vier Dinge zu lesen, die sie auslassen.
Empfohlene Lektüre zur Vertiefung sind Darrell Huffs „How to Lie with Statistics“, Charles Wheelans „Naked Statistics“, Regina Nuzzos Schriften zum p-Hacking und die CONSORT-Leitlinien zum Lesen der Methoden einer Studie.