Il dashboard non si mette in discussione
I numeri arrivano già decisi
I dashboard, gli strumenti di test A/B e le analisi automatizzate guidano ora le decisioni in tutto il commercio. Emettono numeri che appaiono definitivi: "la variante B aumenta la conversione del 12%", "questa coorte ha un tasso di abbandono 3 volte più rapido", "la campagna ha restituito 4,2 volte l'investimento". L'interfaccia li rende ciascuno con un carattere sicuro, senza esitazioni, senza asterischi, senza dubbio.
Il problema è che una grande parte di quei numeri proviene da campioni che oscillano violentemente, da confronti selezionati con cura o da test ripetuti silenziosamente finché qualcosa non ha superato una soglia. Lo strumento non segnala nessuno di questi aspetti. Riporta il numero e passa oltre.
Il tuo vantaggio come decisore non è eseguire tu stesso le statistiche. È leggere il campione, l'intervallo, i confronti e la dimensione dell'effetto abbastanza bene da sapere quali numeri rassicuranti fidarsi, quali mettere in attesa e quali rimandare per ulteriori dati.
Questa lezione copre cinque riflessi: (1) dimensione del campione e rumore, (2) intervalli di confidenza e incertezza, (3) p-hacking e confronti multipli, (4) dimensione dell'effetto rispetto alla significatività statistica e (5) tassi di base e provenienza. Concludiamo con un elenco di controllo che puoi eseguire su qualsiasi studio o report in meno di due minuti.
Il risultato A/B che si è ribaltato
Uno scenario concreto per iniziare:
Il tuo team di crescita lancia un test A/B il lunedì. Martedì, lo strumento mostra che la variante B vince con un margine dell'18% e un badge verde "significativo", basato su 240 visitatori per braccio. Il team vuole rilasciare B a tutti immediatamente. Chiedi loro di lasciarlo girare. Il lunedì successivo, con 9.000 visitatori per braccio, la variante B è in realtà l'1% dietro la A, e il badge è scomparso.
I campioni piccoli oscillano in modo selvaggio
Potenza statistica in termini semplici
Ogni misurazione da un campione è il valore vero più il rumore. Più il campione è piccolo, più il rumore è grande rispetto al segnale. Questo non è un difetto che si può aggirare con il codice. È l'aritmetica del mediare un numero inferiore di osservazioni.
Una regola pratica utile: il rumore in una stima diminuisce con la radice quadrata della dimensione del campione, non con la dimensione del campione stessa. Per dimezzare l'incertezza servono quattro volte i dati. Per ridurla a un decimo servono cento volte i dati. Ecco perché i risultati iniziali sono così volatili e perché l'ultimo tratto di un test sembra lento.
La potenza statistica è la probabilità che un test rilevi un effetto reale di una data dimensione, se tale effetto esiste davvero. Un test sotto-potenziato è uno con troppo poche osservazioni per rilevare in modo affidabile l'effetto che sta cercando. I test sotto-potenziati falliscono in due direzioni: non rilevano effetti reali e, quando riportano un risultato "significativo", è più probabile che quel risultato sia una sovrastima rumorosa. Questo secondo fallimento, il vincitore esagerato, è quello che brucia i decisori.
La disciplina pratica: prima di eseguire un test, decidi l'effetto minimo degno di un'azione, poi calcola la dimensione del campione necessaria per rilevarlo. Esegui fino a quella dimensione. Non leggere le foglie di tè al primo giorno.
Diagnosi di un rapporto sotto-potenziato
Un rapporto automatizzato arriva sulla tua scrivania. Confronta il tasso di abbandono (churn) tra 14 segmenti di clienti in questo trimestre. Il titolo recita: "Il churn del Segmento 7 è salito al 22%, molto sopra la media del 9%, indagare urgentemente". Guardi le note a margine. Il Segmento 7 contiene 46 clienti in questo trimestre. Il Segmento 7 aveva 41 clienti nel trimestre scorso, quando il suo churn era del 7%.
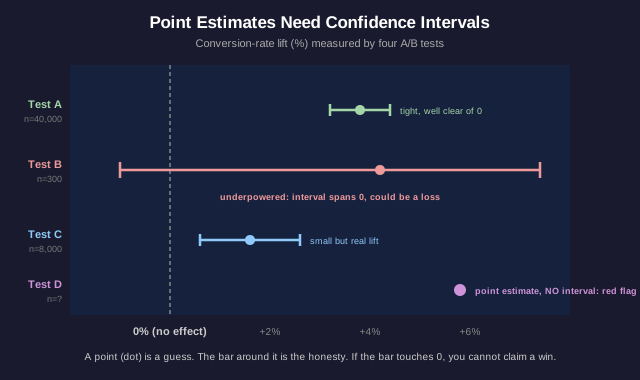
Una stima puntuale senza intervallo
La barra attorno al punto
Una stima puntuale è un singolo numero di migliore approssimazione: il miglioramento (lift) è del 12%, la media è 4,2, l'abbandono è del 9%. Un intervallo di confidenza è l'intervallo di valori che il valore vero occupa plausibilmente, dato il rumore presente nei dati: il miglioramento è del 12%, più o meno 9%, quindi plausibilmente compreso tra il 3% e il 21%.
La stima puntuale è l'ipotesi. L'intervallo è l'onestà. Un report che mostra una stima puntuale senza intervallo, senza barra di errore, senza range, nasconde proprio il numero di cui hai più bisogno. Tratta una stima puntuale "nuda" come un segnale di allarme, non come precisione.
Gli intervalli sovrapposti contengono una lezione specifica. Se l'intervallo della variante A va dal 3% al 21% e l'intervallo della variante B va dall'1% al 19%, quei range si sovrappongono in modo significativo. Non puoi affermare che A supera B, perché i dati sono coerenti con l'ipotesi che siano uguali, o che B sia in vantaggio. Due stime puntuali possono differire, ma i loro intervalli indicano che la differenza è solo rumore.
Un'insidia più sottile: un intervallo ampio che si trova comunque interamente sopra zero ti dice che l'effetto è reale, ma la sua entità è incerta. Un intervallo ampio che attraversa zero ti dice che non conosci nemmeno il segno. Queste situazioni richiedono decisioni diverse. La larghezza dell'intervallo è informazione, non ornamento.
Leggere due intervalli sovrapposti
Un fornitore ti presenta il suo motore di raccomandazioni. La sua slide recita: "Il nostro motore ha portato il valore medio dell'ordine a $58,40 (IC 95% da $54,10 a $62,70). Il gruppo di controllo ha avuto una media di $55,90 (IC 95% da $51,30 a $60,50)." Concludono, in grassetto: "un chiaro vantaggio di $2,50 per ordine, rilasciatelo".
Testa ABBastanza Cose e Qualcosa Vincerà
Più Guardi, Più Trovi
Un valore p di 0,05 significa che, se non ci fosse davvero alcun effetto, vedresti un risultato così forte circa 1 volta su 20 per puro caso. Questo è un rischio accettabile quando si esegue un singolo test onesto. Diventa una quasi certezza di un falso positivo quando si eseguono venti test.
Confronti multipli: se una dashboard segmenta gli utenti in 20 dimensioni (dispositivo, regione, ora, referrer, livello di piano, ecc.) e segnala quale segmento appare "significativo", ci si dovrebbe aspettare circa un falso vincitore per ogni esecuzione, anche quando non sta accadendo nulla di reale. Lo strumento non mente su alcun singolo test. Sta silenziosamente eseguendo molti test e riportando quello più fortunato.
Il P-hacking è la famiglia di mosse che fabbricano la significatività: provare molte metriche di esito e riportare quella che ha superato la soglia, aggiungere e rimuovere controlli finché il valore p non scende, interrompere la raccolta dati nel momento in cui appare significativo, o suddividere i dati in sottogruppi finché un sottogruppo "risponde". Nessuna di queste richiede disonestà; analisti motivati fanno p-hacking senza accorgersene.
Le difese sono strutturali. Pre-registrazione: scrivere l'ipotesi unica e la metrica unica prima di vedere i dati. Un holdout: riservare una fetta fresca di dati e confermare che il risultato resista su dati che non hanno avuto la possibilità di essere selezionati con cura. Correzione: quando si devono eseguire molti test, alzare la soglia (Bonferroni, controllo del tasso di scoperta falsa) in modo che la soglia tenga conto del numero di osservazioni. Un risultato che sopravvive a un holdout vale molto di più di uno che ha semplicemente superato 0,05 al primo passaggio.
L'analista che ha trovato un vincitore
Un analista riferisce: "Ottima notizia, abbiamo scoperto che la nostra campagna email ha aumentato significativamente gli acquisti (p = 0,03) tra gli utenti che utilizzano Android, nella fascia di età 25-34 anni, che hanno aperto l'email dopo le 20:00". Stanno chiedendo un budget per estendere la campagna a tutti. Scopri che l'analista ha esaminato i tassi di acquisto attraverso le suddivisioni per dispositivo, fascia di età e fascia oraria prima di arrivare a questa combinazione.
Significativo può comunque voler dire trascurabile
Due domande diverse
La significatività statistica risponde a una domanda: questo effetto è distinguibile da zero? La dimensione dell'effetto ne risponde a un'altra: quanto è grande l'effetto? Un risultato può essere significativamente evidente e al tempo stesso del tutto banale.
Il collegamento è la dimensione del campione. Con un campione sufficientemente grande, quasi qualsiasi differenza diventa statisticamente significativa, perché l'intervallo si restringe fino a quando anche un effetto microscopico non tocca più lo zero. Un test su 5 milioni di utenti può riportare che un nuovo colore del pulsante "aumenta in modo significativo" i clic dello 0,02%, con p < 0,0001. Il valore p è impeccabile. L'effetto è inutile.
Quindi la significatività senza la dimensione dell'effetto è solo metà di una frase. Le domande di chi deve prendere la decisione sono: quanto è grande l'effetto, è abbastanza grande da contare per questa decisione e il suo valore supera il suo costo? Un aumento dello 0,02% che richiede un progetto ingegneristico di sei mesi fallisce su basi pratiche, indipendentemente da quanto sia statisticamente significativo.
Capovolgendo la prospettiva: una dimensione dell'effetto grande e promettente, ma con un intervallo ampio (derivante da un test con potenza insufficiente), può essere un'opportunità genuina che giustifica un follow-up più ampio e correttamente dimensionato. Significatività e dimensione dell'effetto sono due manopole indipendenti. Leggi entrambe.
Significativo ma degno di essere rilasciato?
Il tuo team di piattaforma ha eseguito un esperimento rigoroso e ben dimensionato su 4 milioni di sessioni. Il risultato: "il nuovo layout del checkout aumenta in modo significativo gli acquisti completati, p < 0,001. Il miglioramento è di +0,05 punti percentuali (dal 4,10% al 4,15% di completamento)". L'implementazione del layout richiede una ricostruzione di due mesi e complicherà la base di codice. Il team sostiene: "è statisticamente significativo, quindi siamo obbligati a rilasciarlo".
Chi ha raccolto questi dati e sono generalizzabili?
I numeri provengono da qualche parte
Prima di considerare qualsiasi valore p o intervallo di confidenza, chiedi da dove provengono i dati. Due domande fanno la maggior parte del lavoro: qual è la frequenza di base (base rate) e questo campione è generalizzabile alla popolazione a cui ti interessa?
Le frequenze di base (base rates) sono il punto di riferimento per ogni tasso che leggi. Un test che è "accurato al 95%" nel rilevare frodi sembra eccellente, finché non si nota che le frodi si verificano nello 0,1% delle transazioni: a quella frequenza di base, la stragrande maggioranza delle transazioni segnalate sono falsi allarmi, perché il 5% della enorme maggioranza di transazioni oneste supera il 95% della minuscola minoranza di transazioni fraudolente. Ignorare la frequenza di base è il modo in cui un modello tecnicamente accurato produce un flusso di avvisi inutilmente rumoroso. Chiedi sempre qual è il tasso sottostante prima di giudicare un numero relativo al tasso di rilevamento o al tasso di risposta.
La provenienza è la catena di custodia del numero. Chi l'ha raccolto? Come? Su chi? Un sondaggio compilato dai tuoi utenti più attivi non descrive i tuoi utenti che hanno disdetto il servizio. Un tasso di conversione misurato durante una promozione festiva non descrive un normale martedì. Un benchmark eseguito dal venditore che vende il prodotto non è una misurazione neutrale. Il metodo di campionamento, il tempismo, lo strumento utilizzato e chi trae vantaggio dal risultato influenzano tutti se un numero è generalizzabile alla tua decisione.
La generalizzazione è l'ultima soglia. I dati raccolti in un contesto (un paese, una stagione, un livello di cliente, un dispositivo) potrebbero non essere trasferibili a un altro. Il numero può essere misurato perfettamente e tuttavia essere il numero sbagliato per la tua domanda. "Vero qui" e "vero per la mia decisione" sono affermazioni diverse.
Il caso di studio sul sito del venditore
La pagina di atterraggio di un venditore di software afferma che "le aziende che utilizzano il nostro strumento hanno visto un aumento della produttività del 35%". Il dato proviene da uno studio di caso su 3 aziende clienti selezionate e redatte dal venditore, misurato dalle ore risparmiate auto-riportate da quelle aziende, nel primo mese dopo un onboarding "white-glove" (di alto livello e personalizzato) eseguito dal team stesso del venditore.
La checklist dello scettico in due minuti
Esegui questo controllo su qualsiasi studio, dashboard o report automatizzato
Ora disponi delle cinque riflessi. Ecco come una checklist che puoi eseguire in meno di due minuti su qualsiasi numero sicuro che arriva sulla tua scrivania.
1. Campione e potenza. Quanto è grande il campione dietro questo numero? È abbastanza grande da rilevare un effetto degno di un'azione, o abbastanza piccolo da oscillare su un pugno di osservazioni? Un tasso su un gruppo minuscolo è per lo più rumore.
2. Intervallo, non punto. C'è un intervallo di confidenza o una barra di errore, o solo una stima puntuale nuda? Un punto senza intervallo è un segnale d'allarme. Se due cose vengono confrontate, i loro intervalli si sovrappongono? La sovrapposizione significa che la differenza non è stabilita.
3. Quante comparazioni? Si è trattato di un singolo test pre-dichiarato, o della fetta più fortunata tra molte? Chiediti quante metriche, segmenti o varianti sono state esaminate. Un vincitore "significativo" estratto da una ricerca ha bisogno di un nuovo holdout o di una conferma pre-registrata prima che tu ci creda.
4. Dimensione dell'effetto rispetto alla significatività. Metti da parte il valore p per un momento: quanto è grande l'effetto e basta per essere rilevante per questa decisione rispetto al suo costo? "Significativo" su un campione enorme può comunque essere banalmente piccolo.
5. Tasso di base e provenienza. Qual è il tasso di base sottostante rispetto al quale si colloca questo numero? Chi ha raccolto i dati, come, su chi e chi trae vantaggio dal risultato? Il contesto in cui è stato misurato corrisponde alla decisione che stai prendendo?
Una frase da portare con te: un numero è un'affermazione, non un fatto, finché non ne hai esaminato il campione, l'intervallo, i confronti e l'origine. Gli strumenti continueranno a produrre cifre sicure. Il tuo compito è leggere le quattro cose che omettono.
Per approfondire, si consiglia la lettura di "How to Lie with Statistics" di Darrell Huff, "Naked Statistics" di Charles Wheelan, gli scritti di Regina Nuzzo sull'uso improprio del valore p (p-hacking) e le linee guida CONSORT sulla lettura dei metodi di uno studio.