Дашборд не сумнівається у собі
Цифри прибувають уже вирішеними
Дашборди, інструменти A/B-тестування та автоматизована аналітика зараз керують рішеннями в сфері комерції. Вони видають цифри, які виглядають остаточними: «варіант B підвищує конверсію на 12%», «цей когорт відпадає в 3 рази швидше», «кампанія принесла 4,2x». Інтерфейс відображає кожну з них впевненим шрифтом, без вагань, без зірочок, без сумнівів.
Проблема в тому, що значна частина цих цифр походить із вибірок, які сильно коливаються, із порівнянь, які були вибрані вибірково, або з тестів, які тихо повторювали, доки щось не перетнуло межу. Інструмент не позначає жодного з цих фактів. Він просто звітує про цифру і переходить далі.
Ваша перевага як особи, що приймає рішення, полягає не у проведенні статистичних обчислень власноруч. Вона полягає у тому, щоб достатньо добре розуміти вибірку, інтервал, порівняння та розмір ефекту, щоб знати, яким впевненим цифрам довіряти, які утримати, а які повернути для отримання додаткових даних.
Цей урок охоплює п'ять рефлексій: (1) розмір вибірки та шум, (2) довірчі інтервали та невизначеність, (3) p-hacking та множественні порівняння, (4) розмір ефекту проти статистичної значущості та (5) базові частоти та походження. Завершуємо ми чек-листом, який можна застосувати до будь-якого дослідження чи звіту менш ніж за дві хвилини.
Результат A/B-тесту, який змінювався на протилежний
Конкретний сценарій для початку:
Ваша команда зростання запускає A/B-тест у понеділок. До вівторка інструмент показує, що варіант B перемагає на 18% із зеленим значком «статистично значущо», на основі 240 відвідувачів у кожній групі. Команда хоче одразу розгорнути B для всіх. Ви просите їх дати тесту працювати далі. До наступного понеділка, при 9 000 відвідувачів у кожній групі, варіант B фактично поступається A на 1%, і значок зник.
Малі вибірки дають значні коливання
Статистична потужність простими словами
Кожне вимірювання з вибірки — це справжнє значення плюс шум. Чим менша вибірка, тим більший шум відносно сигналу. Це не вада, яку можна обійти кодом. Це арифметика усереднення меншої кількості спостережень.
Корисне правило: шум у оцінці зменшується пропорційно до квадратного кореня з розміру вибірки, а не самого розміру вибірки. Щоб зменшити невизначеність вдвічі, потрібні у чотири рази більші дані. Щоб зменшити її в десять разів, потрібні дані, що у сто разів більші. Саме тому ранні результати настільки нестабільні, а фінальний етап тесту здається таким повільним.
Статистична потужність — це ймовірність того, що тест виявить реальний ефект заданого розміру, якщо цей ефект дійсно існує. Непотужний тест — це тест із надто малою кількістю спостережень, щоб надійно побачити ефект, який він шукає. Непотужні тести дають збій у двох напрямках: вони пропускають реальні ефекти, а коли вони все ж повідомляють про «значний» результат, цей результат із більшою ймовірністю є шумним перевищенням. Саме другий тип збою, так звані «перебільшені переможці», завдає найбільшої шкоди прийняттям рішень.
Практична дисципліна: перед запуском тесту визначте найменший ефект, який варто враховувати, а потім обчисліть необхідний розмір вибірки для його виявлення. Дотримуйтесь цього розміру. Не тлумачте знаки долі на перший день.
Діагностика звітності з недостатньою потужністю
На ваш стіл прибуває автоматичний звіт. У ньому порівнюється відтік клієнтів у 14 сегментах цього кварталу. Заголовок стверджує: «Відтік у сегменті 7 стрибнув до 22%, що значно вище середнього показника 9%, терміново розслідувати». Ви дивитесь на дрібний шрифт. У сегменті 7 цього кварталу 46 клієнтів. У сегменті 7 минулого кварталу було 41 клієнт, і тоді відтік становив 7%.
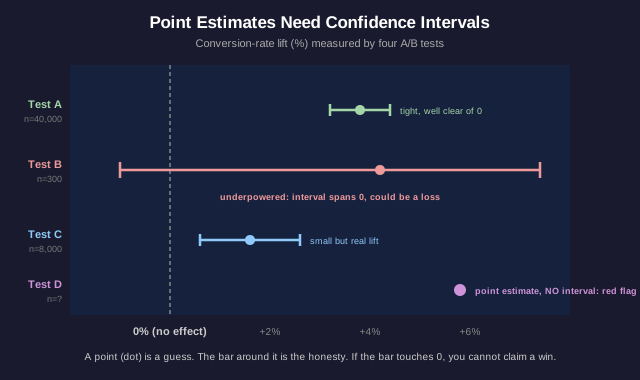
Точкова оцінка без інтервалу
Смуга навколо точки
Точкова оцінка — це одне найкраще припущення: приріст становить 12%, середнє — 4,2, відтік — 9%. Довірчий інтервал — це діапазон, в якому, ймовірно, перебуває справжнє значення з урахуванням шуму в даних: приріст становить 12%, плюс-мінус 9%, тобто, ймовірно, десь від 3% до 21%.
Точкова оцінка — це припущення. Інтервал — це чесність. Звіт, який показує точкову оцінку без інтервалу, без смуги похибки, без діапазону, приховує саме ту цифру, яка вам найбільше потрібна. Вважайте «голу» точкову оцінку червоним прапорцем, а не показником точності.
Перекриваючі інтервали несуть конкретний урок. Якщо інтервал варіанту А становить від 3% до 21%, а інтервал варіанту B — від 1% до 19%, ці діапазони значно перекриваються. Ви не можете стверджувати, що А перевершує B, оскільки дані узгоджуються з тим, що вони рівні, або з тим, що B випереджає. Дві точкові оцінки можуть відрізнятися, тоді як їхні інтервали свідчать, що різниця є шумом.
Більш тонка пастка: широке довірче інтервал, який все одно знаходиться повністю вище нуля, вказує на те, що ефект є реальним, але його розмір є невизначеним. Широке довірче інтервал, що перетинає нуль, вказує на те, що ви навіть не знаєте знака ефекту. Це вимагає різних рішень. Ширина інтервалу є інформацією, а не прикрасою.
Читання двох перекриваючих довірчих інтервалів
Постачальник презентує вам свій рекомендаційний рушій. На їхньому слайді написано: «Наш рушій підвищив середню вартість замовлення до $58.40 (95% ДІ $54.10 до $62.70). Контрольна група мала середню вартість $55.90 (95% ДІ $51.30 до $60.50)». Вони роблять висновок, виділений жирним шрифтом: «чіткий приріст $2.50 на замовлення, впроваджуйте».
Перевірте достатньо речей, і щось переможе
Чим більше шукаєте, тим більше знаходите
P-значення 0,05 означає, що якби ефекту насправді не існувало, ви б побачили результат такої сили приблизно 1 раз на 20 виключно через випадковість. Це прийнятний ризик, коли ви проводите один чесний тест. Але це стає майже гарантованою хибною позитивною оцінкою, коли ви проводите двадцять тестів.
Порівняння багатьох гіпотез: якщо дашборд розбиває ваших користувачів за 20 вимірами (пристрій, регіон, година, посилання, тарифний план тощо) і позначає той зріз, який виглядає «статистично значущим», слід очікувати приблизно одну хибну перемогу за кожний запуск, навіть якщо нічого реального не відбувається. Інструмент не бреше про жоден окремий тест. Він мовчки проводить багато тестів і звітнує про найвдаліший випадок.
P-хакинг — це родина прийомів, які штучно створюють значущість: спроба багатьох метрик результатів та звітність про ту, яка перетнула поріг; додавання та видалення контрольних змінних, доки p-значення не знизиться; зупинка збору даних у момент, коли результат виглядає значущим; або розбиття даних на підгрупи, доки одна підгрупа не «відгукнеться». Жоден із цих прийомів не вимагає нечесності; мотивовані аналітики роблять p-хакинг, навіть не помічаючи цього.
Захисні заходи мають бути структурними. Пререєстрація: зафіксуйте одну гіпотезу та одну метрику до перегляду даних. Тримання частини даних (holdout): виділіть свіжий зріз даних і переконайтеся, що результат зберігається на даних, які не мали можливості бути вибраними вибірково. Корекція: коли ви змушені проводити багато тестів, підвищуйте планку (корекція Бонферроні, контроль частки хибних відкриттів), щоб поріг враховував кількість перевірок. Результат, який витримує перевірку на триманій частині даних, має значно більшу цінність, ніж той, який просто перетнув 0,05 при першій спробі.
Аналітик, який знайшов переможця
Аналітик доповідає: «Чудові новини, ми виявили, що наша email-кампанія значно збільшила покупки (p = 0.03) серед користувачів, які використовують Android, належать до вікової групи 25–34 роки та відкрили email після 20:00». Вони просять бюджет для масштабування кампанії на всіх. Ви дізнаєтесь, що аналітик розглядав показники покупок за різними зрізами: пристрій, вікова група та час доби, перш ніж зупинитися на цій комбінації.
Значущість може означати мізерність
Два різні запитання
Статистична значущість відповідає на одне запитання: чи можна відрізнити цей ефект від нуля? Розмір ефекту відповідає на інше: наскільки великим є ефект? Результат може бути беззаперечно значущим і водночас абсолютно тривіальним.
Зв'язок тут — у розмірі вибірки. З достатньо великою вибіркою майже будь-яка різниця стає статистично значущою, оскільки довірчий інтервал звужується, доки навіть мікроскопічний ефект більше не торкається нуля. Тест на 5 мільйонах користувачів може показати, що новий колір кнопки «значущо» збільшує кліки на 0,02%, при p < 0,0001. p-значення бездоганне. Ефект безцінний.
Тож значущість без розміру ефекту — це лише половина речення. Питання для прийняття рішень такі: наскільки великим є ефект, чи є він достатньо великим, щоб мати значення для цього рішення, і чи перевищує його вартість його вартість? Зростання на 0,02%, яке вимагає шестимісячного інженерного проєкту, програє з практичних міркувань, незалежно від того, наскільки воно значуще.
Переверніть це навпаки. Великий, перспективний розмір ефекту з широким інтервалом (з тесту з недостатньою потужністю) може бути справжньою можливістю, яка потребує більшого, належно потужного повторного дослідження. Значущість і розмір ефекту — це два незалежні регулятори. Чітайте обидва.
Значуще, але варто впроваджувати?
Ваша команда платформи провела ретельний, добре обґрунтований експеримент на 4 мільйонах сесій. Результат: «нове оформлення сторінки оплати значно збільшує кількість завершених покупок, p < 0,001. Зростання становить +0,05 процентного пункту (з 4,10% до 4,15% завершених покупок)». Впровадження цього оформлення потребує двомісячного перебудовування та ускладнить кодову базу. Команда стверджує: «це статистично значущо, тому ми зобов’язані його впровадити».
Хто зібрав ці дані і чи можна їх екстраполювати?
Звідки взялися ці цифри
Перш ніж дивитися на p-значення чи довірчий інтервал, запитайте, звідки взялися дані. Дві запитання виконують більшість роботи: яка базова частота (base rate) і чи можна екстраполювати цю вибірку на цільову популяцію, яка вас цікавить?
Базові частоти є основою для будь-якої частоти, яку ви читаєте. Тест, який «на 95% точно» виявляє шахрайство, звучить чудово, доки ви не помітите, що шахрайство відбувається лише в 0,1% транзакцій: за такої базової частоти більшість позначених транзакцій є хибними справами, оскільки 5% величезної чесної більшості перевищують 95% невеликої шахрайської меншості. Ігнорування базової частоти — це те, як технічно точна модель створює безладний потік тривог. Завжди запитувайте, яка базова частота, перш ніж оцінювати показник виявлення або показник реакції.
Походження (Provenance) — це ланцюжок зберігання цифри. Хто її зібрав? Як? На комусі? Опитування, на яке відповідають ваші найактивніші користувачі, не описує ваших користувачів, які відмовилися від послуг. Показник конверсії, виміряний під час святкової акції, не описує звичайний вівторок. Бенчмарк, проведений постачальником, який продає продукт, не є нейтральним виміром. Метод вибірки, час, інструмент та те, хто виграє від результату, впливають на те, чи можна екстраполювати цифру на ваше рішення.
Екстраполяція (Generalization) — це фінальний бар'єр. Дані, зібрані в одному контексті (одна країна, один сезон, один сегмент клієнтів, одне пристрій), можуть не переноситися на інший. Цифра може бути виміряна ідеально точно, але все одно бути неправильною для вашого питання. «Правда тут» і «правда для мого рішення» — це різні твердження.
Кейс-стаді на сайті постачальника
На головній сторінці програмного постачальника стверджується: «Компанії, які використовують наш інструмент, побачили зростання продуктивності на 35%». Ця цифра походить із кейс-стаді трьох клієнтських компаній, які постачальник обрав і описав, вимірюючи години, збережені за самозвітуванням цих компаній, протягом першого місяця після індивідуального супроводу командою самого постачальника.
Двоххвилинний чек-лист скетика
Застосуйте це до будь-якого дослідження, дашборду або автоматизованого звіту
Тепер у вас є п’ять рефлексів. Ось вони у вигляді чек-листа, який можна виконати менш ніж за дві хвилини для будь-якої впевненої цифри, що потрапляє на ваш стіл.
1. Вибірка та потужність. Який розмір вибірки стоїть за цією цифрою? Чи є вона достатньо великою, щоб виявити ефект, який варто враховувати, чи настільки малою, що може змінитися через кілька спостережень? Частота на малій групі — це переважно шум.
2. Інтервал, а не точка. Чи є довірчий інтервал або смуга похибки, чи лише «голе» точкове оцінка? Точка без інтервалу — це червоний прапорець. Якщо порівнюються дві речі, чи перекриваються їхні інтервали? Перекриття означає, що різниця не є встановленою.
3. Скільки порівнянь? Чи це один заздалегідь визначений тест, чи найвдаліший зріз серед багатьох? Запитайте, скільки метрик, сегментів або варіантів було досліджено. «Значний» переможець, вибраний у результаті пошуку, потребує свіжої контрольної групи або зареєстрованої заздалегідь підтвердження, перш ніж ви в це повірите.
4. Розмір ефекту проти значущості. На хвилину відкладіть p-значення: наскільки великий ефект, і чи є він достатньо великим, щоб мати значення для цього рішення з урахуванням його вартості? «Значний» результат на величезній вибірці може бути тривіально малим.
5. Базова частота та походження. Яка базова частота лежить в основі цієї цифри? Хто збирав дані, як, на комусі і хто виграє від результату? Чи відповідає контекст, у якому проводилися вимірювання, рішенню, яке ви приймаєте?
Одне речення, яке варто забрати з собою: число є твердженням, а не фактом, доки ви не побачили його вибірку, довірчий інтервал, порівняння та джерело походження. Інструменти продовжуватимуть видавати впевнені цифри. Ваше завдання — розуміти чотири речі, які вони опускають.
Рекомендована література для глибшого занурення: «Як брехати за допомогою статистики» Дарелла Хаффа, «Голова без статистики» Чарльза Віллана, статті Реджини Нудзо про p-hacking та рекомендації CONSORT щодо читання методології дослідження.