Dasbor Tidak Meragukan Dirinya Sendiri
Angka Datang Sudah Terputuskan
Dasbor, alat pengujian A/B, dan analitik otomatis kini menggerakkan keputusan di seluruh sektor perdagangan. Mereka mengeluarkan angka yang terlihat final: "varian B meningkatkan konversi 12%", "kohort ini berhenti berlangganan 3x lebih cepat", "kampanye ini menghasilkan pengembalian 4,2x". Antarmuka merender setiap angka dengan tipografi yang percaya diri, tanpa keraguan, tanpa tanda bintang, tanpa keraguan.
Masalahnya adalah bahwa sebagian besar angka tersebut berasal dari sampel yang berfluktuasi liar, dari perbandingan yang dipilih secara selektif, atau dari pengujian yang diulang diam-diam hingga sesuatu melampaui batas tertentu. Alat tersebut tidak menandai hal tersebut. Alat tersebut melaporkan angkanya dan melanjutkan.
Keunggulan Anda sebagai pengambil keputusan bukanlah menjalankan statistiknya sendiri. Melainkan membaca sampel, interval, perbandingan, dan ukuran efek dengan cukup baik untuk mengetahui angka meyakinkan mana yang harus dipercaya, mana yang harus ditahan, dan mana yang harus dikembalikan untuk data lebih lanjut.
Pelajaran ini membahas lima refleks: (1) ukuran sampel dan noise, (2) interval kepercayaan dan ketidakpastian, (3) p-hacking dan perbandingan multipel, (4) ukuran efek versus signifikansi statistik, dan (5) laju dasar dan provenance. Kami menutup dengan checklist yang dapat Anda jalankan terhadap studi atau laporan apa pun dalam waktu kurang dari dua menit.
Hasil A/B yang Terbalik
Skenario konkret untuk pembuka:
Tim growth Anda meluncurkan uji A/B pada hari Senin. Pada hari Selasa, alat tersebut menunjukkan varian B menang dengan selisih 18% dengan lencana "signifikan" berwarna hijau, berdasarkan 240 pengunjung per lengan. Tim ingin segera merilis B ke semua orang. Anda meminta mereka untuk membiarkannya berjalan. Pada Senin berikutnya, dengan 9.000 pengunjung per lengan, varian B ternyata justru 1% di belakang A, dan lencana tersebut hilang.
Sampel Kecil Berfluktuasi Secara Liar
Kekuatan Statistik dalam Istilah Sederhana
Setiap pengukuran dari sampel adalah nilai sebenarnya ditambah kebisingan. Semakin kecil sampelnya, semakin besar kebisingan relatif terhadap sinyal. Ini bukan cacat yang bisa diatasi dengan kode. Ini adalah aritmetika dari merata-ratakan lebih sedikit observasi.
Aturan praktis yang berguna: kebisingan dalam estimasi menyusut seiring akar kuadrat dari ukuran sampel, bukan ukuran sampel itu sendiri. Untuk mengurangi ketidakpastian Anda menjadi setengahnya, Anda membutuhkan empat kali lipat data. Untuk memotongnya menjadi sepersepuluh, Anda membutuhkan seratus kali lipat data. Inilah mengapa hasil awal sangat volatil dan mengapa bagian akhir dari sebuah uji terasa lambat.
Daya statistik (statistical power) adalah probabilitas bahwa suatu uji mendeteksi efek nyata dari ukuran tertentu, jika efek tersebut benar-benar ada. Uji yang kurang bertenaga (underpowered) adalah uji dengan terlalu sedikit observasi untuk secara andal melihat efek yang sedang dicari. Uji yang kurang bertenaga gagal dalam dua arah: mereka melewatkan efek nyata, dan, ketika mereka melaporkan hasil "signifikan", hasil tersebut lebih mungkin menjadi estimasi berlebih yang berisik. Kegagalan kedua ini, pemenang yang dilebih-lebihkan, adalah yang paling merugikan para pengambil keputusan.
Disiplin praktisnya: sebelum menjalankan uji, tentukan efek terkecil yang layak untuk ditindaklanjuti, lalu hitung ukuran sampel yang diperlukan untuk mendeteksinya. Jalankan hingga ukuran tersebut. Jangan membaca tanda-tanda samar pada hari pertama.
Mendiagnosis Laporan yang Kurang Bertenaga
Laporan otomatis tiba di meja Anda. Laporan tersebut membandingkan tingkat churn (pelanggan yang berhenti berlangganan) di antara 14 segmen pelanggan kuartal ini. Judul utamanya berbunyi "Tingkat churn Segmen 7 melonjak menjadi 22%, jauh di atas rata-rata 9%, segera lakukan investigasi." Anda melihat catatan kecilnya. Segmen 7 berisi 46 pelanggan kuartal ini. Segmen 7 memiliki 41 pelanggan kuartal lalu, ketika tingkat churn-nya adalah 7%.
Estimasi Titik Tanpa Interval
Batang di Sekitar Titik
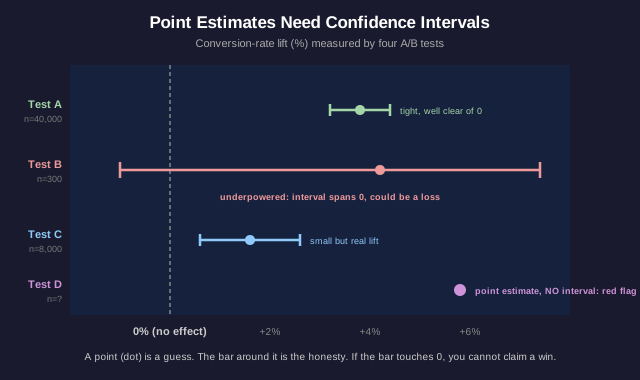
Estimasi titik adalah angka tebakan terbaik tunggal: liftnya 12%, rata-ratanya 4,2, churn-nya 9%. Interval kepercayaan adalah rentang yang secara plausibel ditempati oleh nilai sebenarnya mengingat kebisingan dalam data: liftnya 12%, plus-minus 9%, sehingga secara plausibel berada di mana saja dari 3% hingga 21%.
Estimasi titik adalah tebakannya. Interval adalah kejujurannya. Laporan yang menampilkan estimasi titik tanpa interval, tanpa batang kesalahan, dan tanpa rentang, sedang menyembunyikan satu angka yang paling Anda butuhkan. Perlakukan estimasi titik telanjang sebagai bendera merah, bukan sebagai presisi.
Interval yang tumpang tindih membawa pelajaran spesifik. Jika interval varian A adalah 3% hingga 21% dan interval varian B adalah 1% hingga 19%, rentang tersebut sangat tumpang tindih. Anda tidak dapat mengklaim A mengalahkan B, karena data konsisten dengan kemungkinan mereka sama, atau dengan B yang lebih unggul. Dua estimasi titik dapat berbeda sementara intervalnya menunjukkan bahwa perbedaannya hanyalah kebisingan.
Jebakan yang lebih halus: interval yang lebar tetapi masih berada sepenuhnya di atas nol menunjukkan bahwa efeknya nyata, tetapi ukurannya tidak pasti. Interval yang lebar dan melintasi nol menunjukkan bahwa Anda bahkan tidak mengetahui arahnya. Hal-hal tersebut menuntut keputusan yang berbeda. Lebar interval adalah informasi, bukan sekadar hiasan.
Membaca Dua Interval yang Bertumpuk
Seorang penjual menawarkan mesin rekomendasi mereka. Slide mereka tertulis "Mesin kami menaikkan nilai rata-rata pesanan menjadi $58,40 (IK 95% $54,10 hingga $62,70). Kelompok kontrol memiliki rata-rata $55,90 (IK 95% $51,30 hingga $60,50)." Mereka menyimpulkan, dengan huruf tebal, "keuntungan jelas sebesar $2,50 per pesanan, segera luncurkan."
Uji Banyak Hal dan Sesuatu Akan Menang
Semakin Banyak Anda Mencari, Semakin Banyak yang Anda Temukan
Nilai-p 0,05 berarti bahwa jika sebenarnya tidak ada efek, Anda akan melihat hasil yang sekuat ini sekitar 1 kali dalam 20 hanya karena kebetulan. Itu adalah risiko yang dapat ditoleransi ketika Anda menjalankan satu uji yang jujur. Namun, itu menjadi kepastian hampir pasti untuk positif palsu ketika Anda menjalankan dua puluh uji.
Perbandingan ganda: jika dasbor memotong pengguna Anda berdasarkan 20 dimensi (perangkat, wilayah, jam, referrer, tingkatan paket, dan sebagainya) dan menandai potongan mana pun yang terlihat "signifikan", Anda harus mengharapkan sekitar satu pemenang palsu setiap kali dijalankan bahkan ketika tidak ada yang nyata terjadi. Alat tersebut tidak berbohong tentang satu uji tunggal. Alat itu secara diam-diam menjalankan banyak uji dan melaporkan yang paling beruntung.
P-hacking adalah keluarga dari langkah-langkah yang memanipulasi signifikansi: mencoba banyak metrik hasil dan melaporkan yang satu yang melewati ambang batas, menambahkan dan menghapus kontrol hingga nilai-p turun, menghentikan pengumpulan data sesaat setelah terlihat signifikan, atau memecah data menjadi subkelompok hingga satu subkelompok "berespons". Tidak satu pun dari ini memerlukan kecurangan; analis yang termotivasi melakukan p-hacking tanpa menyadarinya.
Pertahanannya bersifat struktural. Praregistrasi: tulis satu hipotesis dan satu metrik sebelum melihat data. Holdout: sisihkan potongan data baru dan konfirmasi bahwa temuan bertahan pada data yang tidak memiliki kesempatan untuk dipilih secara cherry-picking. Koreksi: ketika Anda harus menjalankan banyak uji, tingkatkan ambang batas (Bonferroni, kontrol tingkat penemuan palsu) sehingga ambang batas memperhitungkan jumlah pengujian. Temuan yang bertahan pada holdout jauh lebih berharga daripada yang sekadar melewati 0,05 pada uji pertama.
Analis yang Menemukan Pemenang
Seorang analis melaporkan "kabar baik, kami menemukan bahwa kampanye email kami secara signifikan meningkatkan pembelian (p = 0.03) di antara pengguna yang menggunakan Android, dalam kelompok usia 25-34 tahun, yang membuka email setelah pukul 8 malam." Mereka meminta anggaran untuk memperluas kampanye ini ke semua orang. Anda mengetahui bahwa analis tersebut telah melihat tingkat pembelian di berbagai irisan perangkat, kelompok usia, dan waktu sebelum akhirnya mendarat pada kombinasi ini.
Signifikan Bisa Saja Berarti Sangat Kecil
Dua Pertanyaan yang Berbeda
Signifikansi statistik menjawab satu pertanyaan: apakah efek ini dapat dibedakan dari nol? Ukuran efek menjawab pertanyaan yang berbeda: seberapa besar efeknya? Sebuah hasil bisa sangat signifikan dan sekaligus sangat tidak berarti pada saat yang sama.
Kuncinya adalah ukuran sampel. Dengan sampel yang cukup besar, hampir semua perbedaan menjadi signifikan secara statistik, karena intervalnya menyempit hingga bahkan efek yang sangat kecil pun tidak lagi menyentuh nol. Pengujian pada 5 juta pengguna dapat melaporkan bahwa warna tombol baru "secara signifikan" meningkatkan klik sebesar 0,02%, dengan p < 0,0001. Nilai p-nya sempurna. Efeknya tidak bernilai.
Jadi, signifikansi tanpa ukuran efek hanyalah setengah kalimat. Pertanyaan pengambil keputusan adalah: seberapa besar efeknya, apakah cukup besar untuk memengaruhi keputusan ini, dan apakah nilainya melebihi biayanya? Peningkatan 0,02% yang membutuhkan proyek rekayasa selama enam bulan gagal secara praktis tidak peduli seberapa signifikan hasilnya.
Pikirkan juga kebalikannya. Ukuran efek yang besar dan menjanjikan dengan interval yang lebar (dari pengujian yang kurang bertenang/underpowered) bisa menjadi peluang nyata yang layak untuk pengujian lanjutan yang lebih besar dan bertenang dengan benar. Signifikansi dan ukuran efek adalah dua pengatur (dial) yang independen. Baca keduanya.
Signifikan tapi Layak Diterapkan?
Tim platform Anda menjalankan eksperimen yang ketat dan bertenaga tinggi pada 4 juta sesi. Hasilnya "layout checkout baru secara signifikan meningkatkan pembelian yang diselesaikan, p < 0.001. Kenaikannya adalah +0,05 poin persentase (dari 4,10% menjadi 4,15% penyelesaian)." Peluncuran layout ini membutuhkan pembangunan ulang selama dua bulan dan akan menyulitkan basis kode. Tim berargumen "ini secara statistik signifikan, jadi kami berkewajiban untuk meluncurkannya."
Siapa yang Mengumpulkan Data Ini, dan Apakah Data Tersebut Dapat Digeneralisasi?
Angka-angka Itu Berasal dari Tempat Tertentu
Sebelum melihat nilai-p atau interval apa pun, tanyakan dari mana data tersebut berasal. Dua pertanyaan ini melakukan sebagian besar pekerjaan: apa saja tingkat dasar (base rate), dan apakah sampel ini dapat digeneralisasi ke populasi yang Anda pedulikan?
Tingkat dasar (base rates) menjadi penjangkar bagi setiap tingkat yang Anda baca. Sebuah tes yang "95% akurat" dalam mendeteksi kecurangan terdengar sangat baik sampai Anda menyadari bahwa kecurangan hanya terjadi pada 0,1% transaksi: pada tingkat dasar tersebut, sebagian besar transaksi yang ditandai adalah alarm palsu, karena 5% dari mayoritas transaksi jujur yang sangat besar melampaui 95% dari minoritas transaksi curang yang sangat kecil. Mengabaikan tingkat dasar adalah cara di mana model yang secara teknis akurat menghasilkan aliran peringatan yang sangat berisik dan tidak berguna. Selalu tanyakan apa tingkat dasarnya sebelum menilai angka tingkat deteksi atau tingkat respons.
Provenance (asal-usul) adalah rantai kepemilikan angka tersebut. Siapa yang mengumpulkannya? Bagaimana caranya? Pada siapa? Survei yang dijawab oleh pengguna Anda yang paling antusias tidak menggambarkan pengguna Anda yang berhenti berlangganan. Tingkat konversi yang diukur selama promosi liburan tidak menggambarkan hari Selasa biasa. Benchmark yang dijalankan oleh vendor yang menjual produk tersebut bukanlah pengukuran yang netral. Metode pengambilan sampel, waktu, instrumen, dan siapa yang diuntungkan dari hasil semuanya memengaruhi apakah sebuah angka dapat digeneralisasi ke keputusan Anda.
Generalisasi adalah gerbang terakhir. Data yang dikumpulkan dalam satu konteks (satu negara, satu musim, satu tingkat pelanggan, satu perangkat) mungkin tidak dapat ditransfer ke konteks lain. Angka tersebut dapat diukur dengan sempurna dan tetap menjadi angka yang salah untuk pertanyaan Anda. "Benar di sini" dan "benar untuk keputusan saya" adalah klaim yang berbeda.
Studi Kasus di Situs Vendor
Halaman pendaratan (landing page) vendor perangkat lunak mengklaim "perusahaan yang menggunakan alat kami melihat peningkatan produktivitas sebesar 35%". Angka tersebut berasal dari studi kasus 3 perusahaan klien yang dipilih dan ditulis oleh vendor, diukur oleh perusahaan-perusahaan tersebut melalui pelaporan mandiri tentang jam yang dihemat, selama bulan pertama setelah onboarding white-glove yang dilakukan langsung oleh tim vendor sendiri.
Daftar Periksa Skeptis Dua Menit
Jalankan Ini untuk Setiap Studi, Dasbor, atau Laporan Otomatis
Kini Anda memiliki lima refleks. Berikut ini sebagai daftar periksa yang dapat Anda jalankan dalam waktu kurang dari dua menit terhadap angka yang penuh keyakinan yang tiba di meja Anda.
1. Sampel dan kekuatan. Seberapa besar sampel di balik angka ini? Apakah cukup besar untuk mendeteksi efek yang layak ditindaklanjuti, atau cukup kecil sehingga bisa berubah hanya karena segelintir pengamatan? Tingkat pada kelompok kecil sebagian besar hanyalah noise.
2. Interval, bukan titik. Apakah ada interval kepercayaan atau batang kesalahan, atau hanya estimasi titik telanjang? Titik tanpa interval adalah tanda bahaya. Jika dua hal dibandingkan, apakah interval mereka tumpang tindih? Tumpang tindih berarti perbedaan tidak terbukti.
3. Berapa banyak perbandingan? Apakah ini satu uji yang dinyatakan sebelumnya, atau potongan paling beruntung dari banyak? Tanyakan berapa banyak metrik, segmen, atau varian yang diperiksa. Pemenang "signifikan" yang diambil dari pencarian memerlukan holdout baru atau konfirmasi pra-didaftarkan sebelum Anda mempercayainya.
4. Ukuran efek versus signifikansi. Sampingkan nilai-p untuk sejenak: seberapa besar efeknya, dan apakah cukup besar untuk penting bagi keputusan ini terhadap biayanya? "Signifikan" pada sampel yang sangat besar masih bisa sangat kecil.
5. Tingkat dasar dan asal. Apa tingkat dasar yang mendasari angka ini? Siapa yang mengumpulkan data, bagaimana, pada siapa, dan siapa yang diuntungkan oleh hasilnya? Apakah konteks tempat diukur cocok dengan keputusan yang Anda buat?
Satu kalimat untuk dibawa pulang: sebuah angka adalah klaim, bukan fakta, sampai Anda telah melihat sampelnya, intervalnya, perbandingannya, dan asalnya. Alat-alat akan terus mengeluarkan angka-angka yang terdengar percaya diri. Tugas Anda adalah membaca empat hal yang mereka abaikan.
Bacaan yang direkomendasikan untuk mendalami topik ini adalah "How to Lie with Statistics" karya Darrell Huff, "Naked Statistics" karya Charles Wheelan, tulisan Regina Nuzzo tentang p-hacking, dan panduan CONSORT tentang cara membaca metode sebuah studi.