O Painel Não Se Duvida a Si Mesmo
Números Chegam Pré-Decididos
Painéis de controle, ferramentas de testes A/B e análises automatizadas agora impulsionam decisões em todo o comércio. Eles emitem números que parecem finais: "a variante B aumenta a conversão em 12%", "este grupo tem churn 3x mais rápido", "a campanha retornou 4,2x". A interface renderiza cada um em uma tipografia confiante, sem vacilação, sem asterisco, sem dúvida.
O problema é que uma grande parte desses números vem de amostras que oscilam violentamente, de comparações que foram escolhidas a dedo ou de testes que foram repetidos silenciosamente até algo cruzar uma linha. A ferramenta não sinaliza nada disso. Ela reporta o número e segue em frente.
Sua vantagem como tomador de decisão não é executar as estatísticas você mesmo. É ler a amostra, o intervalo, as comparações e o tamanho do efeito bem o suficiente para saber quais números confiantes confiar, quais segurar e quais devolver para mais dados.
Esta lição aborda cinco reflexos: (1) tamanho da amostra e ruído, (2) intervalos de confiança e incerteza, (3) p-hacking e comparações múltiplas, (4) tamanho do efeito versus significância estatística e (5) taxas de base e proveniência. Concluímos com uma lista de verificação que você pode executar contra qualquer estudo ou relatório em menos de dois minutos.
O Resultado do A/B que se Reverteu
Um cenário concreto para começar:
Sua equipe de crescimento lança um teste A/B na segunda-feira. Na terça-feira, a ferramenta mostra que a variante B está vencendo por 18% com um selo verde de "significativo", com base em 240 visitantes por braço. A equipe quer lançar a variante B para todos imediatamente. Você pede que deixem o teste rodar. Na segunda-feira seguinte, com 9.000 visitantes por braço, a variante B está, na verdade, 1% atrás da A, e o selo desapareceu.
Amostras Pequenas Variam Bruscamente
Potência Estatística em Termos Simples
Toda medição de uma amostra é o valor verdadeiro mais ruído. Quanto menor a amostra, maior o ruído em relação ao sinal. Isso não é um defeito que se pode contornar com código. É a aritmética de fazer a média de menos observações.
Uma regra prática útil: o ruído em uma estimativa diminui com a raiz quadrada do tamanho da amostra, não com o tamanho da amostra em si. Para reduzir sua incerteza pela metade, você precisa de quatro vezes mais dados. Para reduzi-la a um décimo, você precisa de cem vezes mais dados. É por isso que os resultados iniciais são tão voláteis e por que o último trecho de um teste parece lento.
O poder estatístico é a probabilidade de um teste detectar um efeito real de um determinado tamanho, caso esse efeito realmente exista. Um teste subdimensionado é aquele com poucas observações para detectar de forma confiável o efeito que está procurando. Testes subdimensionados falham em duas direções: eles perdem efeitos reais e, quando relatam um resultado "significativo", esse resultado é mais provável de ser uma superestimativa ruidosa. Esta segunda falha, o vencedor exagerado, é a que queima os tomadores de decisão.
A disciplina prática: antes de executar um teste, decida o menor efeito que vale a pena ser considerado e, em seguida, calcule o tamanho da amostra necessário para detectá-lo. Execute até esse tamanho. Não tente interpretar sinais vagos no primeiro dia.
Diagnosticando um Relatório Subdimensionado
Um relatório automatizado chega à sua mesa. Ele compara a taxa de cancelamento (churn) em 14 segmentos de clientes neste trimestre. O destaque diz: "A taxa de cancelamento do Segmento 7 saltou para 22%, muito acima da média de 9%, investigar urgentemente". Você olha para as notas de rodapé. O Segmento 7 contém 46 clientes neste trimestre. O Segmento 7 tinha 41 clientes no trimestre anterior, quando sua taxa de cancelamento era de 7%.
Uma Estimativa Pontual Sem Intervalo
A Barra ao Redor do Ponto
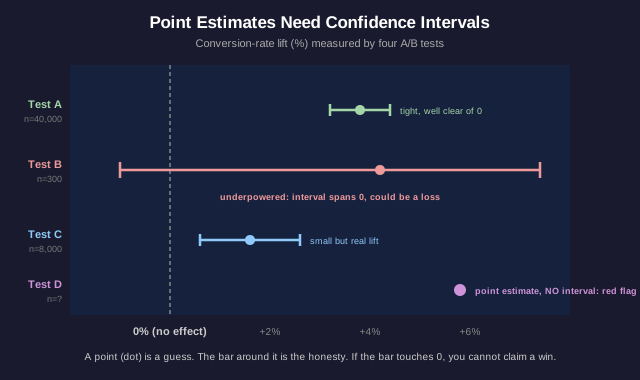
Uma estimativa pontual é um único número de melhor suposição: o aumento é de 12%, a média é 4,2, o cancelamento é 9%. Um intervalo de confiança é a faixa que o valor verdadeiro ocupa plausivelmente, dado o ruído nos dados: o aumento é de 12%, mais ou menos 9%, portanto plausivelmente em qualquer lugar entre 3% e 21%.
A estimativa pontual é a suposição. O intervalo é a honestidade. Um relatório que mostra uma estimativa pontual sem intervalo, sem barra de erro, sem faixa, está escondendo o número de que você mais precisa. Trate uma estimativa pontual nua como um sinal de alerta, e não como precisão.
Intervalos sobrepostos carregam uma lição específica. Se o intervalo da variante A é de 3% a 21% e o intervalo da variante B é de 1% a 19%, essas faixas se sobrepõem fortemente. Você não pode afirmar que A supera B, porque os dados são consistentes com eles serem iguais, ou com B estar à frente. Duas estimativas pontuais podem diferir enquanto seus intervalos indicam que a diferença é ruído.
Uma armadilha mais sutil: um intervalo amplo que ainda se situa inteiramente acima de zero indica que o efeito é real, mas seu tamanho é incerto. Um intervalo amplo que cruza o zero indica que você nem mesmo sabe o sinal. Isso exige decisões diferentes. A largura do intervalo é informação, não decoração.
Lendo Dois Intervalos Sobrepostos
Um fornecedor apresenta a você seu mecanismo de recomendação. O slide deles diz: "Nosso mecanismo aumentou o valor médio do pedido para $58,40 (IC de 95% de $54,10 a $62,70). O grupo de controle teve uma média de $55,90 (IC de 95% de $51,30 a $60,50)." Eles concluem, em negrito: "uma vitória clara de $2,50 por pedido, publique."
Teste Coisas Suficientes e Algo Vencerá
Quanto Mais Você Procura, Mais Você Encontra
Um valor-p de 0,05 significa que, se não houvesse realmente nenhum efeito, você veria um resultado tão forte cerca de 1 vez em 20 por puro acaso. Esse é um risco tolerável quando você executa um único teste honesto. Torna-se uma quase certeza de um falso positivo quando você executa vinte.
Comparações múltiplas: se um painel de controle divide seus usuários em 20 dimensões (dispositivo, região, hora, referenciador, nível do plano, etc.) e destaca qual fatia parece "significativa", você deve esperar cerca de um falso vencedor a cada execução, mesmo quando nada real está acontecendo. A ferramenta não está mentindo sobre nenhum teste individual. Ela está executando silenciosamente muitos testes e relatando o mais sortudo.
P-hacking é a família de manobras que fabricam significância: tentar muitas métricas de resultado e relatar a única que cruzou a linha, adicionar e remover controles até o valor-p diminuir, interromper a coleta de dados no momento em que parece significativo, ou dividir os dados em subgrupos até que um subgrupo "responda". Nenhuma dessas ações exige desonestidade; analistas motivados praticam p-hacking sem perceber.
As defesas são estruturais. Pré-registro: escreva a única hipótese e a única métrica antes de ver os dados. Um conjunto de retenção (holdout): reserve uma fatia nova de dados e confirme que a descoberta sobrevive em dados que não tiveram chance de ser escolhidos a dedo. Correção: quando você precisa executar muitos testes, eleve o padrão (Bonferroni, controle da taxa de descoberta falsa) para que o limiar leve em conta o número de verificações. Uma descoberta que sobrevive a um conjunto de retenção vale muito mais do que uma que meramente cruzou 0,05 na primeira tentativa.
O Analista que Encontrou um Vencedor
Um analista relata "grandes notícias, descobrimos que nossa campanha de e-mail aumentou significativamente as compras (p = 0,03) entre usuários que estão no Android, na faixa etária de 25-34 anos, que abriram o e-mail após as 20h". Eles estão pedindo orçamento para escalar a campanha para todos. Você descobre que o analista analisou as taxas de compra em fatias de dispositivo, faixa etária e horário antes de chegar a essa combinação.
Significativo Ainda Pode Significar Mínimo
Duas Perguntas Diferentes
Significância estatística responde a uma pergunta: este efeito é distinguível de zero? Tamanho do efeito responde a outra: quão grande é o efeito? Um resultado pode ser ressoantemente significativo e absolutamente trivial ao mesmo tempo.
O elo é o tamanho da amostra. Com uma amostra grande o suficiente, quase qualquer diferença se torna estatisticamente significativa, porque o intervalo se estreita até que até mesmo um efeito microscópico não toque mais em zero. Um teste com 5 milhões de usuários pode relatar que uma nova cor de botão "aumenta significativamente" os cliques em 0,02%, com p < 0,0001. O valor de p é impecável. O efeito é inútil.
Portanto, significância sem tamanho do efeito é apenas metade de uma frase. As perguntas do tomador de decisão são: quão grande é o efeito, é grande o suficiente para importar para esta decisão, e seu valor excede seu custo? Um aumento de 0,02% que requer um projeto de engenharia de seis meses falha em termos práticos, não importa quão significativo seja.
Inverta também. Um tamanho de efeito grande e promissor com um intervalo amplo (de um teste subdimensionado) pode ser uma oportunidade genuína que vale a pena um acompanhamento maior e adequadamente dimensionado. Significância e tamanho do efeito são dois controles independentes. Leia ambos.
Significativo, mas Vale a Pena Lançar?
Sua equipe de plataforma executou um experimento rigoroso e bem dimensionado em 4 milhões de sessões. O resultado: "o novo layout de checkout aumenta significativamente as compras concluídas, p < 0,001. O aumento é de +0,05 pontos percentuais (de 4,10% para 4,15% de conclusão)". A implementação do layout requer uma reconstrução de dois meses e complicará a base de código. A equipe argumenta que "é estatisticamente significativo, portanto, somos obrigados a lançá-lo".
Quem coletou isso e isso se generaliza?
Os números vieram de algum lugar
Antes de qualquer valor-p ou intervalo, pergunte de onde vieram os dados. Duas perguntas fazem a maior parte do trabalho: qual é a taxa base e esta amostra se generaliza para a população que lhe interessa?
Taxas base ancoram cada taxa que você lê. Um teste que é "95% preciso" na detecção de fraude soa excelente até você notar que a fraude ocorre em 0,1% das transações: com essa taxa base, a grande maioria das transações sinalizadas são falsos alarmes, porque 5% da enorme maioria honesta supera 95% da pequena minoria fraudulenta. Ignorar a taxa base é como um modelo tecnicamente preciso produz um fluxo de alertas inutilizável e ruidoso. Sempre pergunte qual é a taxa subjacente antes de julgar um número de taxa de detecção ou taxa de resposta.
Proveniência é a cadeia de custódia do número. Quem o coletou? Como? Em quem? Uma pesquisa respondida pelos seus usuários mais engajados não descreve seus usuários que cancelaram o serviço. Uma taxa de conversão medida durante uma promoção de feriado não descreve uma terça-feira normal. Um benchmark executado pelo vendedor que vende o produto não é uma medição neutra. O método de amostragem, o momento, o instrumento e quem se beneficia do resultado moldam se um número se generaliza para a sua decisão.
Generalização é a última etapa. Dados coletados em um contexto (um país, uma estação, uma camada de cliente, um dispositivo) podem não se transferir para outro. O número pode ser perfeitamente medido e ainda assim ser o número errado para a sua pergunta. "Verdadeiro aqui" e "verdadeiro para a minha decisão" são afirmações diferentes.
O estudo de caso no site do fornecedor
A página inicial de um fornecedor de software afirma que "empresas que usam nossa ferramenta viram um aumento de 35% na produtividade". O número vem de um estudo de caso de 3 empresas clientes que o fornecedor selecionou e redigiu, medido por essas empresas relatando por conta própria as horas economizadas, durante o primeiro mês após uma implantação com suporte personalizado pela própria equipe do fornecedor.
A Lista de Verificação do Cético de Dois Minutos
Aplique Isso a Qualquer Estudo, Painel ou Relatório Automatizado
Agora você tem os cinco reflexos. Aqui estão eles como uma lista de verificação que você pode executar em menos de dois minutos contra qualquer número confiante que chegue à sua mesa.
1. Amostragem e poder. Qual é o tamanho da amostra por trás deste número? É grande o suficiente para detectar um efeito que justifique uma ação, ou pequeno o suficiente para oscilar com uma pequena quantidade de observações? Uma taxa em um grupo minúsculo é principalmente ruído.
2. Intervalo, não ponto. Existe um intervalo de confiança ou barra de erro, ou apenas uma estimativa pontual nua? Um ponto sem intervalo é um sinal de alerta. Se duas coisas são comparadas, seus intervalos se sobrepõem? Sobreposição significa que a diferença não está estabelecida.
3. Quantas comparações? Este foi um único teste pré-declarado, ou a fatia mais sortuda entre muitas? Pergunte quantas métricas, segmentos ou variantes foram examinados. Um vencedor "significativo" extraído de uma busca precisa de um novo grupo de controle ou confirmação pré-registrada antes que você acredite nele.
4. Tamanho do efeito versus significância. Deixar o valor-p de lado por um momento: qual é o tamanho do efeito e ele é grande o suficiente para importar para esta decisão em relação ao seu custo? "Significativo" em uma amostra enorme ainda pode ser trivialmente pequeno.
5. Taxa base e procedência. Qual é a taxa base subjacente contra a qual este número se posiciona? Quem coletou os dados, como, em quem e quem se beneficia do resultado? O contexto em que foi medido corresponde à decisão que você está tomando?
Uma frase para levar na saída: um número é uma alegação, não um fato, até que você tenha visto sua amostra, seu intervalo, suas comparações e sua origem. As ferramentas continuarão emitindo números confiantes. Seu trabalho é ler as quatro coisas que elas deixam de fora.
Leitura recomendada para aprofundar o tema: "Como Mentir com Estatística" de Darrell Huff, "Estatística Desnuda" de Charles Wheelan, os escritos de Regina Nuzzo sobre p-hacking e as diretrizes CONSORT sobre a leitura dos métodos de um estudo.