ダッシュボードは自らを疑わない
数字は事前に決まって届く
現在、ダッシュボード、A/Bテストツール、自動分析が小売業界全体の意思決定を駆動している。それらは最終的なように見える数字を出力する:「バリアントBでコンバージョンが12%向上」「このコホートは3倍速く離脱する」「キャンペーンは4.2倍のリターンを生んだ」。インターフェースはそれらを自信に満ちたフォントで表示し、揺れも、アスタリスクも、疑いも示さない。
問題は、これらの数字の多くが、激しく変動するサンプル、 cherry-picked(都合よく選ばれた)比較、あるいは何かが閾値を超すまで静かに繰り返されたテストから来ていることだ。ツールはそれらのいずれもフラグ(警告)しない。数字を報告して、そのまま次へ進むだけだ。
意思決定者としてのあなたの優位性は、統計を自分で実行することではない。サンプル、区間、比較、効果量を十分に読み解き、どの自信に満ちた数字を信頼し、どの数字を保留し、どの数字をさらなるデータのために差し戻すべきかを知ることにある。
このレッスンでは、5つのリフレックス(再考の視点)を扱います:(1) サンプルサイズとノイズ、(2) 信頼区間と不確実性、(3) pハッキングと多重比較、(4) 効果量と統計的有意性、(5) ベースレートと出所。最後に、あらゆる研究やレポートに対して2分以内で実行できるチェックリストで締めくくります。
逆転したA/Bテストの結果
導入のための具体的なシナリオです:
グロースチームが月曜日にA/Bテストを開始しました。火曜日には、ツールが1アームあたり240人の訪問者に基づき、バリアントBが18%リードし、緑色の「有意」バッジを表示していました。チームはすぐにBを全員に展開したいと考えています。あなたは、テストを継続するよう求めました。翌週月曜日、1アームあたり9,000人の訪問者になった時点で、バリアントBは実際にはAに1%遅れており、バッジは消えていました。
小規模なサンプルは激しく変動する
平易な言葉で統計的検定力を説明する
サンプルからのすべての測定値は、真の値にノイズが加わったものです。サンプルが小さいほど、シグナルに対するノイズの割合は大きくなります。これはコードで回避できる欠陥ではありません。より少ない観測値を平均化する際の算術上の必然です。
有用な目安として、推定値のノイズはサンプルサイズ自体ではなく、サンプルサイズの平方根に比例して縮小します。不確実性を半分に減らすには4倍のデータが必要で、10分の1にするには100倍のデータが必要です。これが初期の結果が非常に変動しやすく、テストの最後の区間が遅く感じられる理由です。
統計的検出力(Statistical power)とは、ある効果が実際に存在する場合、その特定の大きさの効果をテストが検出できる確率のことです。検出力が低い(underpowered)テストとは、探している効果を確実に検出するために必要な観測数が不足しているテストを指します。検出力の低いテストは2つの方向で失敗します。1つは実際の効果を逃すこと、もう1つは「有意」な結果を報告した際に、その結果がノイズの多い過大評価である可能性が高くなることです。この2番目の失敗、すなわち「誇張された勝者(exaggerated winner)」こそが、意思決定者を最も困らせるものです。
実践的な規律とは、テストを実行する前に、行動を起こす価値のある最小の効果を決定し、それを検出するために必要なサンプルサイズを計算することです。そのサイズまで実行してください。1日目の結果から意味を読み取ろうとしないでください。
検出力の低いレポートの診断
自動生成されたレポートがあなたのデスクに届きました。今四半期の14の顧客セグメント間の解約率(churn)を比較しています。見出しには「セグメント7の解約率が22%に急上昇し、平均の9%を大きく上回っている。緊急に調査すること」と書かれています。詳細を確認すると、今四半期のセグメント7には46人の顧客が含まれています。先四半期には41人の顧客がおり、その時の解約率は7%でした。
区間なしの点推定
点の周りのバー
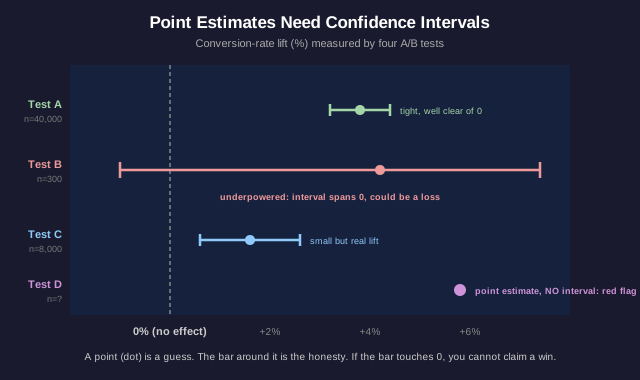
点推定とは、単一の最良の推定値である:リフト(向上率)が12%、平均が4.2、解約率が9%などだ。信頼区間とは、データ中のノイズ(ばらつき)を考慮した上で、真の値が妥当に存在しうる範囲である:リフトは12%だが、プラスマイナス9%なので、妥当な範囲は3%から21%の間どこかだ。
点推定は推測であり、区間は誠実さである。点推定のみを表示し、信頼区間も誤差バーも範囲も示さないレポートは、最も必要とする1つの数値を隠している。区間なしの点推定は、精度の証ではなく、赤信号(警告)として扱うべきだ。
重なり合う信頼区間には、特定の教訓が含まれている。バリアントAの区間が3%から21%で、バリアントBの区間が1%から19%の場合、これらの範囲は大きく重なる。データが両者が等しいこと、あるいはBが先行していることと整合的であるため、「AがBを上回っている」と主張することはできない。2つの点推定値が異なっても、その差がノイズに過ぎないことを信頼区間が示している場合がある。
より微妙な罠:ゼロより完全に上にある広い区間(信頼区間)は、効果が実在するがその大きさが不確実であることを示す。一方、ゼロをまたぐ広い区間は、符号(正負)すら不明であることを示す。これらは異なる意思決定を要する。区間の幅は装飾ではなく、情報である。
重なり合う2つの信頼区間の読み方
あるベンダーがレコメンドエンジンを提案してきた。スライドには「当社のエンジンは平均注文単価を58.40ドルに引き上げました(95%信頼区間:54.10ドル〜62.70ドル)。対照群の平均は55.90ドルでした(95%信頼区間:51.30ドル〜60.50ドル)」と記載されている。彼らは太字で「1注文あたり2.50ドルの明確な勝利、リリースせよ」と結論づけている。
十分に多くのものをテストすれば、何かは必ず勝つ
見るほど、見つかる
p値が0.05であるということは、実際に効果がない場合、純粋な偶然によってこの程度の強さの結果が見られる確率が約20分の1であることを意味します。1回の誠実なテストを行う場合、これは許容できるリスクです。しかし、20回実行すれば、偽陽性がほぼ確実なものになります。
多重比較:ダッシュボードがユーザーを20の次元(デバイス、地域、時間帯、リファラー、プランティアなど)でスライスし、「有意」に見えるスライスをフラグ付けする場合、何の実質的な変化も起きていない場合でも、実行ごとに約1つの偽の勝者が出ることを期待すべきです。ツールは個々のテストについて嘘をついていません。多くのテストを黙って実行し、最も運の良かったものを報告しているだけです。
Pハッキングとは、有意性を製造するための一連の手法です:多くの結果指標を試して基準を超えたものを報告すること、p値が低下するまで制御変数を追加・削除すること、有意に見える瞬間にデータ収集を停止すること、あるサブグループが「反応する」までデータをサブグループに分割することです。これらには不正行為は必要ありません。動機づけられたアナリストは、気づかずにPハッキングを行います。
防御策は構造的なものです。事前登録:データを見る前に、1つの仮説と1つの指標を文書化します。ホールドアウト:新しいデータのスライスを確保し、チェリーピッキングの機会がなかったデータ上で発見が持続することを確認します。補正:多くのテストを実行しなければならない場合、バーを上げ(ボンフェローニ補正、偽発見率の制御など)、閾値が試行回数を考慮するようにします。ホールドアウトで生存した発見は、初回で0.05を単に超えたものに比べてはるかに価値があります。
勝者を見つけたアナリスト
アナリストが「素晴らしいニュースです。Androidユーザーで、25〜34歳の年齢層、かつ午後8時以降にメールを開いたユーザーにおいて、メールキャンペーンが購入を有意に増加させたことが分かりました(p = 0.03)」と報告してきました。彼らはキャンペーンを全員に拡大するための予算を要求しています。あなたは、アナリストがこの組み合わせにたどり着く前に、デバイス、年齢層、時間帯のスライスごとに購入率を確認していたことを知りました。
「有意」でも、実質的には微小な場合がある
2つの異なる問い
統計的有意性が答えるのは1つの問いです。この効果はゼロと区別できるか?一方、効果量が答えるのは別の問いです。その効果はどれほど大きいのか?ある結果が、統計的に極めて有意でありながら、実質的には全く重要でない場合もあります。
その鍵はサンプルサイズです。サンプルサイズが十分に大きければ、ほぼすべての差が統計的に有意になります。信頼区間が狭くなり、微小な効果であってもゼロと重ならなくなるためです。500万人のユーザーを対象としたテストでは、新しいボタンの色がクリック率を0.02%「有意に」向上させたと報告され、p < 0.0001となるかもしれません。p値は完璧です。しかし、その効果は無価値です。
したがって、効果量なしの有意性は、文の半分しか語っていません。意思決定者が問うべきことは、効果はどれほど大きく、その決定にとって重要であるほど大きいのか、そしてその価値はコストを上回るのか、ということです。6ヶ月間のエンジニアリングプロジェクトを要する0.02%の向上は、統計的にどれほど有意であっても、実務的な観点から失敗です。
逆もまた然りです。広い信頼区間(パワー不足のテストによる)を持つ、大きく有望な効果量は、より大きく、適切にパワーを持たせたフォローアップ調査に値する真の機会かもしれません。有意性と効果量は2つの独立したダイヤルです。両方を読み解きましょう。
有意だが、リリースする価値はあるか?
あなたのプラットフォームチームは、400万セッションを対象に厳密で統計的検出力の高い実験を実施しました。結果は「新しいチェックアウトレイアウトは完了した購入を有意に増加させる、p < 0.001。上昇幅は+0.05ポイント(完了率が4.10%から4.15%に上昇)」。このレイアウトのリリースには2ヶ月の再構築が必要であり、コードベースを複雑にする。チームは「統計的に有意であるため、リリースする義務がある」と主張している。
このデータは誰が収集したのか、そして一般化できるのか?
数値はどこから来たのか
p値や信頼区間を見る前に、データの出所を問うべきです。多くの場合、2つの質問が大半の仕事をしてくれます。それは「ベースレート(基礎発生率)は何か?」そして「このサンプルは、あなたが気にしている母集団に一般化できるか?」ということです。
ベースレートは、あなたが読むあらゆる率の基準点です。不正行為を検出するテストが「95%の精度」で機能すると聞けば素晴らしいように思えますが、不正行為は取引の0.1%しか発生しないことを考慮すると話は変わります。そのベースレートでは、フラグが付けられた取引の大部分は誤検知です。なぜなら、膨大な数の誠実な取引の5%は、わずかな不正行為の95%を圧倒するからです。ベースレートを無視することは、技術的には正確なモデルが、実用的には無用なほどノイズの多いアラートストリームを生み出す原因になります。検出率や反応率の数値を評価する前に、常にその背後にある基礎発生率が何かを問いましょう。
プロベナンス(出所)とは、数値の管理責任の連鎖です。誰が収集したのか?どのように?誰に対して?最もエンゲージメントの高いユーザーが回答したアンケートは、離脱したユーザーを説明しません。ホリデーセール期間中に測定したコンバージョン率は、通常の火曜日を説明しません。製品を販売するベンダー自身が実行したベンチマークテストは、中立な測定ではありません。サンプリング手法、タイミング、測定機器、そして結果から利益を得る主体はすべて、その数値があなたの意思決定に一般化できるかどうかを左右します。
一般化は最終的な関門です。ある文脈(ある国、ある季節、ある顧客層、あるデバイス)で収集されたデータは、別の文脈に移行できない可能性があります。数値が完璧に測定されていても、あなたの問いに対する間違った数値である可能性があります。「ここでは真実である」と「私の意思決定に対して真実である」は、異なる主張です。
ベンダーのサイトにあるケーススタディ
あるソフトウェアベンダーのランディングページには、「当社のツールを使用している企業は生産性が35%向上した」と主張されています。この数値は、ベンダーが選定し執筆した3社のクライアント企業を対象としたケーススタディから来ています。測定方法は、ベンダー自身のチームによる手厚いホワイトグローブ・オンボーディング(導入支援)後の最初の1ヶ月間において、それらの企業が自己申告で報告した節約時間に基づいています。
2分で終わる懐疑者のチェックリスト
どの研究、ダッシュボード、または自動レポートにもこれを実行してください
これで5つの反射が揃いました。以下は、デスクに届いた自信満々な数字に対して、2分以内で実行できるチェックリストです。
1. サンプルと検出力。 この数字の背後にあるサンプルサイズはどれくらいですか?行動する価値のある効果を検出するのに十分な大きさですか、それとも少数の観察で結果が大きく揺れるほど小さいですか?ごく小さな集団の割合は、主にノイズです。
2. 区間、点推定値ではない。 信頼区間や誤差範囲は示されていますか、それとも裸の点推定値だけですか?区間のない点推定値は危険信号です。2つの事象を比較する場合、それらの区間は重なっていますか?重なりがある場合、差は確立されていません。
3. 比較の回数。 これは事前に宣言された1回のテストですか、それとも多くの比較の中から偶然選ばれた最も幸運なスライスですか?何つの指標、セグメント、またはバリアントが検討されたかを尋ねてください。検索の中から引き出された「有意な」勝者は、信じる前に新しいホールドアウトまたは事前登録された確認が必要です。
4. 効果量と有意性。 p値を一旦脇に置いておきます:効果はどれくらい大きく、そのコストに対してこの決定において重要であるほど大きいですか?巨大なサンプルでの「有意」であっても、依然として無視できるほど小さい可能性があります。
5. ベースレートと出所。 この数字が基づいている根本的なベースレートは何ですか?データは誰が、どのように、誰に対して収集しましたか、そして結果から誰が利益を得ますか?測定された文脈は、あなたが下そうとしている決定と一致していますか?
教室を出る際に心に刻んでほしい一文:数字は、そのサンプル、区間、比較、そして出所を確認するまでは、事実ではなく単なる主張に過ぎない。 ツールは自信満々な数値を次々と出力し続けるだろう。あなたの役目は、それらが省く4つの要素を読み解くことである。
さらに深く学ぶための推奨読書として、ダレル・ハフの『統計でうそをつく』、チャールズ・ウィーランの『裸の統計学』、レジーナ・ヌッツォによるpハッキングに関する著作、そして研究手法を読むためのCONSORTガイドラインを挙げる。