დეშბორდი საკუთარ თავს არ ეჭვობს
რიცხვები უკვე გადაწყვეტილები მოდის
დეშბორდები, A/B ტესტირების ინსტრუმენტები და ავტომატური ანალიტიკა დღეს უკვე კომერციაში გადაწყვეტილებებს განსაზღვრავს. ისინი გამოყოფენ რიცხვებს, რომლებიც საბოლოოდ გამოიყურება: „ვარიანტი B-მ კონვერსია 12%-ით გაზარდა“, „ეს კოჰორტა 3-ჯერ უფრო სწრაფად ტოვებს“, „კამპანიამ 4.2-ჯერ დააბრუნა“. ინტერფეისი თითოეულ მათგანს თავდაჯერებული შრიფტით აჩვენებს — არც კანკალი, არც ვარსკვლავი, არც ეჭვი.
პრობლემა ის არის, რომ ამ რიცხვების დიდი ნაწილი მოდის ნიმუშებიდან, რომლებიც ძალიან ძლიერ მერყეობენ, შედარებებიდან, რომლებიც ხელოვნურადაა შერჩეული, ან ტესტებიდან, რომლებიც მშვიდად იმეორებოდა მანამ, სანამ რაღაც არ გადაკვეთდა ზღვარს. ინსტრუმენტი ამაზე არაფერს არ აფრთხილებს. უბრალოდ აჩვენებს რიცხვს და გადადის შემდეგზე.
გადაწყვეტილების მიმღები ადამიანის უპირატესობა არა სტატისტიკის თვითონ გაშვებაა. უპირატესობა არის ნიმუშის, ინტერვალის, შედარებებისა და ეფექტის ზომის იმდენად კარგად წაკითხვა, რომ გაარკვიო რომელ თავდაჯერებულ რიცხვებს ენდო, რომელებს შეაჩერო და რომელებს დააბრუნო დამატებითი მონაცემებისთვის.
ეს გაკვეთილი მოიცავს ხუთ ძირითად რეფლექსს: (1) სემპლის ზომა და ხმაური, (2) სანდოობის ინტერვალები და გაურკვევლობა, (3) p-hacking და მრავალჯერადი შედარებები, (4) ეფექტის ზომა სტატისტიკურ მნიშვნელობასთან შედარებით, და (5) ბაზური მაჩვენებლები და წარმომავლობა. დასასრულს გთავაზობთ ჩეკლისტს, რომელიც ნებისმიერ კვლევას ან ანგარიშს ორ წუთში შეგიძლიათ გაუშვათ.
A/B ტესტის შედეგი, რომელიც საპირისპიროდ შეიცვალა
კონკრეტული სცენარი დასაწყისისთვის:
თქვენი გუნდი ორშაბათს აწყობს A/B ტესტს. სამშაბათისთვის ინსტრუმენტი აჩვენებს, რომ ვარიანტი B 18%-ით იგებს და აქვს მწვანე „მნიშვნელოვანი“ ბეჯი, დაფუძნებული 240 ვიზიტორზე თითოეულ ჯგუფში. გუნდი უნდა გაავრცელოს B ყველასთვის დაუყოვნებლივ. თქვენ სთხოვთ, რომ ტესტი გააგრძელონ. მომდევნო ორშაბათს, 9000 ვიზიტორზე თითოეულ ჯგუფში, ვარიანტი B უკვე 1%-ით ჩამორჩება A-ს, და ბეჯი გაქრა.
პატარა სამპლები ძალიან ძლიერ მერყეობენ
სტატისტიკური ძალა ჩვეულებრივი ენით
ნებისმიერი გაზომვა სამპლიდან არის ნამდვილი მნიშვნელობა პლუს ხმაური. რაც უფრო მცირეა სამპლი, მით უფრო დიდია ხმაური სიგნალთან შედარებით. ეს არ არის ის ხარვეზი, რომელსაც კოდით შემოვუარებთ. ეს არის საშუალოს გამოთვლის არითმეტიკა ნაკლები დაკვირვებით.
სასარგებლო წესი: შეფასებაში არსებული ხმაური მცირდება სამპლის ზომის კვადრატული ფესვით, და არა თავად ზომით. რომ ორჯერ შეამცირო გაურკვევლობა, გჭირდება ოთხჯერ მეტი მონაცემები. რომ შეამცირო მეათედამდე, გჭირდება ასჯერ მეტი მონაცემები. სწორედ ამიტომაა ადრეული შედეგები ასე არასტაბილური და სწორედ ამიტომ ჩანს ტესტის ბოლო მონაკვეთი ასე ნელი.
სტატისტიკური ძალა არის ალბათობა, რომ ტესტი აღმოაჩენს რეალურ ეფექტს მოცემული ზომით, თუ ეს ეფექტი მართლაც არსებობს. ნაკლებად ძლიერი (underpowered) ტესტი არის ის, რომელშიც ძალიან 적ი დაკვირვებაა, რათა საიმედოდ დაინახოს ის ეფექტი, რომლის მოძებნაც ცდილობს. ნაკლებად ძლიერი ტესტები ორი მიმართულებით მარცხდებიან: ისინი ვერ პოულობენ რეალურ ეფექტებს და, როდესაც მაინც აცხადებენ „სტატისტიკურად მნიშვნელოვან“ შედეგს, ეს შედეგი უფრო ხშირად არის ხმაურიანი გადაჭარბებული შეფასება. ეს მეორე წარუმატებლობა — გაზვიადებული გამარჯვებული — არის ის, რაც გადაწყვეტილების მიმღებებს ყველაზე მეტად აზარალებს.
პრაქტიკული დისციპლინა: ტესტის გაშვებამდე გადაწყვიტე ყველაზე მცირე ეფექტი, რომლის გამო ღირს მოქმედება, შემდეგ გამოთვალე საჭირო სამპლის ზომა მის აღმოსაჩენად. გაუშვი ტესტი ამ ზომამდე. არ წაიკითხო ჩაის ნალექი პირველ დღეს.
ნაკლებად ძლიერი ანგარიშის დიაგნოსტიკა
შენს მაგიდაზე ავტომატური ანგარიში ეცემა. იგი ადარებს მომხმარებელთა ჩამოყრის (churn) მაჩვენებელს 14 სეგმენტში ამ კვარტალში. სათაური ამბობს: „7-ე სეგმენტში churn გაიზარდა 22%-მდე, რაც ბევრად აღემატება საშუალო 9%-ს, გადაუდებლად შეისწავლეთ.“ შენ უყურებ წვრილ ბეჭდვას. 7-ე სეგმენტში ამ კვარტალში 46 მომხმარებელია. 7-ე სეგმენტში გასულ კვარტალში 41 მომხმარებელი იყო, როდესაც მისი churn 7% იყო.
წერტილოვანი შეფასება ინტერვალის გარეშე
წერტილის გარშემო არსებული ზოლი
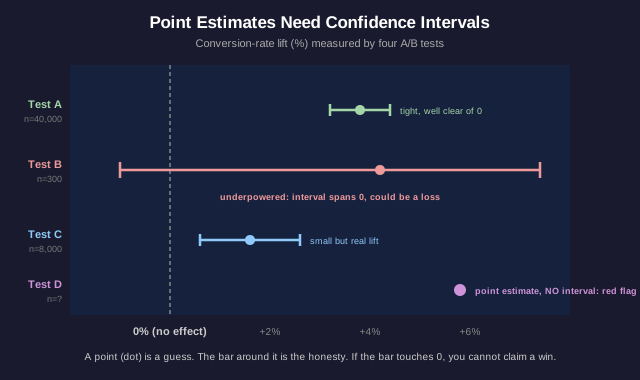
წერტილოვანი შეფასება (point estimate) არის ერთი საუკეთესო გამოცნობა: ზრდა 12%, საშუალო 4.2, churn 9%. ნდობის ინტერვალი კი არის დიაპაზონი, რომელშიც ნამდვილი მნიშვნელობა სავარაუდოდ მდებარეობს მონაცემებში არსებული ხმაურის გათვალისწინებით: ზრდა 12% ± 9%, ანუ სავარაუდოდ 3%-დან 21%-მდე.
წერტილოვანი შეფასება არის გამოცნობა. ინტერვალი კი — გულწრფელობა. ანგარიში, რომელიც აჩვენებს მხოლოდ წერტილოვან შეფასებას ინტერვალის, შეცდომის ზოლის ან დიაპაზონის გარეშე, მალავს ყველაზე მნიშვნელოვან რიცხვს. შიშველი წერტილოვანი შეფასება აღიქმება როგორც წითელი დროშა, და არა როგორც სიზუსტე.
გადამკვეთი ინტერვალები გვასწავლიან კონკრეტულ გაკვეთილს. თუ ვარიანტ A-ს ინტერვალია 3%-დან 21%-მდე, ხოლო ვარიანტ B-ს ინტერვალია 1%-დან 19%-მდე, ეს დიაპაზონები ერთმანეთს მნიშვნელოვნად ემთხვევა. თქვენ ვერ იტყვით, რომ A ცოდნით უკეთესია ვიდრე B, რადგან მონაცემები თანხმებაშია იმასთან, რომ ისინი თანაბარი არიან, ან რომ B წინ უსწრებს. ორი წერტილოვანი შეფასება შეიძლება განსხვავდებოდეს ერთმანეთისგან, მაგრამ მათი ინტერვალები ამბობენ, რომ სხვაობა ხმაურია. --- All placeholders, formatting, and structure preserved.
უფრო დახვეწილი ხაფანგი: ფართო ინტერვალი, რომელიც მთლიანად ნულის ზემოთ მდებარეობს, გვეუბნება, რომ ეფექტი რეალურია, მაგრამ მისი ზომა გაურკვეველია. ფართო ინტერვალი, რომელიც ნულს კვეთს, გვეუბნება, რომ ნიშნის (ხელმოწერის) მიმართულებაც კი არ ვიცით. ეს ორი სიტუაცია სხვადასხვა გადაწყვეტილებას მოითხოვს. ინტერვალის სიგანე არის ინფორმაცია, და არა დეკორაცია.
ორი გადამჭრელი ინტერვალის წაკითხვა
გამყიდველი გთავაზობთ თავის რეკომენდაციების ძრავას. მის სლაიდზე წერია: „ჩვენმა ძრავამ საშუალო შეკვეთის ღირებულება $58.40-მდე ასწია (95% CI $54.10-დან $62.70-მდე). კონტროლმა საშუალოდ $55.90 შეადგინა (95% CI $51.30-დან $60.50-მდე)“. ისინი სქელი შრიფტით ასკვნიან: „თითო შეკვეთაზე ნათელი $2.50-იანი მოგება, გავუშვათ“.
საკმარისი რაოდენობის ტესტირება და რაღაც მაინც იგებს
რაც უფრო მეტს უყურებ, მით უფრო მეტს პოულობ
p-მნიშვნელობა 0.05 ნიშნავს, რომ თუ სინამდვილეში ეფექტი არ არსებობდა, ასეთი ძლიერი შედეგი შანსის წესით დაახლოებით 1-ჯერ გამოჩნდებოდა 20-ში. ეს მისაღები რისკია, როცა ერთ გულწრფელ ტესტს ატარებ. ის კი თითქმის გარდუუვალ ცრუ დადებით შედეგად იქცევა, როცა ოც ტესტს ატარებ.
მრავალჯერადი შედარებები: თუ დეშბორდი თქვენს მომხმარებლებს 20 განზომილებით ჭრის (მოწყობილობა, რეგიონი, საათი, რეფერერი, ტარიფის დონე და ა.შ.) და აფრთხილებს იმ „სეგმენტს“, რომელიც „სტატისტიკურად მნიშვნელოვანად“ გამოიყურება, მაშინ თითოეული გაშვებისას უნდა ელოდოთ დაახლოებით ერთ ცრუ გამარჯვებას, თუნდაც სინამდვილეში არაფერი ხდებოდეს. ინსტრუმენტი არ ტყუის არცერთ კონკრეტულ ტესტზე. ის უბრალოდ ჩუმად ატარებს ბევრ ტესტს და აჩვენებს ყველაზე გაუმართლებულს.
P-ჰაკინგი არის იმ მანევრების soukრება, რომლებიც ხელოვნურად ქმნიან სტატისტიკურ მნიშვნელოვნებას: სხვადასხვა შედეგის მეტრიკის გამოცდა და მხოლოდ იმის არჩევა, რომელიც ზღვარს გადაკვეთს; კონტროლების დამატება-ამოღება მანამ, სანამ p-მნიშვნელობა არ დაეცემა; მონაცემების შეგროვების შეწყვეტა იმ მომენტში, როცა შედეგი მნიშვნელოვანად გამოიყურება; ან მონაცემების ქვეჯგუფებად დაყოფა მანამ, სანამ ერთ-ერთი „პასუხს“ არ მისცემს. არცერთი მათგანი არ საჭიროებს პირდაპირ ტყუილს; მოტივირებული ანალიტიკოსები p-ჰაკინგს ხშირად შეუმჩნევლად აკეთებენ.
დაცვის მექანიზმები სტრუქტურულია. წინასწარი რეგისტრაცია: ჩაწერეთ ერთი ჰიპოთეზა და ერთი მეტრიკა მონაცემების ნახვამდე. ჰოლდაუტი: დატოვეთ სუფთა, ახალი მონაცემების ნაწილი და შეამოწმეთ, რომ დასკვნა გადარჩება მონაცემებზე, რომლებიც ვერანაირად ვერ იქნებოდა „აკრეფილი“. კორექცია: როცა ბევრ ტესტს ატარებთ, ასწიეთ ზღვარი (ბონფერონი, false-discovery-rate კონტროლი), რომ ზღუდი გაითვალისწინოს გაკეთებული შეხედვების რაოდენობას. დასკვნა, რომელიც ჰოლდაუტზე გადარჩება, ბევრად უფრო ღირებულია, ვიდრე ის, რომელიც პირველივე გაშვებაზე უბრალოდ 0.05-ს გადაკვეთა.
ანალიტიკოსი, რომელმაც გამარჯვებული იპოვა
ანალიტიკოსი აცხადებს „კარგი ამბავი, ჩვენ აღმოვაჩინეთ, რომ ჩვენმა ელფოსტის კამპანიამ მნიშვნელოვნად გაზარდა შესყიდვები (p = 0.03) Android-ის მომხმარებლებში, 25-34 წლის ასაკობრივ ჯგუფში, რომლებმაც ელფოსტა 20:00 საათის შემდეგ გახსნეს“. ისინი ბიუჯეტს ითხოვენ, რომ კამპანია ყველასთვის გააფართოვონ. თქვენ გაიგეთ, რომ ანალიტიკოსმა შესყიდვების მაჩვენებლები გადახედა მოწყობილობის, ასაკობრივი ჯგუფისა და დღის დროის სხვადასხვა ჭრილებში, სანამ ამ კომბინაციაზე „დაეშვა“.
მნიშვნელოვანი შეიძლება მაინც მცირე იყოს
ორი განსხვავებული კითხვა
სტატისტიკური მნიშვნელოვნება პასუხობს ერთ კითხვას: გამოირჩევა თუ არა ეს ეფექტი ნულისგან? ეფექტის ზომა კი სხვა კითხვას პასუხობს: რამდენად დიდია ეფექტი? შედეგი შეიძლება იყოს მკაფიოდ სტატისტიკურად მნიშვნელოვანი და ამავდროულად სრულიად უმნიშვნელო.
კავშირი ნიმუშის ზომაშია. საკმარისად დიდი ნიმუშით თითქმის ნებისმიერი სხვაობა ხდება სტატისტიკურად მნიშვნელოვანი, რადგან ინტერვალი იკუმშება მანამ, სანამ მიკროსკოპული ეფექტიც კი აღარ ეხება ნულს. 5 მილიონიანი მომხმარებლის ტესტმა შეიძლება აჩვენოს, რომ ახალმა ღილაკის ფერმა „მნიშვნელოვნად“ გაზარდა კლიკები 0.02%-ით, p < 0.0001-ით. p-value უნაკლოა. ეფექტი კი უსარგებლო.
ამიტომ მნიშვნელოვნება ეფექტის ზომის გარეშე მხოლოდ ნახევარი წინადადებაა. გადაწყვეტილების მიმღების კითხვებია: რამდენად დიდია ეფექტი, საკმარისად დიდია თუ არა იგი ამ გადაწყვეტილებისთვის და ღირს თუ არა მისი ღირებულება ხარჯზე მეტი? 0.02%-იანი ზრდა, რომელიც ექვსთვიან ინჟინერულ პროექტს მოითხოვს, პრაქტიკულად ჩავარდნილია, მიუხედავად იმისა, რამდენად მნიშვნელოვანია იგი სტატისტიკურად.
შეუქციეთ კიდეც. დიდი, პერსპექტიული ეფექტის ზომა ფართო ინტერვალით (უმძლავრო ტესტიდან) შეიძლება იყოს ნამდვილი შესაძლებლობა, რომელიც ღირს უფრო დიდი, სათანადოდ გაძლიერებული შემდგომი კვლევის ჩატარებას. სტატისტიკური მნიშვნელოვნება და ეფექტის ზომა ორი დამოუკიდებელი საზომია. ორივე წაიკითხეთ.
მნიშვნელოვანია, მაგრამ ღირს თუ არა გაშვება?
თქვენი პლატფორმის გუნდმა ჩაატარა მკაცრი, კარგად გაჯერებული ექსპერიმენტი 4 მილიონ სესიაზე. შედეგი: „ახალი გადახდის განლაგება მნიშვნელოვნად ზრდის დასრულებულ შესყიდვებს, p < 0.001. ზრდა შეადგენს +0.05 პროცენტულ პუნქტს (4.10%-დან 4.15%-მდე).“ ამ განლაგების გაშვება მოითხოვს ორთვიან რებილდს და გაართულებს კოდბაზას. გუნდი ამტკიცებს: „ეს სტატისტიკურად მნიშვნელოვანია, ამიტომ ჩვენ ვალდებულნი ვართ გავშვათ.“
ვინ შეაგროვა ეს და გადატანადია თუ არა?
რიცხვები სადღაც მოვიდა
ნებისმიერ p-value-ს ან ინტერვალამდე, ჯერ იკითხე, საიდან მოდის მონაცემები. ორი კითხვა აკეთებს დიდ საქმეს: რა არის საბაზისო მაჩვენებელი (base rate) და გადატანადია თუ არა ეს ნიმუში იმ პოპულაციაზე, რომელიც შენთვის მნიშვნელოვანია?
საბაზისო მაჩვენებლები (Base rates) აყალიბებს საფუძველს ყველა მაჩვენებლისთვის, რომელსაც კითხულობ. ტესტი, რომელიც „95%-ით ზუსტია“ თაღლითობის აღმოჩენაში, შესანიშნავად � звучаს, სანამ არ გაიგებ, რომ თაღლითობა ხდება ტრანზაქციების მხოლოდ 0.1%-ში. ამ საბაზისო მაჩვენებელთან ერთად დროში აღმოჩენილი ტრანზაქციების უმრავლესობა ცრუ განგაშია, რადგან 5% უზარმაზარი პატიოსანი უმრავლესობისა ბევრად აღემატება 95%-ს მცირე თაღლითური ჯგუფისა. საბაზისო მაჩვენებლის იგნორირებაა ის, თუ როგორ ქმნის ტექნიკურად სწორი მოდელი უსარგებლოდ ხმაურიან განგაშთა ნაკადს. ყოველთვის იკითხე, რა არის საფუძვლად არსებული მაჩვენებელი, სანამ შეაფასებ აღმოჩენის ან რეაგირების მაჩვენებელს.
წარმომავლობა (Provenance) არის რიცხვის „მფლობელობის ჯაჭვი“. ვინ შეაგროვა? როგორ? ვისზე? გამოკითხვა, რომელიც შენი ყველაზე აქტიური მომხმარებლების მიერაა შევსებული, არ აღწერს იმ მომხმარებლებს, რომლებიც გამოიწვევენ. კონვერსიის მაჩვენებელი, გაზომილი სადღესასწაულო აქციის დროს, არ აღწერს ჩვეულებრივ სამშაბათს. ბენჩმარკი, რომელიც პროდუქტის გაყიდვით დაინტერესებული გამყიდველის მიერაა ჩატარებული, არ არის ნეიტრალური გაზომვა. ნიმუშის არჩევის მეთოდი, დრო, ინსტრუმენტი და ის, ვისაც შედეგი სარგებელს მოუტანს — ყველაფერი განსაზღვრავს, გადატანადია თუ არა რიცხვი შენს გადაწყვეტილებაზე.
გადატანადობა (Generalization) არის საბოლოო ფილტრი. ერთ კონტექსტში (ერთ ქვეყანაში, ერთ სეზონში, ერთი კლიენტის დონეზე, ერთ მოწყობილობაზე) შეგროვებული მონაცემები შეიძლება არ გადავიდეს მეორეზე. რიცხვი შეიძლება იყოს სრულყოფილად გაზომილი და მაინც იყოს შენი კითხვისთვის არასწორი რიცხვი. „აქ სიმართლეა“ და „ჩემი გადაწყვეტილებისთვის სიმართლეა“ — სხვადასხვა მტკიცებებია.
ქეის-სტადია გამყიდველის საიტზე
პროგრამული უზრუნველყოფის გამყიდველის ლენდინგ გვერდზე წერია: „ჩვენი ინსტრუმენტის გამოყენებამ კომპანიებში პროდუქტიულობა 35%-ით გაზარდა“. ციფრი მოდის სამი კლიენტი კომპანიის ქეის-სტადიიდან, რომლებიც გამყიდველმა თვითონ აირჩია და აღწერა. გაზომვა მოხდა კომპანიების მიერ თვითშეფასებული დაზოგილი საათების მიხედვით, პირველი თვის განმავლობაში, გამყიდველის გუნდის მიერ განხორციელებული ხელით, ინდივიდუალური (white-glove) ჩართვის შემდეგ.
ორიწუთიანი სკეპტიკოსის ჩამონათვალი
გაუშვით ეს ნებისმიერ კვლევაზე, დეშბორდზე თუ ავტომატურ ანგარიშზე
ახლა გაქვთ ხუთი რეფლექსი. აქ არის ისინი ჩეკლისტის სახით, რომელიც ნებისმიერ თავდაჯერებულ რიცხვზე, რომელიც თქვენს მაგიდაზე დაეცემა, ორ წუთში შეგიძლიათ გაუშვათ.
1. ნიმუში და სიმძლავრე. რამდენად დიდია ნიმუში ამ რიცხვის უკან? საკმარისად დიდია თუ არა, რომ აღმოაჩინოს ეფექტი, რომლის მიხედვითაც ღირს მოქმედება, თუ საკმარისად პატარაა, რომ რამდენიმე დაკვირვებამ გადააწყოს? პატარა ჯგუფზე მიღებული მაჩვენებელი უმეტესად ხმაურია.
2. ინტერვალი, არა წერტილი. არსებობს თუ არა სანდოობის ინტერვალი ან შეცდომის ზოლი, თუ მხოლოდ შიშველი წერტილოვანი შეფასებაა? წერტილი ინტერვალის გარეშე არის წითელი დროშა. თუ ორ რამეს ადარებენ, ემთხვევა თუ არა მათი ინტერვალები? გადაფარვა ნიშნავს, რომ სხვაობა არ არის დადგენილი.
3. რამდენი შედარება? ეს იყო ერთი წინასწარ გაცხადებული ტესტი, თუ ბევრიდან ყველაზე იღბლიანი ნაჭერი? ჰკითხეთ, რამდენი მეტრიკა, სეგმენტი თუ ვარიანტი განიხილეს. „მნიშვნელოვანი“ გამარჯვებული, რომელიც ძებნიდან ამოიღეს, საჭიროებს ახალ holdout-ს ან წინასწარ რეგისტრირებულ დადასტურებას, სანამ დაიჯერებდეთ.
4. ეფექტის ზომა versus სტატისტიკური მნიშვნელოვნება. გადადეთ p-value ერთი წუთით: რამდენად დიდია ეფექტი და საკმარისად დიდია თუ არა იმისთვის, რომ ამ გადაწყვეტილებაში მნიშვნელოვანი იყოს მის წინააღმდეგ საწინააღმდეგო ხარჯთან შედარებით? „მნიშვნელოვანი“ უზარმაზარ ნიმუშზე მაინც შეიძლება იყოს უმნიშვნელოდ მცირე.
5. ბაზური მაჩვენებელი და წარმომავლობა. რა არის საბაზისო მაჩვენებელი, რომელსაც ეს რიცხვი ეყრდნობა? ვინ შეაგროვა მონაცემები, როგორ, ვისზე და ვის აქვს სარგებელი შედეგიდან? ემთხვევა თუ არა გაზომვის კონტექსტი იმ გადაწყვეტილებას, რომელსაც იღებთ?
კარიდან გასაყვანი ერთი წინადადება: რიცხვი არის მტკიცება, არა ფაქტი, სანამ არ ნახავ მის ნიმუშს, მის ინტერვალს, მის შედარებებსა და მის წარმომავლობას. ინსტრუმენტები განაგრძობენ თავდაჯერებული ციფრების გამოყოფას. შენი საქმეა წაიკითხო ის ოთხი რამ, რასაც ისინი გამოტოვებენ.
უფრო ღრმად ჩასასვლელად რეკომენდებული კითხვაა დარელ ჰაფის „როგორ ვიწამოთ სტატისტიკით“, ჩარლზ უილენის „შიშველი სტატისტიკა“, რეჯინა ნუცოს წერილები p-hacking-ზე და CONSORT-ის სახელმძღვანელო კვლევის მეთოდების წაკითხვის შესახებ.