语义距离即欧几里得距离
高维向量空间
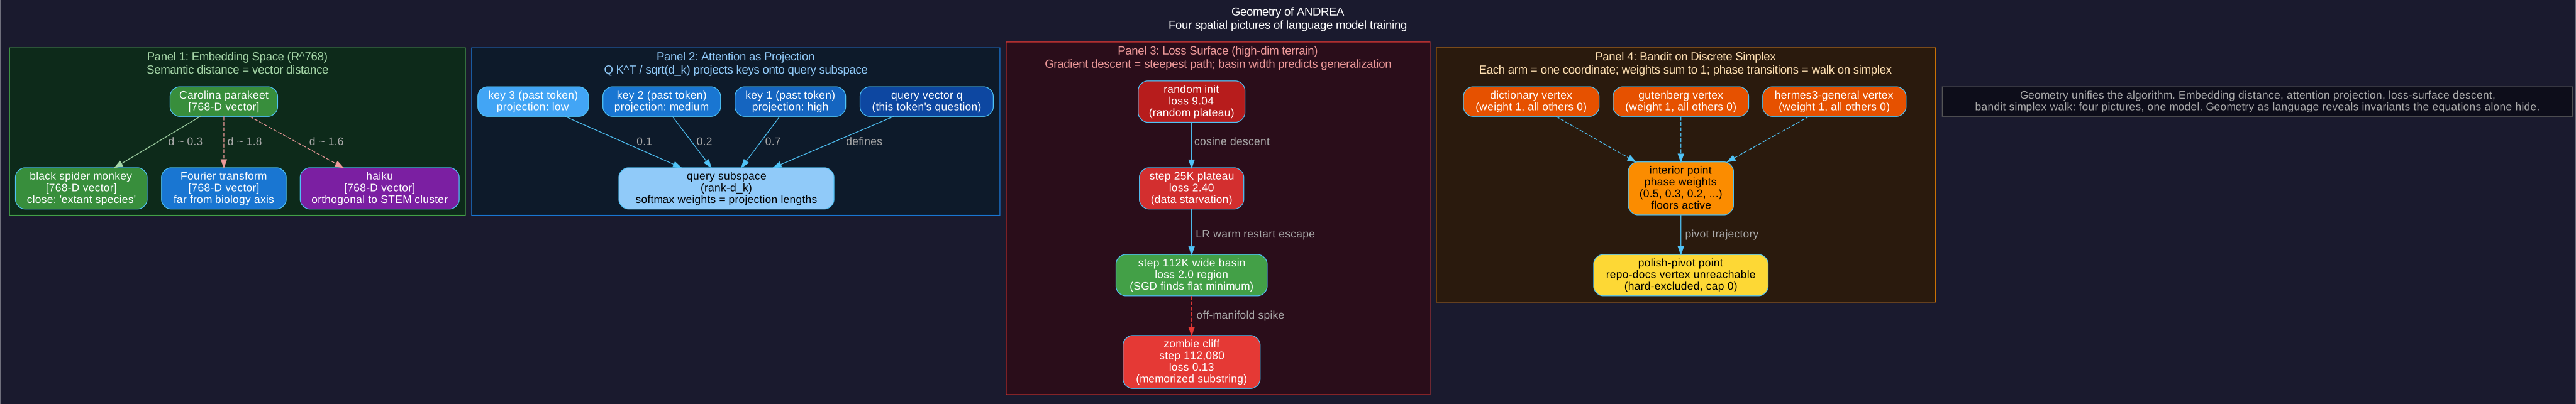
ANDREA-120M 中 8449 个标记词汇表里的每个标记都映射到 R^768 中的一个点。标记嵌入矩阵的形状为 8449 x 768:8449 行,每行对应一个词汇表标记;768 列,每列对应一个嵌入维度。
三个性质使其成为向量空间
1. 加法。 v_a + v_b 落在 R^768 中。两个嵌入向量的和是一个有效的向量。
2. 标量乘法。 对于任意实数 alpha,alpha * v 落在 R^768 中。沿相同方向拉伸或缩小。
3. 线性性。 alpha v_a + beta v_b 落在 R^768 中。线性组合保持在空间内部。
这些性质为我们提供了几何工具:距离、角度、投影、基、正交性。
距离作为语义相似度
两个嵌入向量的余弦相似度衡量它们之间的夹角:cos(theta) = (v_a . v_b) / (||v_a|| * ||v_b||)。取值范围:-1(方向相反)到 +1(方向平行)。
训练后的经验规律:具有相似上下文的词元(tokens)会产生具有高余弦相似度的嵌入向量。ANDREA-120M 将 parakeet(鹦鹉)和 monkey(猴子)放置得很近(两者均为生物,均为物种,且均属于现存或灭绝的分类)。它将 Fourier(傅里叶)和 transform(变换)放置得很近(信号处理语境)。它将 parakeet 和 Fourier 放置得很远(跨领域正交性)。
为什么是 R^768 而不是 R^384
ANDREA-12M 使用 d_model = 384。ANDREA-120M 将其加倍至 768。这一加倍至关重要:384 维空间可用的“角度”较少,且跨领域消歧能力较差。加倍容量使模型能够在嵌入空间中将 bank(河岸)和 bank(银行)解析到不同的盆地中,而不会导致其中一个坍缩进另一个。
嵌入更新作为向量平移
每个梯度步骤都会向 v_token 添加 delta_v。从几何角度看:在 R^768 中的微小平移会将每个 token 的位置推向能够降低损失的邻域。经过 20 万步后,每个 token 都从其随机初始化位置迁移到了一个学习到的位置。
计算距离
三个训练好的嵌入(为便于算术运算,简化至 R^3):
- v(parakeet) = (1.0, 0.5, 0.0)
- v(monkey) = (1.2, 0.3, 0.1)
- v(Fourier) = (0.0, 0.0, 1.5)
投影到查询子空间
注意力计算的内容
对于位置 t 处的词元,注意力计算如下:
softmax(Q K^T / sqrt(d_k)) V
其中 Q 是查询(当前 token 的问题),K 是键(所有过去 token 的标识符),V 是值(所有过去 token 的内容)。输出根据查询与每个键的相关程度对 V 进行加权混合。
几何解读
将 K 视为 R^d_k 中向量的列表。每一行代表一个过去 token 的键。Q 是 R^d_k 中的一个向量:当前 token 的问题。
Q K^T 将每个键(key)投影到 Q 上。点积 q · k_i 衡量 k_i 在 q 方向上的分量大小。投影较长表示该键与查询高度相关;投影较短表示该键与查询几乎无关。
softmax 将投影值归一化为总和为 1 的权重。V 的加权和是一个单一向量:它是过去内容的混合,权重由与当前查询的相关性决定。
多头注意力作为多子空间投影
ANDREA-120M 使用 12 个注意力头。d_model = 768;d_k = 768 / 12 = 64。每个头投影到 R^768 中不同的 64 维子空间。12 个头提供了对同一序列的 12 个独立视角:一个头可能追踪语法角色,另一个追踪语义相似性,还有一个追踪长程引用。
从几何角度看:每个头定义了一个 64 维的定向子空间(一个“窗口”),通过它来观察过去的内容。
因果掩码
仅解码器模型会添加因果掩码:在应用 softmax 之前,Q K^T 矩阵中所有对角线以上的元素都被设置为负无穷大。从几何角度来看:投影到任何未来 token 上的权重都为零。第 t 个 token 只能看到从 0 到 t 的 token。
这为何重要:训练与推理变得对称。使用相同的前向传播过程,相同的掩码投影,无需特殊的生成逻辑。
sqrt(d_k) 缩放
如果不进行缩放,点积会随着 d_k 增大而增大。较大的点积会将 softmax 推向 one-hot 区域(一个权重接近 1,其余接近 0)。除以 sqrt(d_k) 可以保持投影在单位方差尺度上,从而在广泛的 d_k 值范围内保持 softmax 的锐度。
从几何角度而言:sqrt(d_k) 对投影的长度进行归一化,使得无论子空间维度如何,softmax 看到的量级都是可比的。
解读投影
在 R^4 中有三个键和一个查询(为便于计算而简化):
- q = (1, 0, 1, 0)
- k_1 = (1, 0, 0, 0) [过去 token 1]
- k_2 = (0, 0, 1, 0) [过去 token 2]
- k_3 = (0, 1, 0, 1) [过去 token 3]
d_k = 4,因此 sqrt(d_k) = 2。
梯度下降作为地形上的路径
一个 1.2 亿+1 维的表面
ANDREA-120M 的每一种权重配置都是 R^120,000,000 中的一个点。损失函数 L(w) 将每个点映射到一个实数:即该配置下的训练损失。这些损失值共同在参数空间上方描绘出一个 (1.2 亿+1) 维的表面。
从几何角度直接可视化是不可能的。但在概念上:它就像一片地形。山峰(高损失)、山谷(低损失)、鞍点、高原、山脊、盆地。
梯度作为局部坡度
grad L(w) 是 R^120M 中的一个向量,指向 L 最陡峭的增加方向。对其取负:-grad L(w) 指向最陡峭的下降方向。
一次 AdamW 更新会将 w 沿负梯度方向微调(并带有来自 m 和 v 的自适应缩放)。从几何角度看:这是沿着损失曲面朝下坡方向迈出的极小一步,步长由学习率(lr)控制。
v1 的糟糕盆地
v1 在权重刚初始化时,以峰值学习率(0.0003)迈出了第一步。几何图像如下:w_0 位于一个曲率极高的区域(随机初始化在许多方向上具有高曲率),而峰值学习率的一步导致其落入错误的盆地。随后的步骤无法使其逃逸。模型陷入困境,不断输出“region region region”,因为从它落点出发,该盆地是模型能找到的损失最低的盆地。
v2 的预热路径
v2 采取 2000 个小步长,学习率从 0 线性上升至峰值。几何图像如下:w_0 首先沿着平滑方向(曲率较低的方向)温和地迁移。到第 2000 步时,w 已进入更易导航的区域;此时峰值学习率可以将其推向更好的盆地,而不会发生超调。
预热(Warmup)是一种几何感知的初始化协议:让模型在强力优化之前,先找到一个安全的局部邻域。
宽盆地与窄盆地
在第 112K 步时,ANDREA-120M 处于一个盆地中。问题:它有多宽?
宽盆地 = 许多邻近的权重配置也能实现较低的训练损失。泛化能力通常较好(盆地宽度可预测测试性能;参见 PAC-Bayes 课程,第 3 章)。
狭窄盆地 = 只有一小簇权重能达到低损失。泛化能力往往较差。
v3 抛光在第 112,619 步通过课程扰动(改变损失函数:不同的赌博机、不同的训练混合比例),在不重置的情况下推动模型沿损失曲面移动,使其进入一个更宽的盆地,让 SGD 在新策略下找到附近的平坦区域。
僵尸悬崖
第 112,080 步出现的异常损失 0.13 是一个悬崖:一个尖锐且狭窄的区域,其中某个特定的输入模式(记忆化的仓库文档子串)导致损失接近零。模型从较宽的盆地跌落进了狭窄的沟壑。抛光转向中对仓库文档的硬性排除填平了该沟壑,使得 SGD 再也无法找到它。
解读地形
课程混合作为离散单纯形上的游走
什么是单纯形
n 维单纯形(具体来说是标准的 (n-1)-单纯形)是 n 元组 (w_1, w_2, ..., w_n) 的集合,其中每个 w_i >= 0 且 sum(w_i) = 1。
当 n = 2 时:从 (1, 0) 到 (0, 1) 的线段。当 n = 3 时:顶点为 (1, 0, 0)、(0, 1, 0)、(0, 0, 1) 的三角形。当 n = 16(ANDREA 的完整源列表)时:位于 R^16 内部的 15 维单纯形。
多臂老虎机权重作为单纯形坐标
ANDREA 的多臂老虎机在每个阶段针对数据源生成一个权重向量 w。每个分量 w_i 是采样源 i 的概率。概率是非负的且总和为 1:每个权重向量都位于单纯形上。
顶点 = 纯策略(仅采样一个源)。内部 = 混合策略(采样多个源,每个源具有正概率)。边 = 仅两个源的混合。
源下限作为受限区域
ANDREA 设定了最低权重:hermes3-general 的下限为 0.7(抛光后)。这从单纯形中切出了一个子区域:只有满足 w_hermes3-general >= 0.7 的权重向量才是可达的。
从几何上看:下限通过一个超平面切割单纯形。可达区域是单纯形中位于每个下限超平面正确一侧的部分。
上限作为另一种限制
ANDREA 还设定了最大权重:dictionary 的上限为 0.25(抛光后)。每个上限都是另一个超平面,& 可达区域也必须位于每个上限超平面的正确一侧。
完全排除某个源(上限 = 0.0)是最强的上限:该坐标被固定为零,使有效单纯形减少一个维度。
相变作为单纯形上的行走
每一次相变(每 7-42 步)都会生成一个新的权重向量。每个新向量都是单纯形上的一个点。在 20 万步中,多臂老虎机在单纯形的可达区域内描绘出一条漫长的路径。
随机相 = 瞬移到可达区域内的一个均匀随机点。
老虎机控制相 = 朝符合下限与上限约束的 UCB 最优顶点迈出一步。
抛光枢轴 = 重绘可达区域(新的下限、新的上限、排除某些信源),且行走从新的起点继续。
为什么顶点是危险的
纯源阶段(一个 w_i = 1,其余 = 0)位于单纯形的顶点。多样性为零。模型仅在一个分布上进行训练。v1 的崩溃部分可追溯至赌博机(bandit)在 repo-docs 顶点附近“驻扎”;样本仅复制了该源的分布。
下限(Floors)防止顶点驻扎:0.7 的下限意味着“绝不让任何源的权重低于 0.7”(或优先级源对应的下限值)。
遍历可达区域
三个源:hermes3-general (H)、gutenberg (G)、dictionary (D)。约束条件:H 下限 = 0.5,D 上限 = 0.25。(隐含条件:所有权重 >= 0,总和为 1,无其他约束。)
在前 20K 步中限制维度
v2 的课程预热做了什么
v2 将 curriculum_warmup_sources 设置为七个数据源:hermes3-general、hermes3-creative、hermes3-roleplay、chat、smoltalk、oasst、gutenberg。在前 20K 步中,仅这七个数据源参与贡献。在第 20K 步之后,完整的 16 个数据源“消防水带”(全量数据流)被激活。
几何解读
完整的 16 源单纯形位于 R^16 中。限制为 7 个源会将 16 个坐标中的 9 个坍缩为零。老虎机的游走发生在一个 6 维的子单纯形中(比源数量少一维,这是由总和为 1 的约束决定的)。
从几何上看:它是完整单纯形的一个子流形。维度更低,更平滑,更容易导航。
为什么这有助于早期训练
在训练初期,模型完全尚未学会连贯的语言。多样化的源会让它感到困惑:每个源都有自己的风格、自己的词汇分布和自己的模式。在随机初始化时混合 16 个源,会创建一个过于宽泛的目标分布,模型无法拟合。
限制为 7 个对话/散文源提供了一个更均匀的目标。模型首先学习稳定的表示,然后进行扩展。
训练中的几何路径
1. 第 0 至 20K 步(预热阶段)。 行走路径位于 6 维子单纯形上。模型中涌现出稳定的语言模式。
2. 第 20K 至 112K 步(全量数据阶段)。 行走路径扩展至 15 维完整单纯形。领域广度得以涌现。
3. 第 112K 步及以后(精调阶段)。 行走路径再次受限:排除仓库文档和仓库文档字符串,提高对话类数据的下限。在完整单纯形中形成较小的多边形;对话质量得到巩固。
为什么精调阶段设置 curriculum_warmup_steps = 0
精调阶段从第 112K 步开始。模型已经能够说连贯的语言。此时若限制在子单纯形上,只会失去广度而无任何收益(预热的好处是针对新初始化模型的)。设置 warmup_steps = 0 意味着:保持在完整单纯形上,但应用新的上限和下限。
三种几何结构,一次训练运行
v2 预热:低维子单纯形。
v2 火水管:完整的 15 维单纯形。
v3 抛光:完整单纯形,但多边形更小(约束更多)。
同为 20 万步的运行,但处于三种不同的几何状态。每种状态都是针对模型成熟度的不同阶段进行调优的。