Odległość semantyczna jako odległość euklidesowa
Wysokowymiarowa przestrzeń wektorowa
Każdy token w słowniku 8449 tokenów modelu ANDREA-120M mapowany jest na jeden punkt w R^768. Macierz osadzania tokenów ma kształt 8449 x 768: 8449 wierszy, po jednym na każdy token słownika; 768 kolumn, po jednej na każdy wymiar osadzania.
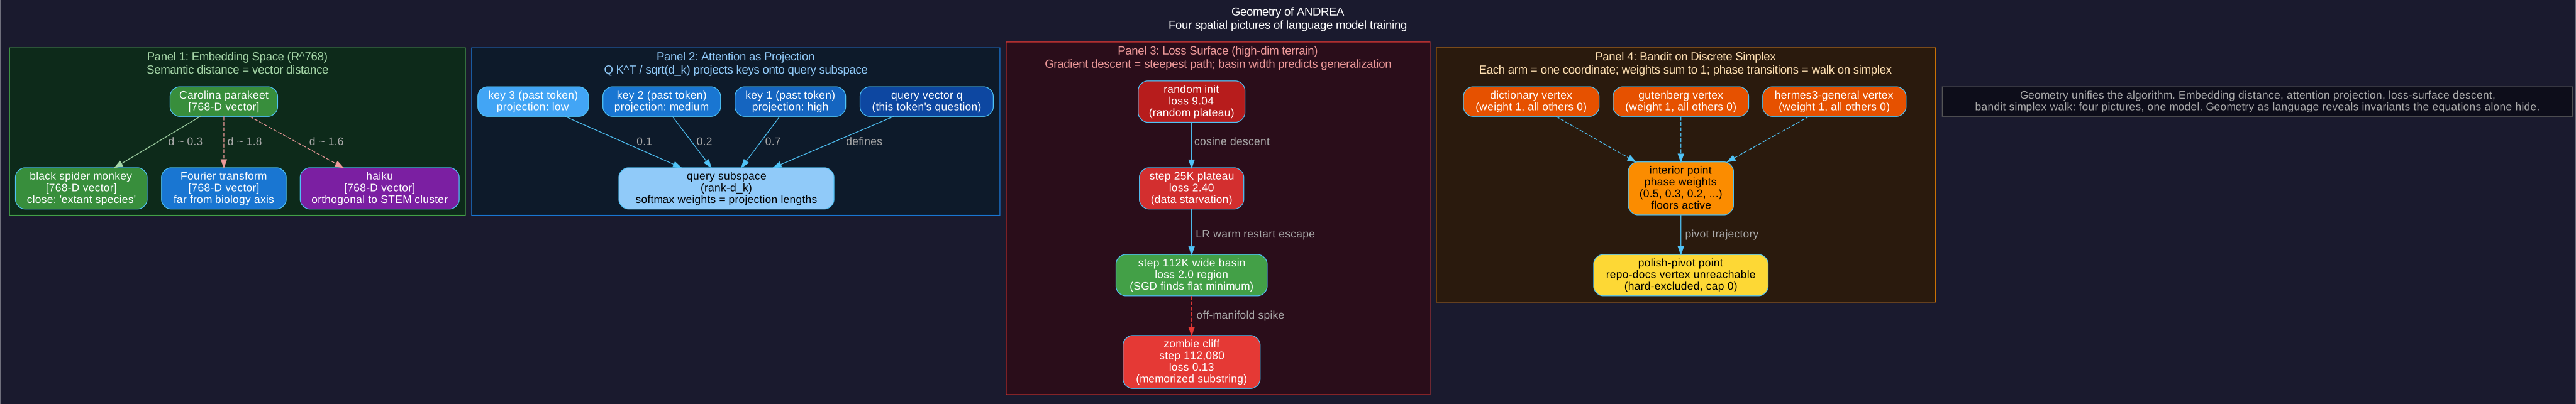
Trzy własności czynią to przestrzenią wektorową
1. Dodawanie. v_a + v_b należy do R^768. Suma dwóch wektorów osadzonych jest wektorem poprawnym.
2. Mnożenie przez skalar. alpha * v należy do R^768 dla dowolnego rzeczywistego alpha. Rozciąganie lub skracanie wzdłuż tego samego kierunku.
3. Liniowość. alpha v_a + beta v_b należy do R^768. Kombinacje liniowe pozostają wewnątrz przestrzeni.
Te własności dają nam narzędzia geometryczne: odległość, kąt, rzutowanie, baza, ortogonalność.
Odległość jako semantyczna podobieństwo
Podobieństwo kosinusowe dwóch wektorów osadzonych (embeddings) mierzy kąt między nimi: cos(theta) = (v_a . v_b) / (||v_a|| * ||v_b||). Zakres: od -1 (przeciwny kierunek) do +1 (równoległy kierunek).
Empiryczny wzorzec po treningu: tokeny o podobnych kontekstach generują wektory osadzone (embeddings) o wysokim podobieństwie kosinusowym. ANDREA-120M umieszcza parakeet (papuga) i monkey (małpa) blisko siebie (obie są istotami biologicznymi, oba gatunki, oba kategorie gatunków istniejących lub wymarłych). Umieszcza Fourier (Fourier) i transform (transformacja) blisko siebie (kontekst przetwarzania sygnałów). Umieszcza parakeet (papuga) i Fourier (Fourier) daleko od siebie (ortogonalność międzydziedzinowa).
Dlaczego R^768, a nie R^384
ANDREA-12M używał d_model = 384. ANDREA-120M podwoił tę wartość do 768. To podwojenie ma znaczenie: przestrzeń 384-wymiarowa oferuje mniej dostępnych „kątów”, co pogarsza rozróżnianie kontekstów międzydziedzinowych. Podwojenie pojemności daje modelowi przestrzeń do rozdzielenia bank (brzeg rzeki) i bank (bank finansowy) na różne „baseny” w przestrzeni osadzeń (embedding space), bez wzajemnego na siebie nachodzenia.
Aktualizacje osadzeń jako translacja wektorów
Każdy krok gradientu dodaje delta_v do v_token. Geometrycznie: małe translacje w R^768 przesuwa pozycję każdego tokena w kierunku sąsiedztw, które zmniejszają stratę. Po 200 tys. kroków każdy token migruje z losowej inicjalizacji do wyuczonego miejsca.
Obliczanie odległości
Trzy wytrenowane osadzenia (uproszczone do R^3 w celu obliczeń):
- v(parakeet) = (1.0, 0.5, 0.0)
- v(monkey) = (1.2, 0.3, 0.1)
- v(Fourier) = (0.0, 0.0, 1.5)
Rzutowanie na podprzestrzeń zapytania
Co oblicza uwaga
Dla tokena w pozycji t, uwaga oblicza:
softmax(Q K^T / sqrt(d_k)) V
Gdzie Q to zapytanie (pytanie tego tokena), K to klucze (identyfikatory każdego poprzedniego tokena), a V to wartości (zawartość każdego poprzedniego tokena). Wyjście miesza V, ważąc je według stopnia, w jakim zapytanie jest powiązane z każdym kluczem.
Geometriczna interpretacja
Rozważ K jako listę wektorów w R^d_k. Każdy wiersz to klucz jednego z poprzednich tokenów. Q to jeden wektor w R^d_k: pytanie tego tokena.
Q K^T rzuca każdy klucz na Q. Iloczyn skalarny q · k_i mierzy, w jakim stopniu k_i leży wzdłuż kierunku q. Długi rzut = klucz silnie istotny dla zapytania. Krótki rzut = klucz ledwo istotny.
softmax normalizuje rzuty do wag sumujących się do 1. Suma ważona V to pojedynczy wektor: mieszanka treści z przeszłości, ważona według istotności dla bieżącego zapytania.
Uwaga wielogłowowa jako rzutowanie na wiele podprzestrzeni
ANDREA-120M używa 12 główek uwagi. d_model = 768; d_k = 768 / 12 = 64. Każda głowka rzuca na inną 64-wymiarową podprzestrzeń R^768. Dwanaście główek daje dwanaście niezależnych widoków tej samej sekwencji: jedna głowka może śledzić rolę gramatyczną, inna podobieństwo semantyczne, a jeszcze inna odniesienia na długi dystans.
Geometrycznie: każda głowka definiuje 64-wymiarową podprzestrzeń o określonym kierunku („okno”), przez które ogląda przeszłość.
Maska przyczynowa
Modele wyłącznie dekodujące dodają maskę przyczynową: każdy element Q K^T powyżej przekątnej jest ustawiany na -nieskończoność przed softmaxem. Geometrycznie: rzut na dowolny przyszły token otrzymuje wagę zerową. Token t może widzieć tylko tokeny od 0 do t.
Dlaczego to ma znaczenie: trening i inferencja stają się symetryczne. Ten sam przebieg do przodu, te same zamaskowane rzuty, brak specjalnej logiki generowania.
Skalowanie przez sqrt(d_k)
Bez skalowania iloczyny skalarnie rosną wraz z d_k. Duże iloczyny skalarnie zmuszają softmax do obszarów jedno-gorących (jedna waga bliska 1, reszta bliska 0). Dzielenie przez sqrt(d_k) utrzymuje rzuty w skali jednostkowej wariancji, zachowując ostrość softmaxu w szerokim zakresie wartości d_k.
Geometrycznie: sqrt(d_k) normalizuje długości projekcji, dzięki czemu softmax widzi porównywalne wielkości niezależnie od wymiaru podprzestrzeni.
Odczyt projekcji
Trzy klucze i jeden zapytanie w R^4 (uproszczone dla celów arytmetycznych):
- q = (1, 0, 1, 0)
- k_1 = (1, 0, 0, 0) [poprzedni token 1]
- k_2 = (0, 0, 1, 0) [poprzedni token 2]
- k_3 = (0, 1, 0, 1) [poprzedni token 3]
d_k = 4, więc sqrt(d_k) = 2.
Spadek gradientu jako ścieżka na terenie
Powierzchnia w 120M+1 wymiarach
Każda konfiguracja wag modelu ANDREA-120M to jeden punkt w R^120,000,000. Funkcja straty L(w) mapuje każdy punkt na liczbę rzeczywistą: stratę treningową dla tej konfiguracji. Razem wartości straty tworzą (120M+1)-wymiarową powierzchnię nad przestrzenią parametrów.
Geometrycznie niemożliwe do bezpośredniej wizualizacji. Pojęciowo: to teren. Góry (wysoka strata), doliny (niska strata), punkty siodłowe, płaskowyże, grzbiety, baseny.
Gradient jako lokalny nachylenie
grad L(w) to wektor w R^120M wskazujący kierunek najszybszego ZWIĘKSZENIA L. Jego negacja: -grad L(w) wskazuje najszybszy spadek w dół.
Jeden krok AdamW przesuwa w w kierunku ujemnego gradientu (z adaptowym skalowaniem z m i v). Geometrycznie: bardzo mały krok wzdłuż powierzchni, w dół, z rozmiarem kroku kontrolowanym przez lr.
Zła dolina w1
w1 wykonał swój pierwszy krok przy LR = szczyt (0,0003) na świeżo zainicjowanych wagach. Obraz geometryczny: w_0 znajduje się w regionie o silnie zakrzywionej powierzchni (inicjalizacja losowa ma wysoką krzywiznę w wielu kierunkach), a krok przy LR na poziomie szczytu ląduje w złej dolinie. Kolejne kroki nie są w stanie z niej wyjść. Model utyka, generując „region region region”, ponieważ ta dolina ma najniższą stratę, jaką model może znaleźć z miejsca, w którym wylądował.
Ścieżka rozgrzewki w2
w2 wykonuje 2000 małych kroków, przy czym LR rośnie od 0 do wartości szczytowej. Obraz geometryczny: w_0 najpierw łagodnie migruje wzdłuż gładkich kierunków (gdzie krzywizna jest niska). Po kroku 2000 w przesuwa się do bardziej nawigowalnego regionu; LR na poziomie szczytowym może wtedy poprowadzić go ku lepszej dolinie bez przekraczania jej.
Rozgrzewka to protokół inicjalizacji uwzględniający geometrię: pozwala modelowi znaleźć bezpieczną okolicę lokalną, zanim zaczniemy go mocno „popychać”.
Dobre vs wąskie baseny
Na kroku 112K model ANDREA-120M znajduje się w basenie. Pytanie: jak szeroki jest on?
Szeroki basen = wiele sąsiednich konfiguracji wag również osiąga niski błąd treningowy. Generalizacja bywa dobra (szerokość basenu przewiduje wyniki testowe; zobacz lekcję PAC-Bayes, rozdział 3).
Wąska dolina = tylko cienki zbiór wag osiąga niski błąd. Ogólna zdolność uogólniania zwykle się pogarsza.
Dopracowanie w wersji v3 na kroku 112 619 przesunęło model wzdłuż powierzchni (bez resetu) do szerszej doliny za pomocą perturbacji kurikulowej: zmiana funkcji straty (inny bandyta, inny miks treningowy), pozwalając SGD znaleźć pobliski płaski obszar w ramach nowej polityki.
Klif Zombie
Anomalia błędu 0,13 na kroku 112 080 była KLIFEM: ostrym, wąskim obszarem, w którym jeden konkretny wzorzec wejściowy (zapamiętany podciąg z dokumentacji repozytorium) daje błąd bliski zeru. Model spadł z szerszej doliny do wąskiego wąwozu. Twarde wykluczenie dokumentacji repozytorium w ramach zwrotu do dopracowania wypełniło ten wąwóz, dzięki czemu SGD nie mógł go już znaleźć.
Czytanie Terenu
Miks programu nauczania jako spacer po dyskretnym prostokącie
Czym jest prostokąt
n-wymiarowy prostokąt (konkretnie standardowy (n-1)-prostokąt) to zbiór n-tek (w_1, w_2, ..., w_n), w których każde w_i >= 0 oraz sum(w_i) = 1.
Dla n = 2: odcinek od (1, 0) do (0, 1). Dla n = 3: trójkąt o wierzchołkach (1, 0, 0), (0, 1, 0), (0, 0, 1). Dla n = 16 (pełna lista źródeł ANDREA): 15-wymiarowy sympleks znajdujący się w R^16.
Wagi bandita jako współrzędne sympleksu
Bandit ANDREA generuje wektor wag w dla źródeł danych w każdej fazie. Każdy składnik w_i to prawdopodobieństwo pobrania źródła i. Prawdopodobieństwa są nieujemne i sumują się do 1: każdy wektor wag znajduje się na sympleksie.
Wierzchołki = strategie czyste (pobieranie tylko jednego źródła). Wnętrze = strategie mieszane (pobieranie wielu źródeł, każde z dodatnim prawdopodobieństwem). Krawędzie = mieszaniny tylko dwóch źródeł.
Dolne granice źródeł jako ograniczony obszar
ANDREA narzuca minimalne wagi: hermes3-general na poziomie dolnym 0,7 (po polerowaniu). To wyodrębnia podobszar prostego: osiągalne są tylko wektory wag, dla których w_hermes3-general >= 0,7.
Geometrycznie: poziom dolny przecina proste hiperpłaszczyzną. Obszar osiągalny to część prostego po właściwej stronie każdej hiperpłaszczyzny poziomu dolnego.
Górne granice jako druga restrykcja
ANDREA narzuca również maksymalne wagi: dictionary na poziomie górnym 0,25 (po polerowaniu). Każda górna granica to kolejna hiperpłaszczyzna, a obszar osiągalny musi znajdować się po właściwej stronie każdej hiperpłaszczyzny górnej granicy.
Wykluczenie źródła całkowicie (górna granica = 0,0) to najsilniejsza możliwa górna granica: współrzędna zostaje przypięta do zera, co zmniejsza wymiar efektywnego prostego o jeden.
Przejścia fazowe jako kroki na prostym
Każde przejście fazowe (co 7–42 kroki) generuje nowy wektor wag. Każdy nowy wektor jest punktem na prostym. W ciągu 200 tys. kroków bandyta rysuje długą ścieżkę przez osiągalny obszar prostego.
Fazy losowe = teleportacja do punktu wylosowanego równomiernie wewnątrz obszaru osiągalnego.
Fazy sterowane bandytą = krok w kierunku wierzchołka o najwyższej wartości UCB, zgodnego z dolnymi i górnymi progami.
Pivot polerski = ponowne narysowanie obszaru osiągalnego (nowe dolne progi, nowe górne progi, wykluczenie niektórych źródeł), a spacer kontynuowany jest od nowego punktu startowego.
Dlaczego wierzchołki są niebezpieczne
Fazy czysto źródłowe (jedno w_i = 1, reszta = 0) znajdują się w wierzchołkach prostegoksu. Różnorodność wynosi zero. Model trenowany jest wyłącznie na jednym rozkładzie. Część załamania w wersji v1 można przypisać do bandyty, który „obozował” w pobliżu wierzchołka repo-dokumentów; próbki odtwarzały wyłącznie rozkład tego źródła.
Podłogi (dolne granice) zapobiegają obozowaniu w wierzchołkach: podłoga na poziomie 0,7 oznacza „nigdy nie pozwól, aby waga żadnego źródła spadła poniżej 0,7” (lub innej wartości podłogi dla źródeł priorytetowych).
Przechodzenie po osiągalnym obszarze
Trzy źródła: hermes3-general (H), gutenberg (G), słownik (D). Ograniczenia: podłoga dla H = 0,5, górna granica (cap) dla D = 0,25. (Jawnie: wszystkie wagi >= 0, suma wynosi 1, brak innych ograniczeń.)
Ograniczenie wymiarów przez pierwsze 20K kroków
Co robiła rozgrzewka programowa w wersji v2
W wersji v2 parametr curriculum_warmup_sources ustawiono na siedem źródeł: hermes3-general, hermes3-creative, hermes3-roleplay, chat, smoltalk, oasst, gutenberg. Przez pierwsze 20K kroków tylko te siedem źródeł dostarczało dane. Po kroku 20K aktywowano pełny strumień 16 źródeł.
Interpretacja geometryczna
Pełny sympleks 16 źródeł znajduje się w R^16. Ograniczenie do 7 źródeł sprowadza 9 z 16 współrzędnych do zera. Przejście bandyta odbywa się w 6-wymiarowym pod-sympleksie (o jeden wymiar mniej niż liczba źródeł, zgodnie z ograniczeniem sumy do 1).
Geometrycznie: POD-SYMPLEKS pełnego sympleksu. Niższy wymiar, gładkość, łatwiejsza nawigacja.
Dlaczego to pomaga w wczesnym treningu
Na wczesnym etapie treningu model w ogóle nie nauczył się spójnego języka. Różnorodne źródła go mylą: każde źródło ma własny styl, własny rozkład słownictwa, własny wzorzec. Mieszanie 16 źródeł przy losowej inicjalizacji tworzy zbyt szeroki rozkład docelowy, którego model nie jest w stanie dopasować.
Ograniczenie do 7 źródeł konwersacyjnych/prozy daje bardziej jednorodny cel. Model najpierw uczy się stabilnego reprezentacji, a następnie rozszerza zakres.
Geometriczna ścieżka przez trening
1. Kroki 0 do 20 tys. (rozgrzewka). „Spacer” odbywa się na 6-wymiarowym podprostokącie. W modelu pojawiają się stabilne wzorce językowe.
2. Kroki 20 tys. do 112 tys. (pełny strumień). „Spacer” rozszerza się do 15-wymiarowego pełnego prostokąta. Pojawia się szerokość domenowa.
3. Krok 112 tys. i dalej (polerowanie). „Spacer” zostaje ponownie ograniczony: wykluczono repo-dokumenty i repo-dokumentacje, podniesiono dolne progi konwersacyjne. Mniejszy wielokąt w pełnym prostokącie; jakość konwersacyjna ulega konsolidacji.
Dlaczego zestaw Polish ustawia curriculum_warmup_steps = 0
Polish wchodzi na kroku 112 tys. Model już posługuje się spójnym językiem. Ograniczenie do podprostokąta na tym etapie spowodowałoby utratę szerokości bez żadnego zysku (korzyść z rozgrzewki dotyczy modeli z nową inicjalizacją). Ustawienie warmup_steps = 0 oznacza: pozostań na pełnym prostokącie, ale z nowymi limitami i progami.
Trzy geometrie, jedno przebieg treningowe
Rozgrzewka v2: nisko-wymiarowy podprosty.
Firehose v2: pełny 15-wymiarowy proste.
Dopracowanie v3: pełny proste z mniejszym wielokątem (więcej ograniczeń).
Ten sam przebieg treningowy 200 tys. kroków, trzy różne reżimy geometryczne. Każdy z nich został dostrojony do innego etapu dojrzałości modelu.