La distancia semántica como distancia euclidiana
Un espacio vectorial de alta dimensión
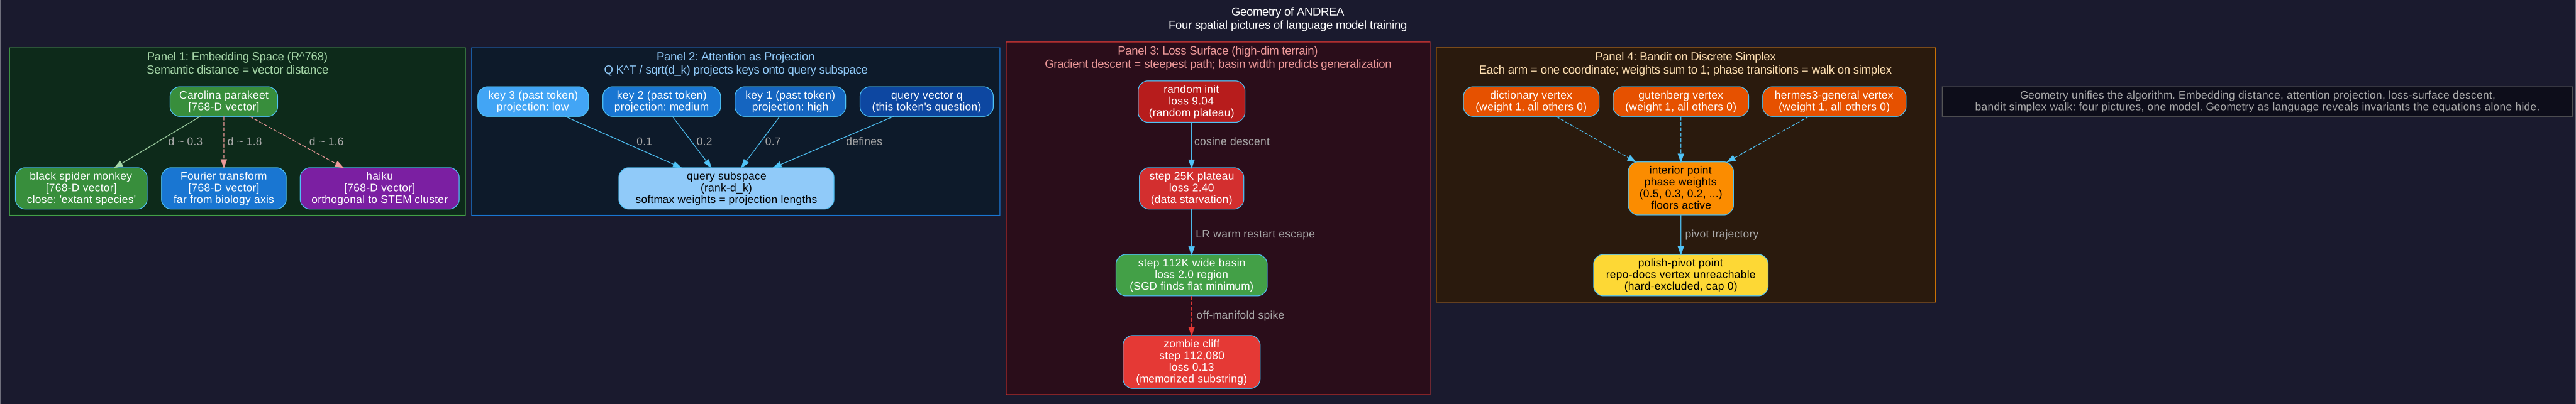
Cada token en el vocabulario de 8449 tokens de ANDREA-120M se mapea a un punto en R^768. La matriz de incrustación de tokens tiene forma 8449 x 768: 8449 filas, una por token del vocabulario; 768 columnas, una por dimensión de incrustación.
Tres propiedades hacen de esto un espacio vectorial
1. Adición. v_a + v_b cae en R^768. La suma de dos embeddings es un vector válido.
2. Multiplicación escalar. alpha * v cae en R^768 para cualquier alpha real. Estira o encoge a lo largo de la misma dirección.
3. Linealidad. alpha v_a + beta v_b cae en R^768. Las combinaciones lineales permanecen dentro del espacio.
Estas propiedades nos dan herramientas geométricas: distancia, ángulo, proyección, base, ortogonalidad.
Distancia como similitud semántica
La similitud coseno de dos embeddings mide el ángulo entre ellos: cos(theta) = (v_a . v_b) / (||v_a|| * ||v_b||). Rango: -1 (opuestos) a +1 (paralelos).
Patrón empírico tras el entrenamiento: los tokens con contextos similares producen embeddings con alta similitud coseno. ANDREA-120M coloca parakeet y monkey cerca entre sí (ambos biológicos, ambos especies, ambas categorías de extintos o existentes). Coloca Fourier y transform cerca entre sí (contexto de procesamiento de señales). Coloca parakeet y Fourier lejos entre sí (ortogonalidad entre dominios).
Por qué R^768 y no R^384
ANDREA-12M usó d_model = 384. ANDREA-120M lo duplicó a 768. El duplicado es importante: un espacio de 384 dimensiones tiene menos 'ángulos' disponibles, y la desambiguación entre dominios se ve afectada. Duplicar la capacidad le da al modelo espacio para resolver bank (río) versus bank (financiero) en diferentes cuencas del espacio de embeddings sin que uno colapse en el otro.
Actualizaciones de incrustaciones como traducción de vectores
Cada paso de gradiente suma delta_v a v_token. Geométricamente: pequeñas traducciones en R^768 desplazan la posición de cada token hacia vecindades que reducen la pérdida. A lo largo de 200K pasos, cada token migra desde su inicialización aleatoria hasta una ubicación aprendida.
Calculando una distancia
Tres incrustaciones entrenadas (simplificadas a R^3 para la aritmética):
- v(loro) = (1.0, 0.5, 0.0)
- v(mono) = (1.2, 0.3, 0.1)
- v(Fourier) = (0.0, 0.0, 1.5)
Proyección sobre un Subespacio de Consulta
Qué Calcula la Atención
Para un token en la posición t, la atención calcula:
softmax(Q K^T / sqrt(d_k)) V
Donde Q es la consulta (la pregunta de este token), K son las claves (el identificador de cada token pasado) y V son los valores (el contenido de cada token pasado). La salida mezcla V ponderado por cuánto se relaciona la consulta con cada clave.
Lectura Geométrica
Piensa en K como una lista de vectores en R^d_k. Cada fila es la clave de un token pasado. Q es un vector en R^d_k: la pregunta de este token.
Q K^T proyecta cada clave sobre Q. El producto punto q . k_i mide en qué medida k_i se encuentra a lo largo de la dirección de q. Una proyección larga = la clave es altamente relevante para la consulta. Una proyección corta = la clave es apenas relevante.
softmax normaliza las proyecciones en pesos que suman 1. La suma ponderada de V es un único vector: una mezcla del contenido pasado, ponderada por la relevancia con la consulta actual.
Atención Multi-Cabeza como Proyección Multi-Subespacio
ANDREA-120M utiliza 12 cabezas de atención. d_model = 768; d_k = 768 / 12 = 64. Cada cabeza proyecta en un subespacio de 64 dimensiones diferente dentro de R^768. Las doce cabezas proporcionan doce vistas independientes de la misma secuencia: una cabeza podría rastrear el rol gramatical, otra la similitud semántica y otra las referencias de largo alcance.
Geométricamente: cada cabeza define un subespacio orientado de 64 dimensiones (una 'ventana') a través del cual observa el pasado.
La máscara causal
Los modelos solo decodificador añaden una máscara causal: cada entrada de Q K^T por encima de la diagonal se establece en -infinito antes del softmax. Geométricamente: la proyección sobre cualquier token futuro recibe peso cero. El token t solo puede ver los tokens desde 0 hasta t.
Por qué es importante: el entrenamiento y la inferencia se vuelven simétricos. Mismo paso hacia adelante, mismas proyecciones enmascaradas, sin lógica especial de generación.
Escalado por sqrt(d_k)
Sin escalado, los productos punto crecen con d_k. Los productos punto grandes empujan al softmax hacia regiones one-hot (un peso cercano a 1, el resto cercano a 0). Dividir por sqrt(d_k) mantiene las proyecciones en una escala de varianza unitaria, preservando la nitidez del softmax en un amplio rango de valores de d_k.
Geométricamente: sqrt(d_k) normaliza las longitudes de las proyecciones para que el softmax vea magnitudes comparables independientemente de la dimensión del subespacio.
Lectura de una proyección
Tres claves y una consulta en R^4 (simplificado para el cálculo):
- q = (1, 0, 1, 0)
- k_1 = (1, 0, 0, 0) [token pasado 1]
- k_2 = (0, 0, 1, 0) [token pasado 2]
- k_3 = (0, 1, 0, 1) [token pasado 3]
d_k = 4, por lo tanto sqrt(d_k) = 2.
El descenso de gradiente como trayectoria sobre un terreno
Una superficie en 120M+1 dimensiones
Cada configuración de pesos de ANDREA-120M es un punto en R^120,000,000. La pérdida L(w) asigna a cada punto un número real: la pérdida de entrenamiento en esta configuración. Juntas, las pérdidas trazan una superficie de (120M+1) dimensiones sobre el espacio de parámetros.
Geométricamente, es imposible visualizarla directamente. Conceptualmente: un terreno. Montañas (pérdida alta), valles (pérdida baja), puntos de silla, mesetas, crestas, cuencas.
El gradiente como pendiente local
grad L(w) es un vector en R^120M que apunta en la dirección de mayor AUMENTO de L. Al negarlo: -grad L(w) apunta cuesta abajo en la dirección más pronunciada.
Un paso de AdamW desplaza w en la dirección opuesta al gradiente (con escalado adaptativo de m y v). Geométricamente: un paso diminuto a lo largo de la superficie, cuesta abajo, con el tamaño del paso controlado por lr.
El mal valle de v1
v1 dio su primer paso con LR = pico (0.0003) sobre pesos recién inicializados. Imagen geométrica: w_0 se sitúa en una región con curvatura extrema (la inicialización aleatoria tiene alta curvatura en muchas direcciones), y un paso con LR de pico lo lleva al valle equivocado. Los pasos posteriores no pueden escapar. El modelo se queda atascado produciendo 'region region region' porque ese valle tiene la menor pérdida que el modelo puede encontrar desde donde aterrizó.
La ruta de calentamiento de v2
v2 da 2000 pasos pequeños con LR que aumenta gradualmente desde 0 hasta el pico. Imagen geométrica: w_0 primero migra suavemente a lo largo de direcciones suaves (donde la curvatura es baja). Para el paso 2000, w se ha movido a una región más navegable; entonces, el LR de pico puede impulsarlo hacia un valle mejor sin pasarse de la meta.
El calentamiento (warmup) es un protocolo de inicialización consciente de la geometría: permite que el modelo encuentre un vecindario local seguro antes de forzarlo intensamente.
Cuencas anchas vs. estrechas
En el paso 112K, ANDREA-120M se encuentra en una cuenca. Pregunta: ¿qué tan ancha es?
Cuenca ancha = muchas configuraciones de pesos vecinas también logran una baja pérdida de entrenamiento. La generalización tiende a ser buena (el ancho de la cuenca predice el rendimiento de prueba; ver la lección sobre PAC-Bayes, Capítulo 3).
Cuenca estrecha = solo un conjunto delgado de pesos logra una pérdida baja. La generalización tiende a sufrir.
El pulido v3 en el paso 112.619 empujó al modelo a lo largo de la superficie (sin reiniciar) hacia una cuenca más amplia mediante perturbación curricular: cambiar la función de pérdida (diferente bandit, diferente mezcla de entrenamiento), dejando que el SGD encuentre una región plana cercana bajo la nueva política.
El Acantilado Zombi
La pérdida anómala de 0,13 en el paso 112.080 fue un ACANTILADO: una región aguda y estrecha donde un patrón de entrada específico (una subcadena de repo-docs memorizada) produce una pérdida casi nula. El modelo cayó desde la cuenca más amplia hacia una garganta estrecha. La exclusión estricta de repo-docs en el giro de pulido rellenó esa garganta, de modo que el SGD ya no podía encontrarla.
Leyendo el Terreno
La Mezcla del Plan de Estudios como un Recorrido en un Simplex Discreto
Qué es un Simplex
Un simplex de n dimensiones (específicamente el simplex estándar (n-1)) es el conjunto de n-tuplas (w_1, w_2, ..., w_n) donde cada w_i >= 0 & sum(w_i) = 1.
Para n = 2: un segmento de línea desde (1, 0) hasta (0, 1). Para n = 3: un triángulo con vértices en (1, 0, 0), (0, 1, 0), (0, 0, 1). Para n = 16 (la lista completa de fuentes de ANDREA): un simplexo de 15 dimensiones situado dentro de R^16.
Pesos del bandit como coordenadas del simplexo
El bandit de ANDREA genera un vector de pesos w sobre las fuentes de datos en cada fase. Cada componente w_i es la probabilidad de muestrear la fuente i. Las probabilidades son no negativas y suman 1: cada vector de pesos reside en el simplexo.
Vértices = estrategias puras (muestrear solo una fuente). Interior = estrategias mixtas (muestrear múltiples fuentes, cada una con probabilidad positiva). Aristas = mezclas de solo dos fuentes.
Pisos de fuente como región restringida
ANDREA impone pesos mínimos: hermes3-general con un límite inferior de 0,7 (tras el pulido). Esto delimita una subregión del simplejo: solo los vectores de pesos con w_hermes3-general >= 0,7 son alcanzables.
Geométricamente: el límite inferior corta el simplejo con un hiperplano. La región alcanzable es la parte del simplejo que se encuentra en el lado correcto de cada hiperplano de límite inferior.
Los límites superiores como la otra restricción
ANDREA también impone pesos máximos: dictionary con un límite superior de 0,25 (tras el pulido). Cada límite superior es otro hiperplano, y la región alcanzable debe situarse en el lado correcto de cada hiperplano de límite superior también.
Excluir una fuente por completo (límite superior = 0,0) es el límite superior más fuerte posible: la coordenada queda fijada en cero, reduciendo el simplejo efectivo en una dimensión.
Transiciones de fase como recorridos en el simplejo
Cada transición de fase (cada 7-42 pasos) produce un nuevo vector de pesos. Cada nuevo vector es un punto en el simplejo. A lo largo de 200K pasos, el bandit traza un largo camino a través de la región alcanzable del simplejo.
Fases aleatorias = teletransporte a un punto aleatorio uniforme dentro de la región alcanzable.
Fases controladas por el bandit = paso hacia el vértice óptimo UCB consistente con los límites inferiores y superiores.
Pivote de pulido = redibujar la región alcanzable (nuevos límites inferiores, nuevos límites superiores, algunas fuentes excluidas), y el recorrido continúa desde el nuevo punto de partida.
Por qué los vértices son peligrosos
Las fases de fuente pura (un w_i = 1, el resto = 0) se sitúan en los vértices del simplexo. La diversidad es cero. El modelo se entrena con una sola distribución. El colapso de v1 se atribuyó en parte al hecho de que el bandit permanecía cerca del vértice de repo-docs; las muestras reproducían exclusivamente la distribución de esa fuente.
Los límites inferiores (floors) previenen el acampamiento en los vértices: un límite inferior de 0.7 indica 'nunca dejar que el peso de ninguna fuente baje de 0.7' (o lo que sea el límite inferior para las fuentes prioritarias).
Recorriendo la Región Alcanzable
Tres fuentes: hermes3-general (H), gutenberg (G), dictionary (D). Restricciones: límite inferior de H = 0.5, límite superior (cap) de D = 0.25. (Implícito: todos los pesos >= 0, suman 1, sin otras restricciones.)
Restricción de dimensiones para los primeros 20K pasos
Lo que hizo el calentamiento del currículo de v2
v2 configuró curriculum_warmup_sources con siete fuentes: hermes3-general, hermes3-creative, hermes3-roleplay, chat, smoltalk, oasst, gutenberg. Durante los primeros 20K pasos, SOLO esas siete fuentes contribuyeron. Después del paso 20K, se activó la manguera completa de 16 fuentes.
Lectura geométrica
El simplexo completo de 16 fuentes se sitúa en R^16. Al restringir a 7 fuentes, 9 de las 16 coordenadas se reducen a cero. El recorrido del bandit tiene lugar en un sub-simplexo de 6 dimensiones (una menos que el número de fuentes, debido a la restricción de suma a 1).
Geométricamente: un SUBMANIFOLDO del simplexo completo. De menor dimensión, más suave y más fácil de navegar.
Por qué esto ayuda en el entrenamiento inicial
Al inicio del entrenamiento, el modelo no ha aprendido un lenguaje coherente en absoluto. Las fuentes diversas lo confunden: cada fuente tiene su propio estilo, su propia distribución de vocabulario y su propio patrón. Mezclar 16 fuentes con una inicialización aleatoria crea una distribución de objetivo demasiado amplia para que el modelo pueda ajustarse a ella.
Restringir a 7 fuentes conversacionales/de prosa proporciona un objetivo más uniforme. El modelo primero aprende una representación estable y luego se expande.
Trayectoria geométrica durante el entrenamiento
1. Pasos 0 a 20K (calentamiento). El recorrido se mantiene en el sub-simplejo de 6 dimensiones. Surgen patrones de lenguaje estables en el modelo.
2. Pasos 20K a 112K (flujo completo). El recorrido se expande al simplejo completo de 15 dimensiones. Surge la amplitud de dominios.
3. Paso 112K en adelante (pulido). El recorrido se restringe nuevamente: se excluyen repo-docs y repo-docstrings, y se elevan los mínimos conversacionales. Un polígono más pequeño dentro del simplejo completo; la calidad conversacional se consolida.
Por qué el conjunto de Pulido establece curriculum_warmup_steps = 0
El pulido entra en el paso 112K. El modelo ya habla un lenguaje coherente. Restringir a un sub-simplejo ahora perdería amplitud sin ganar nada (el beneficio del calentamiento es para modelos con inicialización nueva). Establecer warmup_steps = 0 indica: permanecer en el simplejo completo, pero con nuevos límites y mínimos.
Tres geometrías, una ejecución de entrenamiento
Calentamiento v2: sub-simplejo de baja dimensión.
Llamada de agua v2: simplejo completo de 15 dimensiones.
Pulido v3: simplejo completo con polígono más pequeño (más restricciones).
Misma ejecución de 200K pasos, tres regímenes geométricos diferentes. Cada uno fue ajustado para una fase diferente de madurez del modelo.