語義距離即歐幾里得距離
高維向量空間
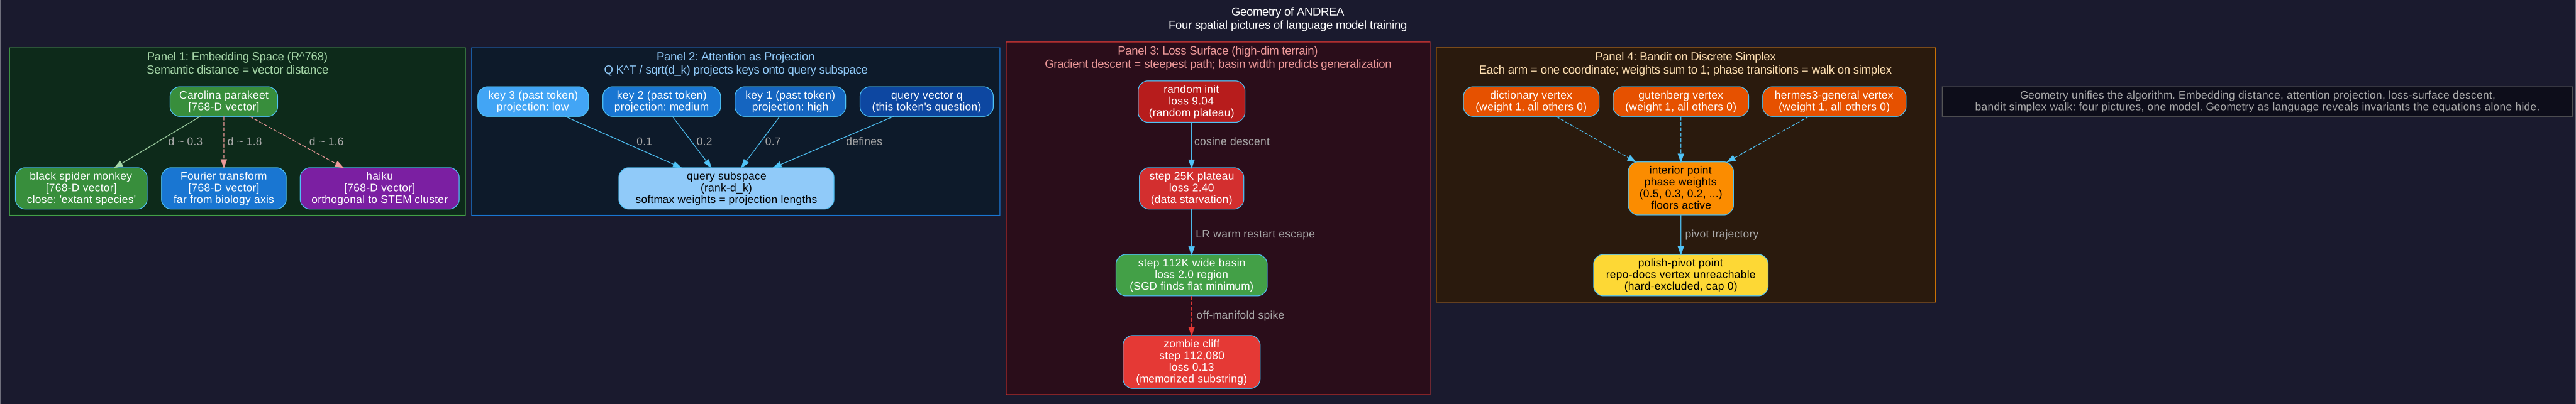
ANDREA-120M 詞彙表中 8449 個 token 中的每一個,都對應 R^768 中的一個點。token 嵌入矩陣的形狀為 8449 x 768:8449 行,每行對應詞彙表中的一個 token;768 列,每列對應一個嵌入維度。
三個性質使其成為向量空間
1. 加法。 v_a + v_b 落在 R^768 中。兩個嵌入向量的和是一個有效的向量。
2. 標量乘法。 對於任何實數 alpha,alpha * v 都落在 R^768 中。沿著相同方向進行拉伸或縮小。
3. 線性性。 alpha v_a + beta v_b 落在 R^768 中。線性組合保持在空間內。
這些性質為我們提供了幾何工具:距離、角度、投影、基底、正交性。
距離作為語義相似度
兩個嵌入向量的餘弦相似度衡量它們之間的夾角:cos(theta) = (v_a . v_b) / (||v_a|| * ||v_b||)。範圍:-1(方向相反)至 +1(方向平行)。
訓練後的經驗性模式:具有相似上下文的詞元會產生具有高餘弦相似度的嵌入向量。ANDREA-120M 將 parakeet(鸚鵡)與 monkey(猴子)置於相近位置(兩者皆屬生物學範疇、皆為物種、且皆屬於現存或已滅絕的類別)。它將 Fourier(傅立葉)與 transform(變換)置於相近位置(訊號處理的語境)。它將 parakeet 與 Fourier 置於遙遠位置(跨領域的正交性)。
為何是 R^768 而非 R^384
ANDREA-12M 使用 d_model = 384。ANDREA-120M 將其加倍至 768。這加倍至關重要:384 維空間中可用的「角度」較少,導致跨領域的歧義消解能力受損。加倍容量賦予模型空間,使其能將 bank(河岸)與 bank(銀行)解析為嵌入空間中不同的盆地,而不會讓其中一個坍縮進另一個。
嵌入更新作為向量平移
每個梯度步驟都會將 delta_v 加到 v_token 上。從幾何角度來看:在 R^768 空間中的微小平移,會將每個 token 的位置推向能降低損失函數的鄰域。經過 20 萬個步驟後,每個 token 都從其隨機初始化位置遷移至學習後的位置。
計算距離
三個訓練後的嵌入(為便於運算,簡化為 R^3):
- v(parakeet) = (1.0, 0.5, 0.0)
- v(monkey) = (1.2, 0.3, 0.1)
- v(Fourier) = (0.0, 0.0, 1.5)
投影至查詢子空間
注意力計算的內容
對於位置 t 的詞元,注意力計算如下:
softmax(Q K^T / sqrt(d_k)) V
其中 Q 是查詢(此 token 的問題),K 是鍵(每個過去 token 的標識符),V 是值(每個過去 token 的內容)。輸出是根據查詢與每個鍵的相關程度對 V 進行加權混合。
幾何解讀
將 K 視為 R^d_k 中的一組向量列表。每一行代表一個過去 token 的鍵。Q 是 R^d_k 中的一個向量:代表此 token 的問題。
Q K^T 將每個鍵(key)投影到 Q 上。點積 q · k_i 衡量 k_i 在 q 方向上的分量大小。投影長度較長表示該鍵與查詢(query)高度相關;投影長度較短表示該鍵與查詢幾乎無關。
softmax 函數將投影結果正規化為總和為 1 的權重。V 的加權總和形成一個向量:這是過去內容的混合,其權重由與當前查詢的相關性決定。
多頭注意力作為多子空間投影
ANDREA-120M 使用 12 個注意力頭。d_model = 768;d_k = 768 / 12 = 64。每個頭投影到 R^768 中不同的 64 維子空間。十二個頭提供了對同一序列的十二個獨立視角:一個頭可能追蹤語法角色,另一個追蹤語義相似度,還有一個追蹤長距離引用。
從幾何角度來看:每個頭定義了一個 64 維的定向子空間(一個「視窗」),並透過它來觀察過去。
因果遮罩(Causal Mask)
僅解碼器(Decoder-only)模型會加入因果遮罩:在執行 softmax 之前,所有 Q K^T 矩陣中對角線以上的元素都會被設為負無窮大(-infinity)。從幾何角度來看:投射到任何未來 token 上的權重都為零。第 t 個 token 只能看到從第 0 個到第 t 個的 token。
這為何重要:訓練與推論變得對稱。使用相同的前向傳播(forward pass)、相同的遮罩投射,且無需特殊的生成邏輯。
sqrt(d_k) 縮放
若不加縮放,點積會隨著 d_k 增大而增大。過大的點積會將 softmax 推向 one-hot 區域(一個權重接近 1,其餘接近 0)。除以 sqrt(d_k) 可將投射保持在單位方差尺度,從而保留 softmax 在廣泛 d_k 值範圍內的銳度(sharpness)。
從幾何角度來看:sqrt(d_k) 對投影的長度進行正規化,使得 softmax 無論子空間維度如何,都能看到可比較的幅度。
解讀投影
在 R^4 中有三個鍵(keys)和一個查詢(query)(為簡化運算而設定):
- q = (1, 0, 1, 0)
- k_1 = (1, 0, 0, 0) [過去 token 1]
- k_2 = (0, 0, 1, 0) [過去 token 2]
- k_3 = (0, 1, 0, 1) [過去 token 3]
d_k = 4,因此 sqrt(d_k) = 2。
梯度下降作為地形上的路徑
一個 120M+1 維的表面
ANDREA-120M 的每一個權重配置都是 R^120,000,000 中的一個點。損失函數 L(w) 將每個點映射到一個實數:即該配置下的訓練損失。這些損失值共同在參數空間上方描繪出一個 (120M+1) 維的表面。
在幾何上,這無法直接視覺化。但在概念上,它就像一片地形:山峰(高損失)、山谷(低損失)、鞍點、高原、山脊、盆地。
梯度作為局部坡度
grad L(w) 是 R^120M 中的一個向量,指向 L 最陡峭的增加方向。將其取反:-grad L(w) 指向最陡峭的下降方向。
單步 AdamW 更新會沿著負梯度方向微調 w(並透過 m 與 v 進行自適應縮放)。從幾何角度來看:這是在表面上沿著下坡方向邁出的一小步,其步長由 lr 控制。
v1 的糟糕盆地
v1 在剛初始化權重時,以峰值學習率(0.0003)邁出了第一步。幾何圖景如下:w_0 處於一個曲率極大的區域(隨機初始化在許多方向上具有高曲率),而峰值學習率的步長使其落入了錯誤的盆地。後續的步驟無法使其脫離。模型因此卡住,不斷輸出「region region region」,因為從它落點出發,該盆地是模型能找到的損失最低的區域。
v2 的熱身路徑
v2 採取 2000 個小步,學習率從 0 緩慢上升至峰值。幾何圖景如下:w_0 首先沿著平滑的方向(曲率較低的方向)緩慢遷移。到了第 2000 步時,w 已移動到一個更易於導航的區域;此時峰值學習率可以將其驅動至更好的盆地,而不會發生超調。
Warmup 是一種幾何感知的初始化協議:讓模型在強力推動之前,先找到一個安全的局部鄰域。
寬盆地與窄盆地
在第 112K 步時,ANDREA-120M 位於一個盆地中。問題是:它有多寬?
寬盆地 = 許多相鄰的權重配置也能達到較低的訓練損失。泛化能力通常較好(盆地寬度預測測試表現;請見 PAC-Bayes 課程,第 3 章)。
狹窄盆地 = 只有一小撮權重能達到低損失。泛化能力往往會受損。
v3 在步驟 112,619 的精修(polish)透過課程擾動(curriculum perturbation)將模型沿著損失表面推動(未重置),使其進入一個更寬的盆地:改變損失函數(不同的多臂老虎機、不同的訓練混合比例),讓 SGD 在新的策略下找到附近的平坦區域。
殭屍懸崖
步驟 112,080 處異常的損失值 0.13 是一個懸崖:一個尖銳且狹窄的區域,其中一個特定的輸入模式(記憶化的 repo-docs 子字串)會產生接近零的損失。模型從較寬的盆地跌落進了一條狹窄的溝壑。Polish-pivot 對 repo-docs 的硬性排除填平了該溝壑,使得 SGD 再也無法找到它。
解讀地形
課程混合作為離散單純形上的行走
什麼是單純形
n 維單純形(具體而言是標準的 (n-1)-單純形)是 n 元組 (w_1, w_2, ..., w_n) 的集合,其中每個 w_i >= 0 且 sum(w_i) = 1。
當 n = 2 時:一條從 (1, 0) 到 (0, 1) 的線段。當 n = 3 時:一個頂點為 (1, 0, 0)、(0, 1, 0)、(0, 0, 1) 的三角形。當 n = 16(ANDREA 的完整資料來源清單)時:一個位於 R^16 內的 15 維單形。
多臂老虎機權重作為單形座標
ANDREA 的多臂老虎機在每個階段針對資料來源產生一個權重向量 w。每個分量 w_i 代表採樣來源 i 的機率。機率是非負的且總和為 1:每個權重向量都位於單形上。
頂點 = 純策略(僅採樣單一來源)。內部 = 混合策略(採樣多個來源,每個來源皆有正機率)。邊 = 僅混合兩個來源。
來源下限作為受限區域
ANDREA 設定了最低權重:hermes3-general 的下限為 0.7(在後處理階段)。這從單純形中切割出一個子區域:只有滿足 w_hermes3-general >= 0.7 的權重向量才是可達的。
從幾何角度來看:下限透過一個超平面切割單純形。可達區域是單純形中位於每個下限超平面正確側的部分。
上限作為另一種限制
ANDREA 也設定了最高權重:dictionary 的上限為 0.25(在後處理階段)。每個上限都是另一個超平面,且可達區域必須位於每個上限超平面的正確側。
完全排除某個來源(上限 = 0.0)是最強的限制:該座標被固定為零,使有效單純形的維度減少一維。
相變作為單形上的行走
每一次相變(每 7-42 步)都會產生一個新的權重向量。每個新向量都是單形上的一個點。在 200K 步中,多臂老虎機(bandit)會在單形的可達區域內追蹤出一條漫長的路徑。
隨機相 = 瞬移到可達區域內的一個均勻隨機點。
老虎機控制的相 = 朝符合下限與上限約束的 UCB 最佳頂點邁進一步。
波蘭樞紐(Polish pivot) = 重新繪製可達區域(新的下限、新的上限、排除部分來源),且行走從新的起點繼續。
為何頂點是危險的
純來源階段(一個 w_i = 1,其餘 = 0)位於單純形(simplex)的頂點。多樣性為零。模型僅在單一分佈上進行訓練。v1 的崩潰部分可追溯至多臂老虎機(bandit)長期駐留在「repo-docs」頂點附近;樣本僅複製了該來源的分佈。
下限(floors)防止頂點駐留:設定 0.7 的下限意味著「絕不讓任何來源的權重低於 0.7」(或是優先來源的特定下限值)。
巡行可達區域
三個來源:hermes3-general (H)、gutenberg (G)、dictionary (D)。約束條件:H 的下限 = 0.5,D 的上限 = 0.25。(隱含條件:所有權重 >= 0,總和為 1,無其他約束。)
在前 20K 步中限制維度
v2 的課程預熱做了什麼
v2 將 curriculum_warmup_sources 設定為七個來源:hermes3-general、hermes3-creative、hermes3-roleplay、chat、smoltalk、oasst、gutenberg。在前 20K 步中,僅有這七個來源提供貢獻。在第 20K 步之後,完整的 16 來源資料流(firehose)才啟動。
幾何解讀
完整的 16 來源單純形(simplex)位於 R^16 中。將來源限制為 7 個,會使 16 個座標中的 9 個歸零。多臂強盜(bandit)的行走發生在一個 6 維的子單純形(sub-simplex)中(比來源數量少一維,這是因為總和為 1 的約束)。
從幾何角度來看:這是完整單純形的一個子流形(SUBMANIFOLD)。維度更低、更平滑、更容易導航。
為什麼這有助於早期訓練
在訓練初期,模型完全尚未學會連貫的語言。多樣化的來源會使其感到困惑:每個來源都有其獨特的風格、詞彙分佈和模式。在隨機初始化時混合 16 個來源,會產生一個過於寬泛的目標分佈,模型無法擬合。
將來源限制為 7 個對話/散文來源,能提供一個更均勻的目標。模型首先學會穩定的表示,然後再進行擴展。
訓練中的幾何路徑
1. 第 0 至 20K 步(熱身階段)。行走路徑位於 6 維子單純形(sub-simplex)上。模型中開始出現穩定的語言模式。
2. 第 20K 至 112K 步(全量數據階段)。行走路徑擴展至 15 維全單純形(full simplex)。領域廣度(domain breadth)開始顯現。
3. 第 112K 步之後(精修階段)。行走路徑再次受限:排除 repo-docs 與 repo-docstrings,並提高對話類數據的下限。這形成全單純形內的一個較小多邊形;對話品質得以鞏固。
為何精修階段設定 curriculum_warmup_steps = 0
精修階段從第 112K 步開始。此時模型已能說通順的語言。若現在限制在子單純形上,將失去廣度卻無任何收益(熱身階段的效益是針對新初始化模型的)。設定 warmup_steps = 0 意謂:保持在全單純形上,但採用新的上限與下限。
三種幾何結構,一次訓練執行
v2 暖機:低維度次單純形。
v2 火龍捲:完整 15 維單純形。
v3 精修:完整單純形,搭配較小的多邊形(更多約束條件)。
相同的 20 萬步訓練執行,三種不同的幾何狀態。每一種都是針對模型成熟度的不同階段進行調優。