Semantiskt avstånd som euklidiskt avstånd
Ett högdimensionellt vektorrum
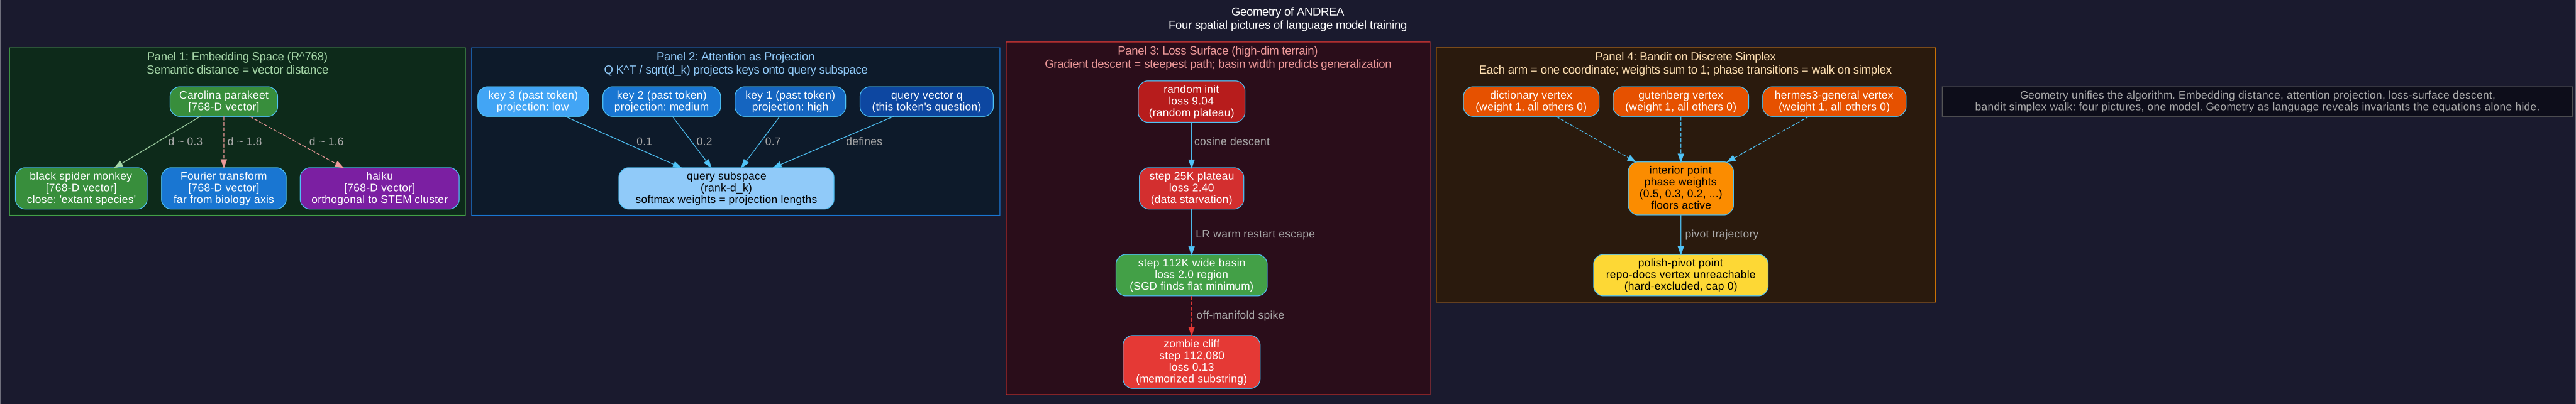
Varje token i ANDREA-120M:s ordförlistan med 8449 token mappas till en punkt i R^768. Tokeninbäddningsmatrisen har formen 8449 x 768: 8449 rader, en per ordförlisttoken; 768 kolumner, en per inbädningsdimension.
Tre egenskaper gör detta till ett vektorrum
1. Addition. v_a + v_b hamnar i R^768. Summan av två inbäddningar är en giltig vektor.
2. Skalarmultiplikation. alpha * v hamnar i R^768 för varje reellt tal alpha. Sträck ut eller krymp längs samma riktning.
3. Linjäritet. alpha v_a + beta v_b hamnar i R^768. Linjära kombinationer stannar inom rummet.
Dessa egenskaper ger oss geometriska verktyg: avstånd, vinkel, projektion, bas, ortogonalitet.
Avstånd som semantisk likhet
Kosinuslikheten mellan två inbäddningar mäter vinkeln mellan dem: cos(theta) = (v_a . v_b) / (||v_a|| * ||v_b||). Intervall: -1 (motsatt) till +1 (parallell).
Empiriskt mönster efter träning: token med liknande kontexter producerar inbäddningar med hög kosinuslikhet. ANDREA-120M placerar parakeet & monkey nära varandra (båda biologiska, båda arter, båda kategorier som är utdöda eller levande). Den placerar Fourier & transform nära varandra (signalbehandlingskontext). Den placerar parakeet & Fourier långt ifrån varandra (ortogonalitet mellan domäner).
Varför R^768 och inte R^384
ANDREA-12M använde d_model = 384. ANDREA-120M fördubblade detta till 768. Fördubblingen är viktig: ett 384-dimensionellt rum har färre tillgängliga 'vinklar', och disambiguering mellan domäner drabbas. Att fördubbla kapaciteten ger modellen utrymme att lösa bank (flod) jämfört med bank (finansiell) till olika bassänger i inbäddningsrummet utan att den ena kollapsar in i den andra.
Uppdateringar av inbäddningar som vektortranslation
Varje gradientsteg lägger till delta_v till v_token. Geometriskt sett: små translationer i R^768 flyttar varje tokens position mot områden som minimerar förlusten. Över 200K steg vandrar varje token från sin slumpmässiga initialisering till en inlärad position.
Beräkna ett avstånd
Tre tränade inbäddningar (förenklade till R^3 för beräkning):
- v(parakeet) = (1.0, 0.5, 0.0)
- v(monkey) = (1.2, 0.3, 0.1)
- v(Fourier) = (0.0, 0.0, 1.5)
Projektion på ett Query-underrum
Vad Attention beräknar
För en token på position t beräknar attention:
softmax(Q K^T / sqrt(d_k)) V
Där Q är frågan (detta tokens fråga), K är nycklarna (varje tidigare tokens identifierare) och V är värdena (varje tidigare tokens innehåll). Utdata blandar V viktat efter hur mycket frågan relaterar till varje nyckel.
Geometrisk tolkning
Tänk på K som en lista av vektorer i R^d_k. Varje rad är ett tidigare tokens nyckel. Q är en vektor i R^d_k: detta tokens fråga.
Q K^T projicerar varje nyckel mot Q. Skalarprodukten q · k_i mäter hur mycket k_i ligger längs q:s riktning. Lång projektion = nyckeln är starkt relevant för frågan. Kort projektion = nyckeln är knappt relevant.
softmax normaliserar projektionerna till vikter som summerar till 1. Den vikta summan av V är en enda vektor: en blandning av tidigare innehåll, viktad efter relevans för den aktuella frågan.
Multi-Head Attention som Multi-Subspace Projection
ANDREA-120M använder 12 uppmärksamhetshuvuden. d_model = 768; d_k = 768 / 12 = 64. Varje huvud projicerar in i ett annat 64-dimensionellt delrum av R^768. Tolv huvuden ger tolv oberoende perspektiv på samma sekvens: ett huvud kan spåra grammatisk roll, ett annat semantisk likhet, ett annat långdistansreferenser.
Geometriskt: varje huvud definierar ett 64-dimensionellt orienterat delrum (ett "fönster") genom vilket det ser det förflutna.
Den kausala masken
Endast-dekoderar-modeller lägger till en kausal mask: varje Q K^T-post ovanför diagonalen sätts till -oändligheten innan softmax. Geometriskt: projektionen mot vilken som helst framtida token får nollvikt. Token t kan endast se token 0 till t.
Varför detta är viktigt: träning och inferens blir symmetriska. Samma framåtgång, samma maskerade projektioner, ingen speciell genereringslogik.
sqrt(d_k)-skalning
Utan skalning växer skalärprodukterna med d_k. Stora skalärprodukter driver softmax in i one-hot-områden (en vikt nära 1, resten nära 0). Att dela med sqrt(d_k) håller projektionerna på en skala med enhetsvarians, vilket bevarar softmax-skärpa över ett brett utbud av d_k-värden.
Geometriskt: sqrt(d_k) normaliserar längderna på projektionerna så att softmax ser jämförbara magnituder oavsett delrumets dimension.
Att läsa en projektion
Tre nycklar och en fråga i R^4 (förenklat för beräkningar):
- q = (1, 0, 1, 0)
- k_1 = (1, 0, 0, 0) [föregående token 1]
- k_2 = (0, 0, 1, 0) [föregående token 2]
- k_3 = (0, 1, 0, 1) [tidigare token 3]
d_k = 4, så sqrt(d_k) = 2.
Gradientdescent som en väg över terrängen
En yta i 120M+1 dimensioner
Varje viktconfiguration för ANDREA-120M är en punkt i R^120,000,000. Förlusten L(w) avbildar varje punkt på ett reellt tal: träningsförlusten vid denna konfiguration. Tillsammans spårar förlustvärdena en (120M+1)-dimensionell yta ovanför parametrarummet.
Geometriskt omöjligt att visualisera direkt. Konceptuellt: en terräng. Berg (hög förlust), dalar (låg förlust), sadelpunkter, platåer, åsar, bäcken.
Gradient som lokal lutning
grad L(w) är en vektor i R^120M som pekar i riktningen av största ökning av L. Genom att negera den: -grad L(w) pekar nedför brantast.
Ett steg med AdamW flyttar w i riktning mot den negativa gradienten (med adaptiv skalning från m och v). Geometriskt: ett litet steg längs ytan, nedför, där stegstorleken styrs av lr.
v1:s dåliga dal
v1 tog sitt första steg vid LR = topp (0,0003) med nyligen initialiserade vikter. Geometrisk bild: w_0 ligger i ett område med extrem krökning (slumpmässig initialisering ger hög krökning i många riktningar), och ett steg med topp-LR landar i fel dal. Följande steg kan inte undkomma. Modellen fastnar och producerar 'region region region' eftersom den dalen har det lägsta förlustvärdet som modellen kan hitta från den position den landade i.
v2:s uppvärmningsväg
v2 tar 2000 små steg där LR ökar gradvis från 0 till toppen. Geometrisk bild: w_0 migrerar först försiktigt längs släta riktningar (där krökningen är låg). Vid steg 2000 har w flyttat sig till ett mer hanterbart område; då kan topp-LR driva den mot en bättre dal utan att skjuta över.
Warmup är ett geometriinformativt initialiseringsprotokoll: låt modellen hitta ett säkert lokalt grannskap innan den pressas hårt.
Breda vs smala dalar
Vid steg 112K befinner sig ANDREA-120M i en dal. Fråga: hur bred är den?
Bred dal = många grannliggande viktkonfigurationar uppnår också låg träningsförlust. Generalisering tenderar att vara god (dalens bredd förutspår testprestation; se lektionen om PAC-Bayes, kapitel 3).
Smal dal = endast en tunn uppsättning vikter uppnår låg förlust. Generaliseringen tenderar att lidas.
v3-polering vid steg 112 619 sköt modellen längs ytan (utan att nollställa) till en bredare dal via kurrikulaförstöring: ändra förlustfunktionen (annan bandit, annan träningsmix), låt SGD hitta ett närliggande platt område under den nya policyn.
Zombieklippan
Den anormala förlusten 0,13 vid steg 112 080 var en KLIPPA: ett skarpt, smalt område där ett specifikt indatamönster (memorerad sträng från repo-dokument) träffar nästan noll förlust. Modellen föll ur den bredare dalen och in i en smal rav. Polish-pivots hårda uteslutning av repo-dokument fyllde i den rav så att SGD inte längre kunde hitta den.
Att läsa terrängen
Kursmix som ett steg på ett diskret simplex
Vad ett simplex är
Ett n-dimensionellt simplex (specifikt det standardiserade (n-1)-simplexet) är mängden av n-tupler (w_1, w_2, ..., w_n) där varje w_i >= 0 & sum(w_i) = 1.
För n = 2: ett linjestycke från (1, 0) till (0, 1). För n = 3: en triangel med hörnen (1, 0, 0), (0, 1, 0) och (0, 0, 1). För n = 16 (ANDREAs fullständiga källförteckning): en 15-dimensionell simplex inbäddad i R^16.
Banditvikt som simplexkoordinater
ANDREAs bandit genererar en vektorvikt w över datakällor vid varje fas. Varje komponent w_i är sannolikheten att urvala källa i. Sannolikheter är icke-negativa och summerar till 1: varje vektorvikt ligger på simplexen.
Hörn = rena strategier (urvala endast en källa). Inre del = blandade strategier (urvala flera källor, var och en med positiv sannolikhet). Kanter = blandningar av endast två källor.
Källgolv som begränsat område
ANDREA sätter minimivikter: hermes3-general med golv 0,7 (efter polering). Detta urkarvar ett delområde av simplex: endast viktvektorer med w_hermes3-general >= 0,7 är nåbara.
Geometriskt: golvet skär simplex med en hyperplan. Det nåbara området är den del av simplex som ligger på rätt sida om varje golvhyperplan.
Tak som den andra begränsningen
ANDREA sätter även maxvikter: dictionary med tak 0,25 (efter polering). Varje tak är en annan hyperplan, & det nåbara området måste ligga på rätt sida om varje takhyperplan också.
Att utesluta en källa helt (tak = 0,0) är det starkaste möjliga taket: koordinaten låses till noll, vilket minskar den effektiva simplex med en dimension.
Fasövergångar som simplexvandringar
Varje fasövergång (varje 7–42 steg) genererar en ny viktvektor. Varje ny vektor är en punkt på simplexet. Över 200 000 steg spårar banditen en lång väg genom simplexets nåbara region.
Slumpmässiga faser = teleportera till en uniformt slumpmässig punkt inom den nåbara regionen.
Banditstyrda faser = stega mot den UCB-bästa hörnpunkten som är kompatibel med golv- och takgränserna.
Polish-pivot = rita om den nåbara regionen (nya golv, nya tak, vissa källor exkluderade) & vandringen fortsätter från den nya startpunkten.
Varför hörnfarliga
Renkällfaserna (där en w_i = 1 och resten = 0) ligger i simplexens hörn. Mångfalden är noll. Modellen tränas på enbart en distribution. v1:s kollaps spåras delvis till att banditen lägerade sig nära hörnet för repo-docs; proverna reproducerade exklusivt den källans distribution.
Golv förhindrar hörnlägering: ett golv på 0,7 betyder 'låt aldrig någon källas vikt sjunka under 0,7' (eller vad som helst golvet är för prioritetskällorna).
Att vandra i det nåbara området
Tre källor: hermes3-general (H), gutenberg (G), dictionary (D). Begränsningar: H-golv = 0,5, D-tak = 0,25. (Implicit: alla vikter >= 0, summerar till 1, inga andra begränsningar.)
Begränsa dimensioner under de första 20K stegen
Vad v2:s kursuppvärmning gjorde
v2 satte curriculum_warmup_sources till sju källor: hermes3-general, hermes3-creative, hermes3-roleplay, chat, smoltalk, oasst, gutenberg. Under de första 20K stegen bidrog ENDAST dessa sju källor. Efter steg 20K aktiverades hela 16-källorsströmmen.
Geometrisk tolkning
Den fullständiga 16-källs-simplexen ligger i R^16. Att begränsa till 7 källor sätter 9 av de 16 koordinaterna till noll. Banditens vandring sker i en 6-dimensionell delsimplex (en mindre än antalet källor, på grund av sum-till-1-begränsningen).
Geometriskt: en DELMÄNGD (submanifold) av den fullständiga simplexen. Lägre dimension, slätare, lättare att navigera i.
Varför detta hjälper under tidig träning
I början av träningen har modellen inte alls lärt sig sammanhängande språk. Många olika källor förvirrar den: varje källa har sin egen stil, sin egen ordfördelning och sitt egna mönster. Att blanda 16 källor vid slumpmässig initiering skapar en målfördelning som är för bred för att modellen ska kunna anpassa sig till den.
Att begränsa till 7 konversationella/prosakällor ger en jämnare målfördelning. Modellen lär sig först en stabil representation och utökas sedan.
Geometrisk väg genom träningen
1. Steg 0 till 20K (uppvärmning). Vandra sker på den 6-dimensionella undersimplexen. Stabila språkliga mönster framträder i modellen.
2. Steg 20K till 112K (fullt dataflöde). Vandret expanderas till den 15-dimensionella fulla simplexen. Domänbredd framträder.
3. Steg 112K och framåt (slipning). Vandret begränsas igen: repo-dokument och repo-dokumentsträngar utesluts, samt konversationella nedre gränser höjs. Mindre polygon i den fulla simplexen; konversationell kvalitet konsolideras.
Varför slipningssetten sätter curriculum_warmup_steps = 0
Slipning inträffar vid steg 112K. Modellen talar redan sammanhängande språk. Att begränsa till en undersimplex nu skulle leda till förlust av bredd utan att ge något nytt (uppvärmningsfördelen är för modeller med ny initialisering). Att sätta warmup_steps = 0 innebär: stanna på den fulla simplexen, men med nya tak och nedre gränser.
Tre geometrier, en träningskörning
v2 uppvärmning: lågdimensionellt undersimplex.
v2 brandhose: fullt 15-dimensionellt simplex.
v3 slipning: fullt simplex med mindre polygon (fler begränsningar).
Samma körning på 200K steg, tre olika geometriska lägen. Varje läge justerades för en annan fas av modellmognaden.