Jarak Semantik sebagai Jarak Euclidean
Ruang Vektor Berdimensi Tinggi
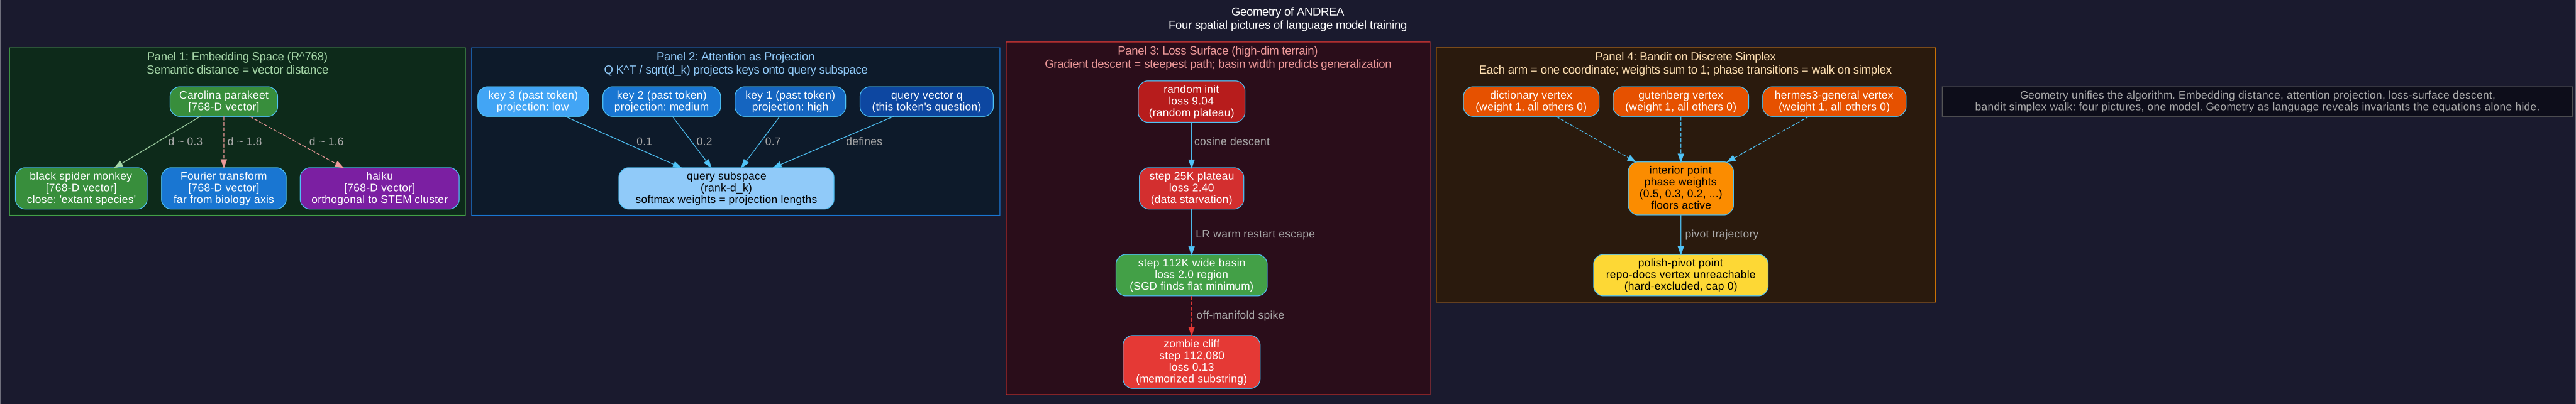
Setiap token dalam kosakata 8449-token dari ANDREA-120M dipetakan ke satu titik dalam R^768. Matriks embedding token memiliki bentuk 8449 x 768: 8449 baris, satu per token kosakata; 768 kolom, satu per dimensi embedding.
Tiga Sifat Membuat Ini Menjadi Ruang Vektor
1. Penjumlahan. v_a + v_b berada di R^768. Jumlah dari dua embedding adalah vektor yang valid.
2. Perkalian skalar. alpha * v berada di R^768 untuk setiap alpha riil. Meregangkan atau mengecilkan sepanjang arah yang sama.
3. Linearitas. alpha v_a + beta v_b berada di R^768. Kombinasi linear tetap berada di dalam ruang tersebut.
Sifat-sifat ini memberi kita alat-alat geometris: jarak, sudut, proyeksi, basis, dan ortogonalitas.
Jarak sebagai Kesamaan Semantik
Kesamaan kosinus dari dua embedding mengukur sudut di antara keduanya: cos(theta) = (v_a . v_b) / (||v_a|| * ||v_b||). Rentang: -1 (berlawanan) hingga +1 (sejajar).
Pola empiris setelah pelatihan: token dengan konteks yang serupa menghasilkan embedding dengan kesamaan kosinus yang tinggi. ANDREA-120M menempatkan parakeet & monkey berdekatan (keduanya biologis, keduanya spesies, keduanya kategori yang ada atau punah). Ia menempatkan Fourier & transform berdekatan (konteks pemrosesan sinyal). Ia menempatkan parakeet & Fourier berjauhan (ortogonalitas lintas domain).
Mengapa R^768 Bukan R^384
ANDREA-12M menggunakan d_model = 384. ANDREA-120M menggandakannya menjadi 768. Penggandaan ini penting: ruang 384-dimensi memiliki lebih sedikit 'sudut' yang tersedia, & disambiguasi lintas domain menjadi terganggu. Penggandaan kapasitas memberi model ruang untuk menyelesaikan bank (sungai) versus bank (keuangan) ke dalam cekungan-cekungan yang berbeda di ruang embedding tanpa yang satu runtuh ke yang lain.
Pembaruan Embedding sebagai Translasi Vektor
Setiap langkah gradien menambahkan delta_v ke v_token. Secara geometris: translasi kecil dalam R^768 menggeser posisi setiap token menuju lingkungan yang mengurangi loss. Selama 200K langkah, setiap token bermigrasi dari inisialisasi acak ke lokasi yang telah dipelajari.
Menghitung Jarak
Tiga embedding yang telah dilatih (disederhanakan ke R^3 untuk perhitungan):
- v(parakeet) = (1.0, 0.5, 0.0)
- v(monkey) = (1.2, 0.3, 0.1)
- v(Fourier) = (0.0, 0.0, 1.5)
Proyeksi ke Subruang Query
Apa yang Dihitung oleh Atensi
Untuk token pada posisi t, atensi menghitung:
softmax(Q K^T / sqrt(d_k)) V
Di mana Q adalah query (pertanyaan token ini), K adalah keys (identitas setiap token sebelumnya), dan V adalah values (konten setiap token sebelumnya). Output mencampurkan V dengan bobot yang ditentukan oleh seberapa besar keterkaitan query dengan setiap key.
Pembacaan Geometris
Anggaplah K sebagai daftar vektor dalam R^d_k. Setiap baris adalah key dari satu token sebelumnya. Q adalah satu vektor dalam R^d_k: pertanyaan dari token ini.
Q K^T memproyeksikan setiap key ke Q. Hasil kali titik q . k_i mengukur seberapa besar k_i berada di sepanjang arah q. Proyeksi panjang = key sangat relevan dengan query. Proyeksi pendek = key hampir tidak relevan.
softmax menormalisasi proyeksi menjadi bobot yang berjumlah 1. Jumlah berbobot dari V adalah satu vektor tunggal: campuran konten masa lalu, yang dibobotkan berdasarkan relevansinya terhadap query saat ini.
Multi-Head Attention sebagai Proyeksi Multi-Subspace
ANDREA-120M menggunakan 12 kepala perhatian. d_model = 768; d_k = 768 / 12 = 64. Setiap kepala memproyeksikan ke subspace 64-dimensi yang berbeda dari R^768. Dua belas kepala memberikan dua belas pandangan independen dari urutan yang sama: satu kepala mungkin melacak peran gramatikal, yang lain kesamaan semantik, dan yang lain lagi referensi jarak jauh.
Secara geometris: setiap kepala mendefinisikan subspace berorientasi 64-dimensi (sebuah 'jendela') yang digunakan untuk memandang masa lalu.
Mask Kausal
Model hanya-decoder menambahkan mask kausal: setiap entri Q K^T di atas diagonal diset ke -infinity sebelum softmax. Secara geometris: proyeksi ke token masa depan apa pun mendapatkan bobot nol. Token t hanya dapat melihat token 0 hingga t.
Mengapa ini penting: pelatihan & inferensi menjadi simetris. Forward pass yang sama, proyeksi ter-mask yang sama, tanpa logika generasi khusus.
Skala sqrt(d_k)
Tanpa penskalaan, hasil kali titik (dot product) tumbuh seiring d_k. Hasil kali titik yang besar mendorong softmax ke wilayah one-hot (satu bobot mendekati 1, sisanya mendekati 0). Membagi dengan sqrt(d_k) menjaga proyeksi pada skala varians satuan, mempertahankan ketajaman softmax di berbagai rentang nilai d_k.
Secara geometris: sqrt(d_k) menormalisasi panjang proyeksi sehingga softmax melihat magnitudo yang sebanding terlepas dari dimensi subruang.
Membaca Proyeksi
Tiga kunci & satu kueri di R^4 (disederhanakan untuk perhitungan):
- q = (1, 0, 1, 0)
- k_1 = (1, 0, 0, 0) [token masa lalu 1]
- k_2 = (0, 0, 1, 0) [token masa lalu 2]
- k_3 = (0, 1, 0, 1) [token masa lalu 3]
d_k = 4, sehingga sqrt(d_k) = 2.
Gradient Descent sebagai Jalur di Atas Medan
Permukaan dalam 120M+1 Dimensi
Setiap konfigurasi bobot dari ANDREA-120M adalah satu titik dalam R^120.000.000. Loss L(w) memetakan setiap titik ke sebuah bilangan real: loss pelatihan pada konfigurasi ini. Secara bersama, nilai-nilai loss membentuk permukaan (120M+1)-dimensi di atas ruang parameter.
Secara geometris, mustahil untuk divisualisasikan secara langsung. Secara konseptual: sebuah medan. Gunung (loss tinggi), lembah (loss rendah), titik pelana, dataran tinggi, punggung, dan cekungan.
Gradient sebagai Kemiringan Lokal
grad L(w) adalah vektor dalam R^120M yang menunjuk ke arah peningkatan TERJEPANG dari L. Menegatkannya: -grad L(w) menunjuk ke arah penurunan paling terjal.
Satu langkah AdamW menggeser w ke arah gradien negatif (dengan penskalaan adaptif dari m & v). Secara geometris: langkah kecil di sepanjang permukaan, menuruni lereng, dengan ukuran langkah yang dikendalikan oleh lr.
Basin Buruk v1
v1 mengambil langkah pertamanya pada LR = puncak (0.0003) dengan bobot yang baru diinisialisasi. Gambaran geometris: w_0 berada di wilayah yang sangat melengkung (inisialisasi acak memiliki kelengkungan tinggi di banyak arah), & langkah pada LR puncak mendarat di basin yang salah. Langkah-langkah berikutnya tidak dapat keluar. Model terjebak menghasilkan 'region region region' karena basin tersebut memiliki loss terendah yang dapat ditemukan model dari tempat ia mendarat.
Jalur Warmup v2
v2 mengambil 2000 langkah kecil dengan LR yang naik dari 0 ke puncak. Gambaran geometris: w_0 pertama-tama bermigrasi secara halus di sepanjang arah yang mulus (di mana kelengkungan rendah). Pada langkah 2000, w telah bergerak ke wilayah yang lebih mudah dinavigasi; LR puncak kemudian dapat mendorongnya menuju basin yang lebih baik tanpa melampaui target.
Warmup adalah protokol inisialisasi yang sadar geometri: biarkan model menemukan lingkungan lokal yang aman sebelum mendorongnya secara agresif.
Cekungan Lebar vs Sempit
Pada langkah 112K, ANDREA-120M berada di dalam sebuah cekungan. Pertanyaannya: seberapa lebar cekungan tersebut?
Cekungan lebar = banyak konfigurasi bobot tetangga juga mencapai loss pelatihan yang rendah. Generalisasi cenderung baik (lebar cekungan memprediksi kinerja uji; lihat pelajaran PAC-Bayes, Bab 3).
Lembah sempit = hanya himpunan bobot tipis yang mencapai loss rendah. Generalisasi cenderung menurun.
Polish v3 pada langkah 112.619 mendorong model di sepanjang permukaan (tanpa reset) ke lembah yang lebih lebar melalui perturbasi kurikulum: ubah fungsi loss (bandit berbeda, campuran pelatihan berbeda), biarkan SGD menemukan daerah datar di dekatnya di bawah kebijakan baru.
Tebing Zombie
Loss anomali 0,13 pada langkah 112.080 adalah sebuah TEPI: daerah tajam dan sempit di mana satu pola input spesifik (substring repo-docs yang dihafal) menghasilkan loss mendekati nol. Model jatuh dari lembah yang lebih luas ke dalam parit sempit. Penghapusan keras repo-docs oleh polish-pivot mengisi parit tersebut sehingga SGD tidak lagi dapat menemukannya.
Membaca Medan
Campuran Kurikulum sebagai Langkah pada Simpleks Diskrit
Apa Itu Simpleks
Simpleks n-dimensi (khususnya simpleks standar (n-1)) adalah himpunan n-tupel (w_1, w_2, ..., w_n) dengan setiap w_i >= 0 & sum(w_i) = 1.
Untuk n = 2: segmen garis dari (1, 0) ke (0, 1). Untuk n = 3: segitiga dengan titik sudut (1, 0, 0), (0, 1, 0), (0, 0, 1). Untuk n = 16 (daftar sumber lengkap ANDREA): simpleks 15-dimensi yang berada di dalam R^16.
Bobot Bandit sebagai Koordinat Simpleks
Bandit ANDREA menghasilkan vektor bobot w atas sumber data pada setiap fase. Setiap komponen w_i adalah probabilitas pengambilan sampel dari sumber i. Probabilitas tidak negatif & berjumlah 1: setiap vektor bobot berada pada simpleks.
Titik sudut = strategi murni (mengambil sampel hanya dari satu sumber). Interior = strategi campuran (mengambil sampel dari beberapa sumber, masing-masing dengan probabilitas positif). Sisi = campuran dari hanya dua sumber.
Lantai Sumber sebagai Wilayah Terbatas
ANDREA menetapkan bobot minimum: hermes3-general pada batas bawah 0,7 (setelah poles). Ini memotong sub-region dari simplex: hanya vektor bobot dengan w_hermes3-general >= 0,7 yang dapat dijangkau.
Secara geometris: batas bawah memotong simplex dengan hiperbidang. Region yang dapat dijangkau adalah bagian dari simplex yang berada di sisi yang benar dari setiap hiperbidang batas bawah.
Batas Atas sebagai Pembatasan Lain
ANDREA juga menetapkan bobot maksimum: dictionary pada batas atas 0,25 (setelah poles). Setiap batas atas adalah hiperbidang lain, & region yang dapat dijangkau harus berada di sisi yang benar dari setiap hiperbidang batas atas juga.
Mengecualikan sumber sepenuhnya (batas atas = 0,0) adalah batas atas yang paling kuat: koordinat tersebut dikunci pada nol, mengurangi dimensi efektif simplex sebesar satu.
Transisi Fase sebagai Langkah pada Simpleks
Setiap transisi fase (setiap 7–42 langkah) menghasilkan vektor bobot baru. Setiap vektor baru adalah sebuah titik pada simpleks. Selama 200K langkah, bandit melacak jalur panjang melalui wilayah yang dapat dijangkau pada simpleks.
Fase acak = teleportasi ke titik acak seragam di dalam wilayah yang dapat dijangkau.
Fase yang dikendalikan bandit = melangkah menuju simpul terbaik UCB yang konsisten dengan batas bawah & batas atas.
Pivot poles = menggambar ulang wilayah yang dapat dijangkau (batas bawah baru, batas atas baru, beberapa sumber dikecualikan), & langkah berlanjut dari titik awal baru.
Mengapa Verteks Berbahaya
Fase sumber murni (satu w_i = 1, sisanya = 0) berada di verteks simpleks. Keragamannya nol. Model dilatih hanya pada satu distribusi. Keruntuhan v1 sebagian ditelusuri ke bandit yang berkemah di dekat verteks repo-docs; sampel mereproduksi distribusi sumber tersebut secara eksklusif.
Lantai (floors) mencegah berkemah di verteks: lantai pada 0,7 berarti 'jangan pernah biarkan bobot sumber mana pun turun di bawah 0,7' (atau apa pun lantai untuk sumber prioritas).
Berjalan di Wilayah yang Dapat Dijangkau
Tiga sumber: hermes3-general (H), gutenberg (G), dictionary (D). Batasan: lantai H = 0,5, batas atas (cap) D = 0,25. (Implisit: semua bobot >= 0, berjumlah 1, tidak ada batasan lain.)
Membatasi Dimensi untuk 20K Langkah Pertama
Apa yang Dilakukan Pemanasan Kurikulum v2
v2 mengatur curriculum_warmup_sources menjadi tujuh sumber: hermes3-general, hermes3-creative, hermes3-roleplay, chat, smoltalk, oasst, gutenberg. Untuk 20K langkah pertama, HANYA ketujuh sumber tersebut yang berkontribusi. Setelah langkah 20K, seluruh 16 sumber aktif sepenuhnya.
Pembacaan Geometris
Simpleks penuh 16-sumber berada di R^16. Membatasi ke 7 sumber meruntuhkan 9 dari 16 koordinat menjadi nol. Jalan bandit berlangsung dalam sub-simpleks 6-dimensi (satu kurang dari jumlah sumber, akibat kendala jumlah-ke-1).
Secara geometris: sebuah SUBMANIFOLD dari simpleks penuh. Berdimensi lebih rendah, lebih halus, dan lebih mudah dinavigasi.
Mengapa Ini Membantu Pelatihan Awal
Di awal pelatihan, model sama sekali belum mempelajari bahasa yang koheren. Sumber-sumber yang beragam membingungkannya: setiap sumber memiliki gaya, distribusi kosakata, dan polanya masing-masing. Mencampur 16 sumber pada inisialisasi acak menciptakan distribusi target yang terlalu luas sehingga tidak dapat dikepas oleh model.
Membatasi ke 7 sumber percakapan/prosa memberikan target yang lebih seragam. Model mempelajari representasi yang stabil terlebih dahulu, lalu memperluasnya.
Jalur Geometris Melalui Pelatihan
1. Langkah 0 hingga 20K (pemanasan). Langkah berjalan di atas sub-simpleks 6-D. Pola bahasa yang stabil muncul dalam model.
2. Langkah 20K hingga 112K (seluruh data). Langkah meluas ke simpleks penuh 15-D. Luasnya domain muncul.
3. Langkah 112K ke atas (penyempurnaan). Langkah dibatasi lagi: repo-docs & repo-docstrings dikecualikan, lantai percakapan dinaikkan. Poligon yang lebih kecil di dalam simpleks penuh; kualitas percakapan terkonsolidasi.
Mengapa Set Penyempurnaan Mengatur curriculum_warmup_steps = 0
Penyempurnaan dimulai pada langkah 112K. Model sudah berbicara dengan bahasa yang koheren. Membatasi ke sub-simpleks sekarang akan kehilangan keluasan tanpa mendapatkan apa-apa (manfaat pemanasan adalah untuk model dengan inisialisasi baru). Mengatur warmup_steps = 0 berarti: tetap di simpleks penuh, tetapi dengan batas atas & bawah baru.
Tiga Geometri, Satu Jalur Pelatihan
Pemanasan v2: sub-simpleks berdimensi rendah.
Firehose v2: simpleks 15-D penuh.
Poles v3: simpleks penuh dengan poligon lebih kecil (lebih banyak kendala).
Jalur pelatihan 200K langkah yang sama, tiga rezim geometris yang berbeda. Masing-masing disetel untuk fase kematangan model yang berbeda.