Distância Semântica como Distância Euclidiana
Um Espaço Vetorial de Alta Dimensão
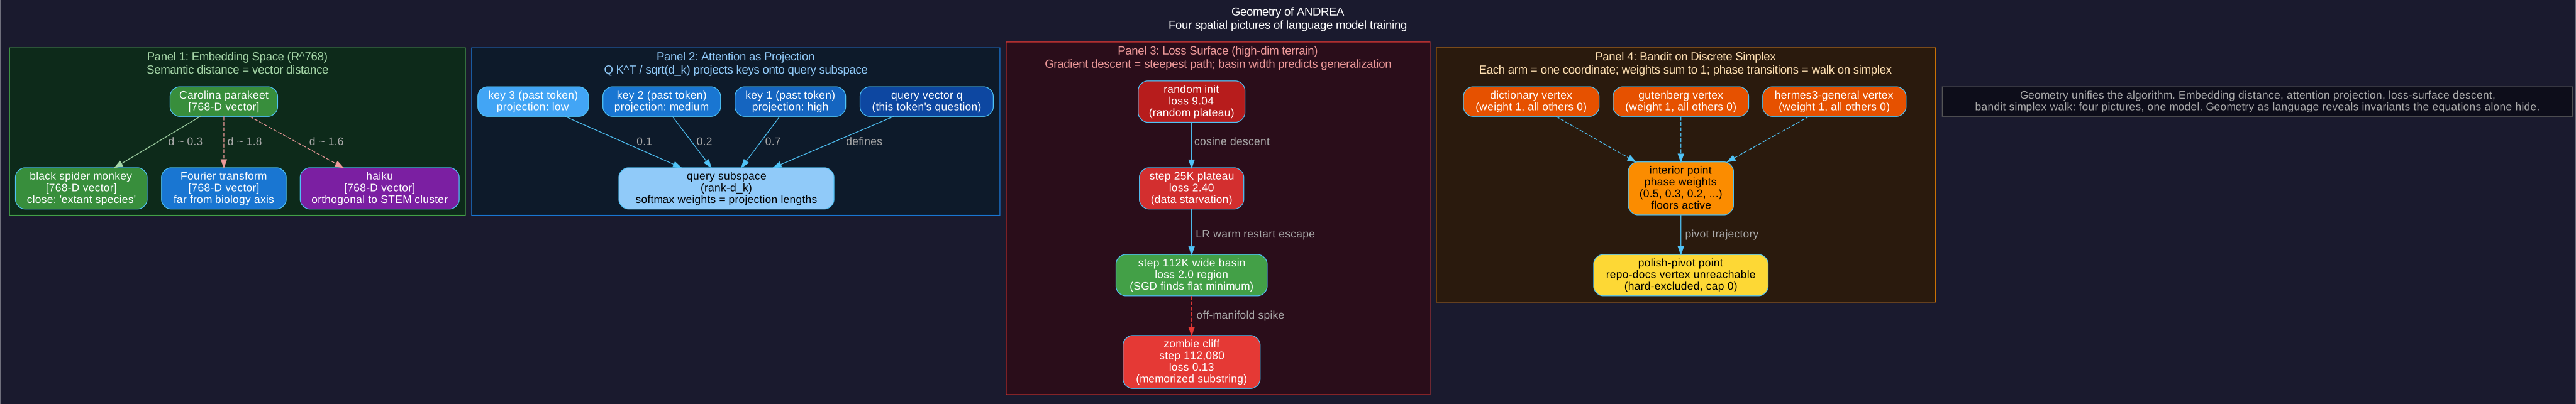
Cada token no vocabulário de 8449 tokens do ANDREA-120M mapeia para um ponto em R^768. A matriz de incorporação de tokens tem forma 8449 x 768: 8449 linhas, uma por token do vocabulário; 768 colunas, uma por dimensão de incorporação.
Três Propriedades Tornam Isso um Espaço Vetorial
1. Adição. v_a + v_b resulta em R^768. A soma de dois embeddings é um vetor válido.
2. Multiplicação escalar. alpha * v resulta em R^768 para qualquer alpha real. Esticar ou encolher ao longo da mesma direção.
3. Linearidade. alpha v_a + beta v_b resulta em R^768. Combinações lineares permanecem dentro do espaço.
Essas propriedades nos dão ferramentas geométricas: distância, ângulo, projeção, base, ortogonalidade.
Distância como Similaridade Semântica
A similaridade cosseno de dois embeddings mede o ângulo entre eles: cos(theta) = (v_a . v_b) / (||v_a|| * ||v_b||). Intervalo: -1 (oposto) a +1 (paralelo).
Padrão empírico após o treinamento: tokens com contextos semelhantes produzem embeddings com alta similaridade cosseno. O ANDREA-120M posiciona parakeet e monkey próximos entre si (ambos biológicos, ambos espécies, ambos em categorias de extintos ou existentes). Ele posiciona Fourier e transform próximos entre si (contexto de processamento de sinais). Ele posiciona parakeet e Fourier distantes entre si (ortogonalidade entre domínios).
Por que R^768 e não R^384
O ANDREA-12M usou d_model = 384. O ANDREA-120M dobrou para 768. O dobro é importante: um espaço de 384 dimensões tem menos 'ângulos' disponíveis, e a desambiguação entre domínios sofre. Dobrar a capacidade dá ao modelo espaço para resolver bank (rio) versus bank (financeiro) em bacias diferentes do espaço de embeddings, sem que um colapse no outro.
Atualizações de Incorporação como Tradução Vetorial
Cada passo do gradiente adiciona delta_v a v_token. Geometricamente: pequenas traduções em R^768 deslocam a posição de cada token em direção a vizinhanças que reduzem a perda. Ao longo de 200 mil passos, cada token migra de sua inicialização aleatória para uma posição aprendida.
Calculando uma Distância
Três incorporações treinadas (simplificadas para R^3 para fins de cálculo):
- v(quetzal) = (1.0, 0.5, 0.0)
- v(macaco) = (1.2, 0.3, 0.1)
- v(Fourier) = (0.0, 0.0, 1.5)
Projeção em um Subespaço de Consulta
O que a Atenção Calcula
Para um token na posição t, a atenção calcula:
softmax(Q K^T / sqrt(d_k)) V
Onde Q é a consulta (a pergunta deste token), K são as chaves (o identificador de cada token anterior) e V são os valores (o conteúdo de cada token anterior). A saída mistura V ponderado pelo grau em que a consulta se relaciona com cada chave.
Leitura Geométrica
Pense em K como uma lista de vetores em R^d_k. Cada linha é a chave de um token anterior. Q é um vetor em R^d_k: a pergunta deste token.
Q K^T projeta cada chave sobre Q. O produto escalar q . k_i mede o quanto k_i se alinha à direção de q. Projeção longa = chave fortemente relevante para a consulta. Projeção curta = chave pouco relevante.
softmax normaliza as projeções em pesos que somam 1. A soma ponderada de V é um único vetor: uma mistura do conteúdo passado, ponderada pela relevância para a consulta atual.
Atenção Multi-Cabeça como Projeção em Multi-Subespaços
ANDREA-120M usa 12 cabeças de atenção. d_model = 768; d_k = 768 / 12 = 64. Cada cabeça projeta em um subespaço de 64 dimensões diferente de R^768. Doze cabeças fornecem doze visões independentes da mesma sequência: uma cabeça pode rastrear o papel gramatical, outra a semelhança semântica, outra referências de longo alcance.
Geometricamente: cada cabeça define um subespaço orientado de 64 dimensões (uma 'janela') através do qual ela observa o passado.
A Máscara Causal
Modelos apenas de decodificador adicionam uma máscara causal: cada entrada de Q K^T acima da diagonal é definida como -infinito antes do softmax. Geometricamente: a projeção sobre qualquer token futuro recebe peso zero. O token t só pode ver os tokens de 0 a t.
Por que isso é importante: o treinamento e a inferência tornam-se simétricos. O mesmo passo de frente, as mesmas projeções mascaradas, sem lógica especial de geração.
Escalonamento por sqrt(d_k)
Sem o escalonamento, os produtos escalares crescem com d_k. Produtos escalares grandes empurram o softmax para regiões one-hot (um peso próximo de 1, o resto próximo de 0). Dividir por sqrt(d_k) mantém as projeções em uma escala de variância unitária, preservando a nitidez do softmax em uma ampla faixa de valores de d_k.
Geometricamente: sqrt(d_k) normaliza os comprimentos das projeções para que o softmax veja magnitudes comparáveis, independentemente da dimensão do subespaço.
Lendo uma Projeção
Três chaves e uma consulta em R^4 (simplificado para aritmética):
- q = (1, 0, 1, 0)
- k_1 = (1, 0, 0, 0) [token passado 1]
- k_2 = (0, 0, 1, 0) [token passado 2]
- k_3 = (0, 1, 0, 1) [token passado 3]
d_k = 4, portanto sqrt(d_k) = 2.
Descida do Gradiente como Caminho em um Terreno
Uma Superfície em 120M+1 Dimensões
Cada configuração de pesos da ANDREA-120M é um ponto em R^120.000.000. A perda L(w) mapeia cada ponto para um número real: a perda de treinamento nesta configuração. Juntos, os valores de perda traçam uma superfície de (120M+1) dimensões acima do espaço de parâmetros.
Geometricamente impossível de visualizar diretamente. Conceitualmente: um terreno. Montanhas (perda alta), vales (perda baixa), pontos de sela, platôs, cristas, bacias.
Gradiente como Inclinação Local
grad L(w) é um vetor em R^120M apontando na direção de maior AUMENTO de L. Negando-o: -grad L(w) aponta para a descida mais íngreme.
Um passo do AdamW desloca w na direção do gradiente negativo (com escala adaptativa de m e v). Geometricamente: um pequeno passo ao longo da superfície, em direção à descida, com o tamanho do passo controlado pelo lr.
O Mau Bacia da v1
A v1 deu seu primeiro passo com LR = pico (0.0003) em pesos recém-inicializados. Imagem geométrica: w_0 está em uma região de curvatura extrema (a inicialização aleatória tem alta curvatura em muitas direções), e um passo com LR no pico cai na bacia errada. Os passos subsequentes não conseguem escapar. O modelo fica preso produzindo 'região região região' porque essa bacia tem a menor perda que o modelo consegue encontrar a partir do ponto onde ele caiu.
O Caminho de Aquecimento da v2
A v2 dá 2000 pequenos passos com o LR aumentando gradualmente de 0 para o pico. Imagem geométrica: w_0 primeiro migra suavemente ao longo de direções suaves (onde a curvatura é baixa). No passo 2000, w já se moveu para uma região mais navegável; o LR no pico pode então impulsioná-lo em direção a uma bacia melhor sem ultrapassá-la.
O aquecimento (warmup) é um protocolo de inicialização consciente da geometria: permite que o modelo encontre um vizinhança local segura antes de ser pressionado com força total.
Bacias Largas vs. Estreitas
No passo 112K, o ANDREA-120M está em uma bacia. Pergunta: quão larga ela é?
Bacia larga = muitas configurações de pesos vizinhas também alcançam baixa perda de treinamento. A generalização tende a ser boa (a largura da bacia prevê o desempenho de teste; veja a lição sobre PAC-Bayes, Capítulo 3).
Bacia estreita = apenas um conjunto fino de pesos alcança baixa perda. A generalização tende a sofrer.
O refinamento da v3 no passo 112.619 empurrou o modelo ao longo da superfície (sem reinicialização) para uma bacia mais larga via perturbação curricular: mudar a função de perda (diferente bandit, diferente mix de treinamento), permitindo que o SGD encontre uma região plana próxima sob a nova política.
O Penhasco Zumbi
A perda anômala de 0,13 no passo 112.080 foi um PENHASCO: uma região aguda e estreita onde um padrão de entrada específico (subsequência memorizada de docs do repositório) atinge perda quase zero. O modelo caiu da bacia mais ampla para um desfiladeiro estreito. A exclusão rígida de docs do repositório pelo pivot de refinamento preencheu esse desfiladeiro, de modo que o SGD não pôde mais encontrá-lo.
Lendo o Terreno
Mistura de Currículo como uma Caminhada em um Simples Discreto
O que é um Simples
Um simples de n dimensões (especificamente o simples padrão (n-1)) é o conjunto de n-tuplas (w_1, w_2, ..., w_n) com cada w_i >= 0 & sum(w_i) = 1.
Para n = 2: um segmento de reta de (1, 0) a (0, 1). Para n = 3: um triângulo com vértices (1, 0, 0), (0, 1, 0), (0, 0, 1). Para n = 16 (lista completa de fontes da ANDREA): um simplex de 15 dimensões situado dentro de R^16.
Pesos do Bandit como Coordenadas do Simplex
O bandit da ANDREA produz um vetor de pesos w sobre as fontes de dados em cada fase. Cada componente w_i é a probabilidade de amostrar a fonte i. As probabilidades são não negativas e somam 1: todo vetor de pesos reside no simplex.
Vértices = estratégias puras (amostrar apenas uma fonte). Interior = estratégias mistas (amostrar múltiplas fontes, cada uma com probabilidade positiva). Arestas = misturas de apenas duas fontes.
Limites Inferiores das Fontes como Região Restrita
ANDREA impõe pesos mínimos: hermes3-general com piso de 0,7 (pós-polimento). Isso delimita uma sub-região do simplesso: apenas vetores de pesos com w_hermes3-general >= 0,7 são alcançáveis.
Geometricamente: o piso corta o simplesso com um hiperplano. A região alcançável é a parte do simplesso do lado correto de cada hiperplano de piso.
Limites como a Outra Restrição
ANDREA também impõe pesos máximos: dictionary com limite de 0,25 (pós-polimento). Cada limite é outro hiperplano, e a região alcançável deve estar do lado correto de cada hiperplano de limite também.
Excluir uma fonte completamente (limite = 0,0) é o limite mais forte possível: a coordenada fica fixada em zero, reduzindo o simplesso efetivo em uma dimensão.
Transições de Fase como Percursos no Simples
Cada transição de fase (a cada 7–42 passos) produz um novo vetor de pesos. Cada novo vetor é um ponto no simples. Ao longo de 200 mil passos, o bandit traça um longo caminho pela região alcançável do simples.
Fases aleatórias = teleporte para um ponto uniformemente aleatório dentro da região alcançável.
Fases controladas pelo bandit = passo em direção ao vértice com melhor UCB, consistente com os pisos e tetos.
Pivô de polimento = redesenha a região alcançável (novos pisos, novos tetos, algumas fontes excluídas), e o percurso continua a partir do novo ponto de partida.
Por que os Vértices São Perigosos
Fases de fonte pura (um w_i = 1, o resto = 0) estão nos vértices do simples. A diversidade é zero. O modelo é treinado em apenas uma distribuição. O colapso da v1 foi parcialmente atribuído ao bandit acampando perto do vértice de repositório-documentos; as amostras reproduziam exclusivamente a distribuição daquela fonte.
Pisos (floors) impedem o acampamento em vértices: um piso em 0,7 diz "nunca deixe o peso de nenhuma fonte cair abaixo de 0,7" (ou seja qual for o piso para as fontes prioritárias).
Percorrendo a Região Alcancável
Três fontes: hermes3-general (H), gutenberg (G), dicionário (D). Restrições: piso de H = 0,5, teto (cap) de D = 0,25. (Implícito: todos os pesos >= 0, somam 1, sem outras restrições.)
Restringindo Dimensões para os Primeiros 20K Passos
O que o Aquecimento de Currículo da v2 Fez
A v2 definiu curriculum_warmup_sources para sete fontes: hermes3-general, hermes3-creative, hermes3-roleplay, chat, smoltalk, oasst, gutenberg. Para os primeiros 20K passos, SOMENTE aquelas sete fontes contribuíram. Após o passo 20K, o jato completo de 16 fontes foi ativado.
Leitura Geométrica
O simplex completo de 16 fontes reside em R^16. Ao restringir a 7 fontes, 9 das 16 coordenadas são reduzidas a zero. A caminhada do bandit ocorre em um sub-simplex de 6 dimensões (uma a menos que o número de fontes, devido à restrição de soma igual a 1).
Geometricamente: um SUBMANIFOLDO do simplex completo. De menor dimensão, mais suave e mais fácil de navegar.
Por que isso ajuda no início do treinamento
No início do treinamento, o modelo ainda não aprendeu linguagem coerente de forma alguma. Fontes diversas o confundem: cada fonte tem seu próprio estilo, sua própria distribuição de vocabulário e seu próprio padrão. Misturar 16 fontes na inicialização aleatória cria uma distribuição de alvo muito ampla que o modelo não consegue ajustar.
Restringir a 7 fontes conversacionais/prosa fornece um alvo mais uniforme. O modelo aprende primeiro uma representação estável e, em seguida, expande.
Caminho Geométrico Através do Treinamento
1. Passos 0 a 20K (aquecimento). A caminhada ocorre no sub-simplicial de 6 dimensões. Padrões de linguagem estáveis emergem no modelo.
2. Passos 20K a 112K (jato completo). A caminhada se expande para o simplicial completo de 15 dimensões. A amplitude de domínio emerge.
3. A partir do passo 112K (polimento). A caminhada é novamente restrita: repositório-documentos e repositório-docstrings são excluídos, e os pisos conversacionais são elevados. Um polígono menor no simplicial completo; a qualidade conversacional se consolida.
Por que o Conjunto de Polimento define curriculum_warmup_steps = 0
O polimento entra no passo 112K. O modelo já fala uma linguagem coerente. Restringir a um sub-simplicial agora resultaria em perda de amplitude sem ganhos (o benefício do aquecimento é para modelos de inicialização nova). Definir warmup_steps = 0 significa: permanecer no simplicial completo, mas com novos tetos e pisos.
Três Geometrias, Uma Execução de Treinamento
Aquecimento v2: sub-simplicial de baixa dimensão.
Firehose v2: simplicial completo de 15 dimensões.
Refinamento v3: simplicial completo com polígono menor (mais restrições).
A mesma execução de 200 mil passos, três diferentes regimes geométricos. Cada um foi ajustado para uma fase diferente de maturidade do modelo.