La distanza semantica come distanza euclidea
Uno spazio vettoriale ad alta dimensionalità
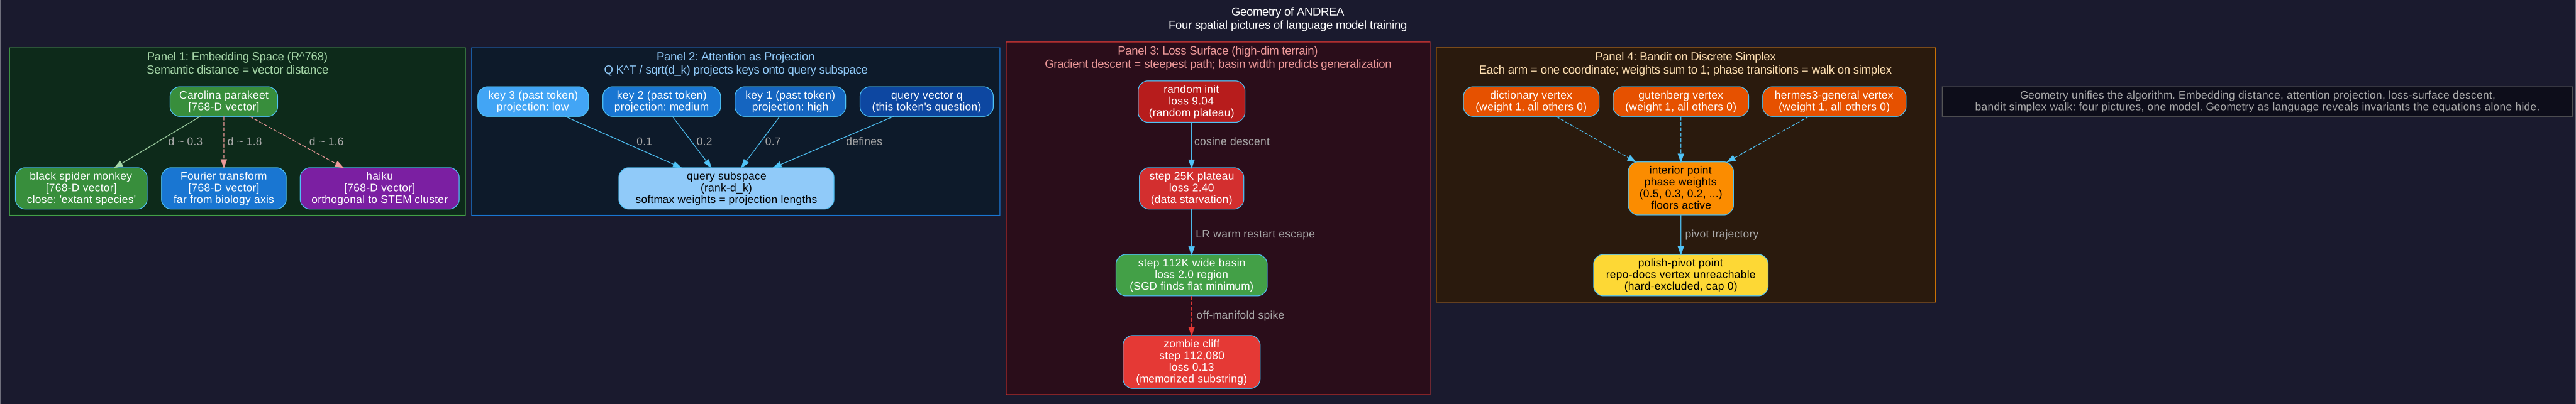
Ogni token nel vocabolario di 8449 token di ANDREA-120M viene mappato su un punto in R^768. La matrice delle rappresentazioni dei token ha forma 8449 x 768: 8449 righe, una per ogni token del vocabolario; 768 colonne, una per ogni dimensione della rappresentazione.
Tre proprietà rendono questo uno spazio vettoriale
1. Addizione. v_a + v_b appartiene a R^768. La somma di due embedding è un vettore valido.
2. Moltiplicazione per uno scalare. alpha * v appartiene a R^768 per qualsiasi alpha reale. Allunga o riduci lungo la stessa direzione.
3. Linearità. alpha v_a + beta v_b appartiene a R^768. Le combinazioni lineari restano all'interno dello spazio.
Queste proprietà ci forniscono strumenti geometrici: distanza, angolo, proiezione, base, ortogonalità.
Distanza come Similarità Semantica
La similarità coseno di due embedding misura l'angolo tra loro: cos(theta) = (v_a . v_b) / (||v_a|| * ||v_b||). Intervallo: -1 (opposti) a +1 (paralleli).
Pattern empirico dopo l'addestramento: i token con contesti simili producono embedding con alta similarità coseno. ANDREA-120M posiziona parakeet e monkey vicini tra loro (entrambi biologici, entrambi specie, entrambi nelle categorie di estinti o viventi). Posiziona Fourier e transform vicini tra loro (contesto di elaborazione del segnale). Posiziona parakeet e Fourier lontani (ortogonalità tra domini).
Perché R^768 e non R^384
ANDREA-12M utilizzava d_model = 384. ANDREA-120M lo ha raddoppiato a 768. Il raddoppio è importante: uno spazio di 384 dimensioni ha meno 'angoli' disponibili e la disambiguazione tra domini ne risente. Raddoppiare la capacità offre al modello lo spazio per risolvere bank (fiume) e bank (finanziario) in bacini distinti dello spazio di embedding, senza che uno collassi nell'altro.
Aggiornamenti degli Embedding come Traduzione Vettoriale
Ogni passo di gradiente aggiunge delta_v a v_token. Geometricamente: piccole traslazioni in R^768 spostano la posizione di ogni token verso vicinanza che riduce la perdita. Nel corso di 200K passi, ogni token migra dalla sua inizializzazione casuale a una posizione appresa.
Calcolo di una Distanza
Tre embedding addestrati (semplificati in R^3 per l'aritmetica):
- v(parakeet) = (1.0, 0.5, 0.0)
- v(monkey) = (1.2, 0.3, 0.1)
- v(Fourier) = (0.0, 0.0, 1.5)
Proiezione su un sottospazio di Query
Cosa calcola l'attenzione
Per un token nella posizione t, l'attenzione calcola:
softmax(Q K^T / sqrt(d_k)) V
Dove Q è la query (la domanda di questo token), K sono le chiavi (l'identificativo di ogni token precedente) e V sono i valori (il contenuto di ogni token precedente). L'output mescola V pesando in base a quanto la query è correlata a ciascuna chiave.
Lettura geometrica
Pensa a K come a una lista di vettori in R^d_k. Ogni riga è la chiave di un token precedente. Q è un vettore in R^d_k: la domanda di questo token.
Q K^T proietta ogni chiave su Q. Il prodotto scalare q . k_i misura quanto k_i giace lungo la direzione di q. Proiezione lunga = chiave fortemente rilevante per la query. Proiezione corta = chiave poco rilevante.
softmax normalizza le proiezioni in pesi che sommano a 1. La somma pesata di V è un singolo vettore: una miscela dei contenuti passati, pesata in base alla rilevanza rispetto alla query corrente.
Multi-Head Attention come Proiezione Multi-Sottospazio
ANDREA-120M utilizza 12 teste di attenzione. d_model = 768; d_k = 768 / 12 = 64. Ogni testa proietta in un diverso sottospazio di dimensione 64 di R^768. Dodici teste forniscono dodici viste indipendenti della stessa sequenza: una testa potrebbe tracciare il ruolo grammaticale, un'altra la similarità semantica, un'altra ancora i riferimenti a lungo raggio.
Geometricamente: ogni testa definisce un sottospazio orientato di dimensione 64 (una 'finestra') attraverso cui osserva il passato.
La Maschera Causale
I modelli solo-decoder aggiungono una maschera causale: ogni voce di Q K^T sopra la diagonale viene impostata a -infinito prima del softmax. Geometricamente: la proiezione su qualsiasi token futuro riceve peso zero. Il token t può vedere solo i token da 0 a t.
Perché è importante: addestramento e inferenza diventano simmetrici. Stesso passaggio in avanti, stesse proiezioni mascherate, nessuna logica di generazione speciale.
Scalatura sqrt(d_k)
Senza scalatura, i prodotti scalari crescono con d_k. I grandi prodotti scalari spingono il softmax in regioni one-hot (un peso vicino a 1, il resto vicino a 0). Dividendo per sqrt(d_k), si mantengono le proiezioni su una scala di varianza unitaria, preservando la nitidezza del softmax su un'ampia gamma di valori di d_k.
Geometricamente: sqrt(d_k) normalizza le lunghezze delle proiezioni in modo che il softmax veda magnitudini confrontabili indipendentemente dalla dimensione del sottospazio.
Lettura di una Proiezione
Tre chiavi e una query in R^4 (semplificate per i calcoli):
- q = (1, 0, 1, 0)
- k_1 = (1, 0, 0, 0) [token passato 1]
- k_2 = (0, 0, 1, 0) [token passato 2]
- k_3 = (0, 1, 0, 1) [token passato 3]
d_k = 4, quindi sqrt(d_k) = 2.
Discesa del gradiente come percorso su un terreno
Una superficie in 120M+1 dimensioni
Ogni configurazione dei pesi di ANDREA-120M è un punto in R^120.000.000. La perdita L(w) mappa ogni punto a un numero reale: la perdita di addestramento per questa configurazione. Insieme, i valori di perdita tracciano una superficie di (120M+1) dimensioni sopra lo spazio dei parametri.
Geometricamente impossibile da visualizzare direttamente. Concettualmente: un terreno. Montagne (perdita alta), valli (perdita bassa), punti sella, pianori, creste, bacini.
Gradiente come pendenza locale
grad L(w) è un vettore in R^120M che punta nella direzione di massima AUMENTO di L. Negandolo: -grad L(w) punta nella direzione di massima discesa.
Un passo di AdamW sposta w nella direzione opposta al gradiente (con scalatura adattiva da m e v). Geometricamente: un piccolo passo lungo la superficie, in discesa, con la dimensione del passo controllata da lr.
Il cattivo bacino di v1
v1 ha fatto il suo primo passo con LR = picco (0.0003) su pesi appena inizializzati. Immagine geometrica: w_0 si trova in una regione fortemente curva (l'inizializzazione casuale presenta alta curvatura in molte direzioni) e un passo con LR al picco atterra nel bacino sbagliato. I passi successivi non riescono a sfuggirne. Il modello si blocca producendo 'region region region' perché quel bacino ha la perdita più bassa che il modello può trovare dal punto in cui è atterrato.
Il percorso di warmup di v2
v2 compie 2000 piccoli passi con LR che sale gradualmente da 0 al picco. Immagine geometrica: w_0 si sposta prima dolcemente lungo direzioni lisce (dove la curvatura è bassa). Al passo 2000, w si è spostato in una regione più navigabile; l'LR al picco può quindi guidarlo verso un bacino migliore senza andare oltre.
Il warmup è un protocollo di inizializzazione consapevole della geometria: lascia che il modello trovi un vicinato locale sicuro prima di spingerlo al massimo.
Bacini ampi vs stretti
Al passo 112K, ANDREA-120M si trova in un bacino. Domanda: quanto è ampio?
Bacino ampio = molte configurazioni di pesi vicine raggiungono anch'esse una bassa perdita di addestramento. La generalizzazione tende ad essere buona (l'ampiezza del bacino predice le prestazioni di test; vedere la lezione su PAC-Bayes, Capitolo 3).
Conca stretta = solo un insieme sottile di pesi raggiunge una perdita bassa. La generalizzazione tende a risentirne.
La rifinitura v3 al passo 112.619 ha spinto il modello lungo la superficie (senza azzerare) verso una conca più ampia tramite perturbazione curricolare: si modifica la funzione di perdita (diverso bandit, diversa miscela di addestramento), lasciando che la SGD trovi una regione piana vicina sotto la nuova politica.
La Scogliera dello Zombi
La perdita anomala 0.13 al passo 112.080 era una SCOGLIERA: una regione ripida e stretta in cui un specifico pattern di input (sottosequenza memorizzata dei repo-docs) produce una perdita quasi nulla. Il modello è caduto dalla conca più ampia in un stretto solco. L'esclusione rigida dei repo-docs nella pivot di rifinitura ha riempito quel solco, impedendo alla SGD di trovarlo di nuovo.
Lettura del Terreno
La Miscela del Programma come una Camminata su un Simplex Discreto
Cos'è un Simplex
Un simplex n-dimensionale (specificamente lo simplex standard (n-1)) è l'insieme di n-uple (w_1, w_2, ..., w_n) con ogni w_i >= 0 & sum(w_i) = 1.
Per n = 2: un segmento di retta da (1, 0) a (0, 1). Per n = 3: un triangolo con vertici (1, 0, 0), (0, 1, 0), (0, 0, 1). Per n = 16 (l'elenco completo delle fonti di ANDREA): un semplice di dimensione 15 situato all'interno di R^16.
I pesi del bandit come coordinate del semplice
Il bandit di ANDREA produce un vettore di pesi w sulle fonti di dati in ogni fase. Ogni componente w_i è la probabilità di campionare la fonte i. Le probabilità sono non negative e sommano a 1: ogni vettore di pesi si trova sul semplice.
Vertici = strategie pure (campiona solo una fonte). Interno = strategie miste (campiona più fonti, ciascuna con probabilità positiva). Spigoli = miscele di solo due fonti.
I limiti minimi delle fonti come regione ristretta
ANDREA impone pesi minimi: hermes3-general con limite inferiore 0,7 (dopo la rifinitura). Questo delimita una sotto-regione del semplice: sono raggiungibili solo i vettori di peso con w_hermes3-general >= 0,7.
Geometricamente: il limite inferiore taglia il semplice con un iperpiano. La regione raggiungibile è la parte del semplice situata sul lato corretto di ogni iperpiano di limite inferiore.
I limiti massimi come altra restrizione
ANDREA impone anche pesi massimi: dictionary con limite superiore 0,25 (dopo la rifinitura). Ogni limite superiore è un altro iperpiano, e la regione raggiungibile deve trovarsi anche sul lato corretto di ogni iperpiano di limite superiore.
Escludere completamente una sorgente (limite superiore = 0,0) è il limite superiore più forte possibile: la coordinata viene fissata a zero, riducendo il semplice effettivo di una dimensione.
Transizioni di fase come camminate sul semplice
Ogni transizione di fase (ogni 7-42 passi) produce un nuovo vettore di pesi. Ogni nuovo vettore è un punto sul semplice. Nel corso di 200K passi, il bandit traccia un lungo percorso attraverso la regione raggiungibile del semplice.
Fasi casuali = teletrasporto a un punto uniformemente casuale all'interno della regione raggiungibile.
Fasi controllate dal bandit = passo verso il vertice UCB-ottimale coerente con i limiti inferiori e superiori.
Pivot di rifinitura = ridisegno della regione raggiungibile (nuovi limiti inferiori, nuovi limiti superiori, alcune fonti escluse) e la camminata continua dal nuovo punto di partenza.
Perché i Vertici Sono Pericolosi
Le fasi a fonte pura (un w_i = 1, il resto = 0) si trovano ai vertici del semplice. La diversità è zero. Il modello si addestra su un'unica distribuzione. Il collasso di v1 è stato in parte ricondotto al bandit che si accampava vicino al vertice repo-docs; i campioni riproducevano esclusivamente la distribuzione di quella fonte.
I limiti inferiori (floors) prevengono l'accampamento ai vertici: un limite inferiore a 0,7 significa 'non far mai scendere il peso di una fonte sotto 0,7' (o qualunque sia il limite inferiore per le fonti prioritarie).
Percorrere la Regione Raggiungibile
Tre fonti: hermes3-general (H), gutenberg (G), dictionary (D). Vincoli: limite inferiore H = 0,5, limite superiore D = 0,25. (Implicito: tutti i pesi >= 0, somma a 1, nessun altro vincolo.)
Restrizione delle dimensioni per i primi 20K passi
Cosa ha fatto il riscaldamento del curriculum di v2
v2 ha impostato curriculum_warmup_sources su sette fonti: hermes3-general, hermes3-creative, hermes3-roleplay, chat, smoltalk, oasst, gutenberg. Per i primi 20K passi, SOLO quelle sette fonti hanno contribuito. Dopo il passo 20K, si è attivata la piena fonte a 16 sorgenti.
Interpretazione geometrica
Il semplice completo a 16 sorgenti si trova in R^16. Limitando a 7 sorgenti, 9 delle 16 coordinate vengono azzerate. La passeggiata del bandit avviene in un sotto-simplice di dimensione 6 (una in meno rispetto al numero di sorgenti, a causa del vincolo di somma pari a 1).
Geometricamente: un SOTTOVARIETÀ del semplice completo. Di dimensione inferiore, più liscio, più facile da navigare.
Perché questo aiuta l'addestramento iniziale
Nelle fasi iniziali dell'addestramento, il modello non ha ancora appreso un linguaggio coerente. Le sorgenti diverse lo confondono: ogni sorgente ha il proprio stile, la propria distribuzione del vocabolario, il proprio pattern. Mescolare 16 sorgenti con inizializzazione casuale crea una distribuzione di destinazione troppo ampia che il modello non riesce a modellare.
Limitare a 7 sorgenti conversazionali/prosa fornisce una destinazione più uniforme. Il modello impara prima una rappresentazione stabile, poi si espande.
Percorso Geometrico Attraverso l'Addestramento
1. Passi 0 a 20K (warmup). La passeggiata si svolge sul sotto-simplex 6-D. Emergono pattern linguistici stabili nel modello.
2. Passi 20K a 112K (full firehose). La passeggiata si espande al semplice completo 15-D. Emerge l'ampiezza del dominio.
3. Dal passo 112K in poi (rifinitura). La passeggiata viene nuovamente ristretta: repo-docs e repo-docstrings esclusi, soglie minime conversazionali allegate. Un poligono più piccolo nel semplice completo; la qualità conversazionale si consolida.
Perché il set di rifinitura imposta curriculum_warmup_steps = 0
La rifinitura inizia al passo 112K. Il modello parla già un linguaggio coerente. Ristringere ora a un sotto-simplex comporterebbe una perdita di ampiezza senza alcun guadagno (il vantaggio del warmup è per modelli con inizializzazione fresca). Impostare warmup_steps = 0 significa: restare sul semplice completo, ma con nuovi limiti e soglie minime.
Tre Geometrie, Un Percorso di Addestramento
Warmup v2: sotto-ssemplice di bassa dimensione.
Firehose v2: semplice 15-D completo.
Rifinitura v3: semplice completo con poligono più piccolo (più vincoli).
Stesso percorso di 200K passi, tre diversi regimi geometrici. Ciascuno è stato ottimizzato per una diversa fase di maturità del modello.