分佈是一種形狀
統計學具有幾何學
每個數據集都有其形狀。將數值繪製在數軸上,並在它們聚集處堆疊柱狀圖,就會出現一個輪廓:一個隆起、一個偏斜的傾斜,或一條長尾。統計學為該形狀提供了座標。
兩個地標定位了形狀的中心。
均值是質心:即平衡點。想像每個數據值都是放在沿數軸延伸的槓桿上的等重砝碼。均值是槓桿平衡的唯一支點。遠離中心的值產生的槓桿作用,正如遠處坐在槓桿上的重孩子一樣:距離乘以重量。
中位數是「按數量」的中間值:即有一半數據位於其下方,另一半位於其上方的數值。它只關注順序與數量,完全不在意某個數值偏離中心有多遠。
在完全對稱的分佈形狀中,平衡點(重心)與中間位置重合:平均值等於中位數。一旦對稱性被打破,兩者便會分離。
偏度(Skew) 正是這種被打破的對稱性。右偏(正偏) 具有一條向高值方向延伸的長尾(例如收入數據集中有少數億萬富翁)。這些極端遠端的數值會將平衡點拉向尾部,因此平均值會落在中位數的右側。左偏(負偏)則是其鏡像對稱。
這就是為什麼「中位數家庭收入」與「平均家庭收入」會有差異:不對稱的分佈幾何形狀會將重心(平均值)拉離「按數量計算的中間位置」(中位數)。
平均值會朝哪個方向移動?
某鎮發布了其家庭收入數據。大多數家庭的收入在 40,000 到 90,000 之間,但有少數居民的年收入達數百萬。收入分佈形狀呈現一條向右延伸的長尾。
典型值距離中心有多遠?
離散度是一種距離
重心(Centroid)告訴你形狀的平衡點在哪裡。它並未說明形狀有多寬。兩個資料集可以擁有完全相同的平均值,但外觀卻截然不同:一個緊密聚集在中心附近,另一個則廣泛分散。
標準差(sigma)衡量分散程度:它本質上代表了數值與平均值之間的典型距離。標準差較小,意味著分佈形狀狹窄且高聳,緊貼中心;標準差較大,則意味著分佈形狀寬廣且扁平,向兩側延伸得更遠。
想像兩位射箭手。兩人的平均成績都是正中紅心:他們的重心都落在靶心上。射箭手 A 將所有箭都射在離中心一個手掌寬的範圍內(標準差小)。射箭手 B 則將箭射遍整個靶面,但偏離的誤差相互抵消,使得平均值仍顯示為正中(標準差大)。平均值相同,分散程度卻截然相反。僅憑平均值無法區分兩者;標準差卻可以。
從幾何角度看,標準差決定了分佈的水平尺度。在不移動平衡點的情況下將形狀拉寬,就等於在保持平均值不變的前提下提高了標準差。這個單一數值——即形狀的寬度——正是下一個概念所依賴的關鍵。
中心相同,寬度不同
兩家工廠各自生產平均重量為 500 公克的袋子。工廠 A 的標準差為 4 公克。工廠 B 的標準差為 20 公克。
客戶會拒收任何重量與 500 公克相差超過 15 公克的袋子。
如同 1 除以根號 n 般縮小的誤差
從資料的變異到估計值的變異
你很少能測量整個母體。你通常會抽取一個樣本並計算其平均值作為估計值。若抽取另一個樣本,你會得到略有不同的平均值。這些樣本平均值具有其自身的形狀:抽樣分佈,並以真實平均值為中心。
它的寬度有一個名稱:標準誤差(standard error of the mean)。
SE = sigma / sqrt(n)
其中 sigma 是個別數值的分散度,n 是樣本大小。標準誤差是樣本均值與真實均值之間的典型距離:它是你的估計值的分散度,而非原始資料的分散度。
幾何特性就藏在這個平方根中。SE 隨 1/sqrt(n) 下降,而非隨 1/n 下降。平均更多測量值會縮小抽樣分佈,但邊際效益遞減:每個新觀測值帶來的縮小幅度都比前一個小。
直接的後果是:要將標準誤差減半,必須將樣本大小增加四倍。從 n = 100 增加到 n = 200 並不會使誤差減半;你需要 n = 400。精度之所以昂貴,是因為它與平方根成比例。
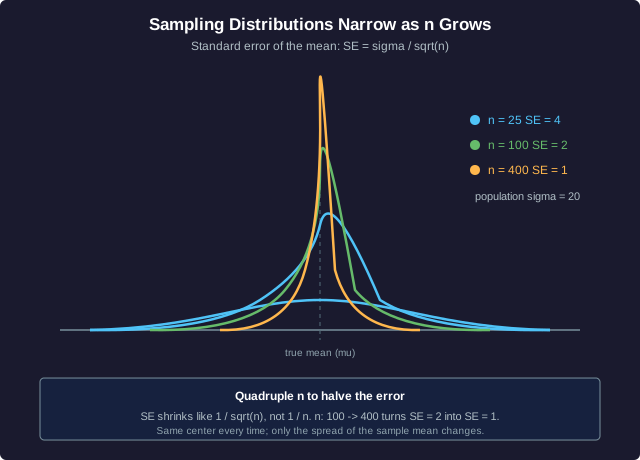
上方的曲線共享同一個中心,並隨著 n 從 25 增加到 100 再到 400 而變窄,其中 sigma 保持為 20。讀取每個情況下的 SE:先是 4,然後是 2,最後是 1。
計算標準誤差
一組測驗分數的母體標準差為 sigma = 20。你抽取一個樣本大小為 n = 100 的樣本並計算其平均值。
當座標軸說謊時
被操縱的幾何學
圖表是一種幾何轉譯:數字轉化為長度、面積和斜率,讓眼睛能瞬間讀取。一旦操縱了這種轉譯,眼睛就會報告一個數據從未說過的謊言。
截斷的座標軸。 長條圖的數值軸應從零開始,以確保長條的高度與數值成比例。如果將軸的起點設為 95 而非 0,那麼從 100 到 102 的上升(實際變化僅為 2%)就會填滿整個畫面,看起來彷彿巨大無比。繪製的長度不再與數字的比率相符。在折線圖中,同樣的手法會讓所有斜率變得更陡峭:緩慢的上升看起來像懸崖,因為垂直比例被壓縮在一個狹窄的視窗內。
斜率膨脹。 斜率是上升量除以橫向跨度。縮小座標軸涵蓋的範圍(即其顯示的數值跨度),同時保持像素高度不變,所有上升部分都會被重新繪製得更陡峭。趨勢本身並未改變;改變的只是畫框的幾何結構。
面積與長度的失真。 要顯示數量翻倍,誠實的圖表會將一個維度加倍:例如長條高度加倍。不誠實的圖表則會同時縮放圖示或圓形的寬度和高度,使得 2 倍的數值變成具有 4 倍面積的圖像。眼睛判斷的是面積,因此翻倍看起來像四倍。氣泡圖在將數值對應到半徑而非面積時,經常濫用此手法,因為面積隨半徑的平方增長。
專業人士的習慣:檢查座標軸從哪裡開始,檢查是長度還是面積在編碼數值,並在相信形狀之前,在腦中重新調整比例。
診斷失真
儀表板顯示季度營收從 1 億上升至 1.04 億。為了讓這筆增長看起來更戲劇化,設計師將垂直軸的起點設為 98 而非 0。第二個面板透過將錢袋圖示的寬度和高度同時放大 4% 來呈現同樣的 4% 增長。
形狀、分布、誤差與座標軸
回歸本質
自動化儀表板會為您繪製形狀。它們會渲染長條圖、擬合曲線並動畫化趨勢。但它們無法以判斷力來解讀幾何結構。這是專業人士的工作。
受過訓練的解讀者會對任何圖表執行四項檢查:
- 重心(Centroid)。 形狀的平衡點在哪裡?偏態是否將平均值拉離中位數?單一報告的平均值可能隱藏了失衡的現實。
- 分布範圍(Spread)。 形狀有多寬?建立在巨大變異數之上的、看似自信的平均值,不過是穿著西裝的拋硬幣遊戲。
- 抽樣誤差(Sampling error)。 樣本量 n 有多大?估計值帶有 sigma/sqrt(n) 的標準誤差,而極小的樣本意味著寬廣且不可信的區間,無論標題數字看起來多麼精確。
- 座標軸幾何(Axis geometry)。 數值軸是否從零開始?數量是以長度還是面積來編碼?操縱的座標軸會將四捨五入的誤差轉化為革命性的誤解。
儀表板提供的是圖表,你提供的是懷疑。無論圖表看起來多麼精緻,只要其座標軸幾何結構被操縱,或樣本量過小,就值得懷疑。
閱讀此儀表板
某新創公司的儀表板宣稱:本季度每用戶平均營收「飆升」。細小字體顯示:該平均值來自 n = 9 名用戶的樣本,其中兩戶是龐大的企業客戶,且長條圖的座標軸起點設在上季度值的 90%。
統計學的幾何學:摘要
你已學到的內容
統計學是穿著數字外衣的幾何學:
- 平均值是質心:資料的平衡點。偏度會將該支點拉向長尾方向,因此右偏(正偏)分佈的平均值大於中位數。中位數僅計算位置,因此能抵抗這種拉力。
- 標準差是離散度:距離中心的典型距離,即形狀的寬度。兩個分佈可以擁有相同的平均值,但其數值的散佈範圍卻可能大相逕庭。
- 抽樣誤差是 sigma/sqrt(n):抽樣分佈的寬度。它隨 1/sqrt(n) 縮小,因此若要將誤差減半,樣本量需增加四倍。精確度是用平方根換來的。
- 座標軸幾何學可能具有欺騙性:截斷的座標軸會使長度與數值脫鉤並使斜率變陡;在二維空間中縮放圖示,其面積會隨縮放因子的平方增長,因此眼睛會將「加倍」誤讀為「四倍」。
自動化儀表板繪製出圖形。專業人士則負責解讀:定位質心、評估分散度、權衡抽樣誤差,並對任何座標軸幾何結構被操縱的圖表保持懷疑。圖形是基礎,判斷力才是上限。