분포는 하나의 형태이다
통계에는 기하학이 있다
모든 데이터셋에는 형태가 있다. 값을 수직선(number line) 위에 배치하고 값이 밀집된 곳에 막대를 쌓아 올리면 실루엣이 나타난다: 돌출부, 한쪽으로 기울어진 형태, 긴 꼬리. 통계는 그 형태에 좌표를 부여한다.
두 개의 랜드마크가 형태의 중심을 위치시킨다.
평균은 중심 모멘트(centroid)이다: 균형점. 각 데이터 값을 수직선 위에 놓인 시소 위에 앉아 있는 동일한 무게로 상상해 보자. 평균은 시소가 균형을 이루는 유일한 지점이다. 중심에서 먼 값들은 시소 끝자리에 앉아 있는 무거운 아이처럼 정확히 레버리지(지렛대 효과)를 발휘한다: 거리 곱하기 무게.
중앙값은 개수에 의한 중간입니다: 절반의 데이터가 그 값보다 아래에 있고 절반이 위에 있는 값입니다. 이는 오직 순서와 개수만 고려하며, 값이 얼마나 멀리 떨어져 있는지는 전혀 고려하지 않습니다.
완벽하게 대칭인 분포에서는 중심축(피벗)과 중간이 일치합니다: 평균은 중앙값과 같습니다. 대칭이 깨지면 두 값은 분리됩니다.
왜도(Skew)는 바로 그 깨진 대칭입니다. 우측 왜도는 높은 값 방향으로 길게 뻗은 꼬리를 가집니다(소득 데이터셋에서 소수의 억만장자처럼). 이러한 멀리 떨어진 값들의 가중치가 균형점을 꼬리 쪽으로 끌어당기므로, 평균은 중앙값의 오른쪽에 위치하게 됩니다. 좌측 왜도는 이의 거울상입니다.
이것이 가계 소득의 중앙값과 평균이 서로 다른 이유입니다: 비대칭적인 분포의 기하학적 구조가 중심(centroid)을 개수 기준의 중간에서 벗어나게 끌어당기기 때문입니다.
평균은 어느 방향으로 이동하는가?
어떤 마을이 가계 소득을 보고합니다. 대부분의 가구는 40,000에서 90,000 사이를 벌지만, 소수의 주민은 수백만 원을 벌고 있습니다. 이 소득 분포는 오른쪽으로 길게 뻗은 꼬리를 가지고 있습니다.
중심으로부터의 전형적인 거리는?
분산은 거리입니다
중심(centroid)은 형태가 균형 잡히는 위치를 알려줍니다. 이는 형태의 폭에 대해 아무것도 말해 주지 않습니다. 두 데이터셋은 동일한 평균을 공유하면서도 전혀 다르게 보일 수 있습니다: 하나는 중심으로 조밀하게 모여 있고, 다른 하나는 넓게 퍼져 있을 수 있습니다.
표준편차(시그마)는 분포의 퍼짐 정도를 측정합니다: 이는 본질적으로 값이 평균에서 벗어난 전형적인 거리입니다. 시그마가 작으면 중심을 꼭 붙잡는 좁고 높은 형태를 의미하며, 시그마가 크면 양쪽으로 멀리 뻗어나가는 넓고 평평한 형태를 의미합니다.
두 명의 궁수를 생각해 보겠습니다. 두 사람 모두 평균적으로 정확히 중앙을 맞힙니다: 그들의 중심(centroid)이 과녁의 중앙에 위치합니다. 궁수 A는 모든 화살을 중앙에서 손 너비 이내로 쏩니다(작은 시그마). 반면 궁수 B는 화살을 과녁 전체에 흩뿌리지만, 빗나간 화살들이 상쇄되어 평균은 여전히 중앙으로 읽힙니다(큰 시그마). 평균은 같지만 퍼짐 정도는 정반대입니다. 평균만으로는 두 사람을 구별할 수 없으나, 표준편차는 구별할 수 있습니다.
기하학적으로, 시그마는 분포의 수평적 스케일을 결정합니다. 균형점을 이동시키지 않으면서 모양을 더 넓게 늘리면, 평균은 고정된 채 시그마가 높아집니다. 이 단일 수치, 즉 모양의 너비는 다음 개념의 기초가 됩니다.
같은 중심, 다른 너비
두 공장이 각각 평균 무게 500그램의 봉투를 채웁니다. A공장의 표준편차는 4그램이고, B공장의 표준편차는 20그램입니다.
고객은 500그램에서 15그램 이상 벗어난 봉투는 모두 거부합니다.
1/√n처럼 줄어드는 오차
데이터의 분산에서 추정치의 분산으로
전체 모집단을 측정하는 일은 드뭅니다. 우리는 표본을 추출하고 그 평균을 추정치로 계산합니다. 다른 표본을 추출하면 약간 다른 평균을 얻게 됩니다. 이러한 표본 평균들은 자체적인 형태를 가집니다: 표본 분포이며, 이는 참 평균을 중심으로 합니다.
그 폭에는 이름이 있습니다: 표본 평균의 표준 오차(Standard Error of the Mean)입니다.
SE = sigma / sqrt(n)
여기서 sigma는 개별 값의 분산(스프레드)을, n은 표본 크기를 나타냅니다. 표준 오차는 표본 평균과 참 평균(true mean) 사이의 전형적인 거리입니다: 이는 원시 데이터의 분산이 아니라, 여러분의 추정치의 분산입니다.
기하학적 원리는 그 제곱근 안에 있습니다. SE는 1/n이 아니라 1/sqrt(n)에 비례하여 감소합니다. 더 많은 측정을 평균화하면 표본 분포가 좁아지지만, 그 효과는 감소합니다(diminishing returns): 각 새로운 관측치는 이전 것보다 더 적은 폭의 감소만 가져옵니다.
그 직결된 결과: 표준 오차를 절반으로 줄이려면 표본 크기를 4배로 늘려야 합니다. n = 100에서 n = 200으로 가도 오차가 절반이 되지 않습니다; n = 400이 필요합니다. 정밀도는 제곱근에 비례하여 증가하므로 비용이 많이 듭니다.
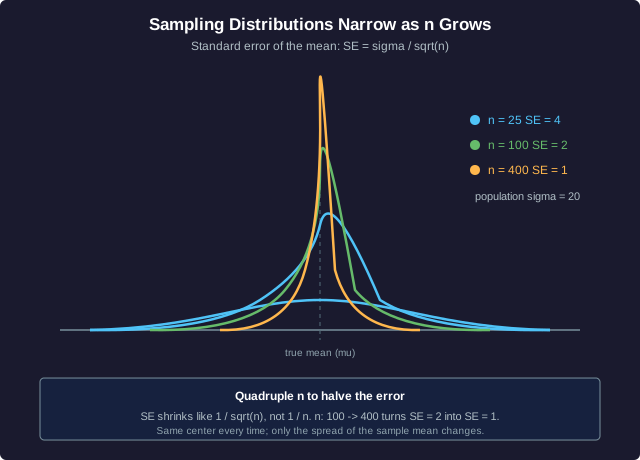
위 곡선들은 하나의 중심을 공유하며, sigma가 20으로 고정된 상태에서 n이 25에서 100, 400으로 증가함에 따라 폭이 줄어듭니다. 각 지점의 SE를 읽어보면: 4, 그리고 2, 그리고 1입니다.
표준 오차 계산
표본 점수 집단(population)의 표준편차 sigma = 20입니다. 크기 n = 100인 표본을 추출하여 그 평균을 계산합니다.
축이 거짓말할 때
조작된 기하학
차트는 기하학적 변환입니다: 숫자가 눈이 즉시 읽을 수 있는 길이, 면적, 기울기로 변환됩니다. 이 변환을 조작하면 데이터가 결코 말하지 않은 거짓말을 눈이 보고 말하게 됩니다.
축 절단. 막대 차트는 값 축을 0에서 시작해야 하므로 막대의 높이가 값에 비례하게 유지됩니다. 예를 들어 0 대신 95에서 축을 시작하면, 100에서 102로의 상승(실제 변화 2퍼센트)가 거대해 보이는 것처럼 프레임을 가득 채웁니다. 그려진 길이가 더 이상 숫자의 비율과 일치하지 않게 됩니다. 선 그래프에서는 동일한 트릭이 모든 기울기를 가파르게 만듭니다: 수직 축이 좁은 범위로 압축되었기 때문에 완만한 상승이 절벽처럼 읽힙니다.
기울기 부풀리기. 기울기는 상승분(run)에 대한 상승분(rise)입니다. 축이 포괄하는 범위(표시하는 값의 run)를 줄이면서 픽셀 높이는 고정하면, 모든 상승분이 더 가파르게 다시 그려집니다. 추세는 변하지 않았습니다; 프레임의 기하학만이 변한 것입니다.
면적 대 길이 왜곡. 어떤 양이 두 배가 됨을 보여주기 위해, 정직한 차트는 한 차원을 두 배로 만듭니다: 두 배로 높은 막대. 정직하지 않은 차트는 아이콘이나 원의 폭과 높이를 모두 확장하므로, 2배 값이 4배 면적을 가진 그림이 됩니다. 눈은 면적을 판단하므로, 두 배가 네 배처럼 보입니다. 버블 차트는 값이 면적이 아닌 반지름에 매핑될 때 이 현상을 끊임없이 악용하며, 이는 면적이 반지름의 제곱에 비례하여 증가하기 때문입니다.
전문가의 습관: 축이 어디서 시작하는지, 값이 길이로 인코딩되는지 면적으로 인코딩되는지 확인하고, 모양을 신뢰하기 전에 정신적으로 다시 스케일링하십시오.
왜곡 진단
대시보드에 분기별 매출이 1억에서 1억 400만으로 증가하는 내용이 표시됩니다. 이 증가분을 더 극적으로 보이게 하려는 디자이너는 세로 축의 시작점을 0이 아닌 98로 설정합니다. 두 번째 패널은 동일한 4퍼센트 증가분을 화폐 주머니 아이콘의 너비와 높이를 모두 4퍼센트 확대하여 그립니다.
형태, 분산, 오차, 축
핵심 요약
자동화된 대시보드는 형태를 그려줍니다. 막대를 렌더링하고, 곡선을 적합하며, 추세를 애니메이션으로 표현합니다. 하지만 판단을 가지고 그 기하학을 해석하는 것은 불가능합니다. 그것은 전문가의 역할입니다.
훈련된 독자는 모든 차트에 대해 네 가지 검증을 수행합니다:
- 중심(중심점). 형태가 어디에 균형 잡혀 있으며, 왜도가 평균을 중앙값에서 멀어지게 끌어당기고 있는가? 단일 보고된 평균은 편향된 현실을 가릴 수 있습니다.
- 분산(스프레드). 형태의 폭은 얼마나 넓은가? 거대한 분산 위에 세워진 자신감 있어 보이는 평균은 정장 차림의 동전 던지기일 뿐입니다.
- 표본 오차. n(표본 크기)은 얼마나 컸는가? 추정치는 sigma/sqrt(n)의 표준 오차를 가지며, 표본이 작을수록 헤드라인 숫자가 아무리 선명해 보여도 넓고 신뢰할 수 없는 구간을 의미합니다.
- 축의 기하학. 값 축이 0에서 시작하는가? 양(量)은 길이로 인코딩되었는가, 아니면 면적으로 인코딩되었는가? 조작된 축은 반올림 오차를 혁명으로 바꿉니다.
대시보드는 그림을 제공하고, 당신은 불신을 제공합니다. 축의 기하학적 구조가 조작되었거나 표본이 너무 작은 차트는 아무리 세련되어 보여도 의심의 대상이 됩니다.
이 대시보드를 읽다
어떤 스타트업의 대시보드는 이렇게 선포합니다: 이번 분기에 사용자당 평균 매출이 급증했습니다. 작은 글씨로 적힌 내용: 이 평균은 n = 9명의 사용자 표본에서 나왔으며, 그중 2명은 거대한 엔터프라이즈 계정이고, 막대 차트의 축은 지난 분기 값의 90퍼센트에서 시작합니다.
통계의 기하학: 요약
배운 내용
통계는 숫자를 입은 기하학입니다:
- 평균은 중심(centroid)입니다: 데이터의 균형점입니다. 왜도는 그 피벗(회전축)을 긴 꼬리 쪽으로 당기므로, 오른쪽으로 왜도된 분포에서는 평균 > 중앙값이 됩니다. 중앙값은 위치만 계산하므로 이러한 당김에 저항합니다.
- 표준편차는 분산입니다: 중심으로부터의 전형적인 거리, 즉 분포의 폭입니다. 두 분포가 동일한 평균을 공유하더라도 값들이 퍼지는 정도는 극단적으로 다를 수 있습니다.
- 표본 오차는 sigma/sqrt(n)입니다: 표본 분포의 폭입니다. 이는 1/sqrt(n)처럼 감소하므로, 오차를 절반으로 줄이려면 표본 크기를 4배로 늘려야 합니다. 정밀도는 제곱근으로 구매됩니다.
- 축의 기하학은 거짓말을 할 수 있습니다: 잘린 축은 길이와 값을 분리하고 기울기를 가파르게 만듭니다. 아이콘을 2차원으로 확장하면 면적이 배율의 제곱만큼 증가하므로, 눈은 2배 증가를 4배 증가로 읽게 됩니다.
자동 대시보드는 형태를 그립니다. 전문가가 그것을 읽습니다: 중심을 찾아내고, 분산을 측정하며, 표본 오차를 가늠하고, 축의 기하학적 구조가 조작된 차트는 의심합니다. 그림은 바닥이고, 판단은 천장입니다.