वितरण एक आकार है
सांख्यिकी में ज्यामिति होती है
हर डेटासेट का एक आकार होता है। मानों को एक संख्या रेखा (number line) पर प्लॉट करें और जहाँ वे क्लस्टर बनाते हैं, वहाँ एक बार (bar) जमा करें, और एक सिल्हूट दिखाई देगा: एक उभार, एक टेढ़ा झुकाव, या एक लंबा पूंछ। सांख्यिकी उस आकार को निर्देशांक (coordinates) देती है।
दो लैंडमार्क आकार के केंद्र को पहचानते हैं।
माध्य सेंट्रॉइड है: संतुलन बिंदु। कल्पना करें कि प्रत्येक डेटा मान संख्या रेखा पर बने एक सीसो (seesaw) पर बैठे समान वजन हैं। माध्य वह एकमात्र पिभॉट (pivot) है जहाँ सीसो संतुलित होता है। केंद्र से दूर के मान ठीक उसी तरह लीवरेज (leverage) प्रदान करते हैं जैसे सीसो के दूर के सिरे पर बैठे भारी बच्चा: दूरी गुणा वजन।
मध्यिका (Median) संख्या के अनुसार बीच का मान है: वह मान जिसके नीचे आधा डेटा और ऊपर आधा डेटा होता है। यह केवल क्रम और गणना पर ध्यान देता है, यह कभी यह नहीं देखता कि कोई मान कितना दूर स्थित है।
एक पूर्णतः सममित आकार पर, पिवट (pivot) और बीच का बिंदु एक ही होते हैं: माध्य (mean) मध्यिका के बराबर होता है। सममिति टूटने पर वे अलग हो जाते हैं।
विषमता (Skew) वह टूटी हुई सममिति है। दाईं ओर की विषमता (right skew) में उच्च मानों की ओर बढ़ने वाला एक लंबा पूंछ होता है (आय डेटासेट में कुछ अरबपतियों की तरह)। ये दूर स्थित भार संतुलन बिंदु को पूंछ की ओर खींच लेते हैं, इसलिए माध्य मध्यिका के दाईं ओर आ जाता है। बाईं ओर की विषमता इसका दर्पण प्रतिबिंब होती है।
यही कारण है कि मध्यक घरेलू आय (median household income) और माध्य घरेलू आय (mean household income) में अंतर होता है: एक असममित आकार की ज्यामिति सेंट्रॉइड (centroid) को गणना-के-बीच (count-middle) से हटा देती है।
माध्य किस दिशा में बढ़ता है?
एक शहर ने अपनी घरेलू आयों की रिपोर्ट की। अधिकांश परिवारों की आय 40,000 और 90,000 के बीच है, लेकिन कुछ निवासियों की आय कई मिलियन है। आय के आकार में दाईं ओर तक पहुँचने वाला एक लंबा पूंछ है।
केंद्र से सामान्यतः कितनी दूरी?
फैलाव एक दूरी है
सेंट्रॉइड (centroid) आपको बताता है कि आकार कहाँ संतुलित होता है। यह इस बारे में कुछ नहीं कहता कि आकार कितना चौड़ा है। दो डेटासेट एक ही समान माध्य (mean) साझा कर सकते हैं, फिर भी एक-दूसरे से बिल्कुल अलग दिख सकते हैं: एक केंद्र के चारों ओर घनी रूप से पैक, और दूसरा चौड़ा फैला हुआ।
मानक विचलन (sigma) फैलाव को मापता है: यह, प्रभावी रूप से, किसी मान के औसत से दूरी का सामान्य माप है। छोटा sigma का अर्थ है एक संकीर्ण, ऊँचा आकार जो केंद्र के चारों ओर सिकुड़ा हुआ है। बड़ा sigma का अर्थ है एक चौड़ा, चपटा आकार जो दोनों ओर दूर तक फैला है।
दो तीरंदाजों पर विचार करें। दोनों का औसत मध्यबिंदु पर है: उनका केंद्रक (centroid) बल्लसे (bullseye) पर स्थित है। तीरंदाज A हर तीर को केंद्र से एक हाथ की चौड़ाई के भीतर समूह बनाता है (छोटा sigma)। तीरंदाज B तीरों को पूरे लक्ष्य पर बिखेरता है, फिर भी चूकें एक-दूसरे को रद्द कर देती हैं ताकि औसत फिर भी केंद्र पर पढ़ा जाए (बड़ा sigma)। समान औसत, विपरीत फैलाव। औसत अकेला उन्हें अलग नहीं कर सकता; मानक विचलन कर सकता है।
ज्यामितीय रूप से, sigma वितरण के क्षैतिज पैमाने को निर्धारित करता है। यदि आप आकार को चौड़ा करते हैं बिना उसके संतुलन बिंदु को हिलाए, तो आपने औसत को स्थिर रखते हुए sigma को बढ़ा दिया है। वह एकमात्र संख्या, आकार की चौड़ाई, ही वह बात है जिस पर अगला विचार निर्भर करता है।
समान केंद्र, अलग चौड़ाई
दो कारखाने प्रत्येक 500 ग्राम के औसत वजन के साथ थैले भरते हैं। कारखाना A का मानक विचलन 4 ग्राम है। कारखाना B का मानक विचलन 20 ग्राम है।
ग्राहक 500 से 15 ग्राम से अधिक दूर वाले किसी भी थैले को अस्वीकार करता है।
वह त्रुटि जो 1/√n के रूप में कम होती है
डेटा के फैलाव से अनुमान के फैलाव तक
आप दुर्लभ रूप से एक पूरी जनसंख्या (population) का मापन करते हैं। आप एक नमूना (sample) लेते हैं और इसका औसत एक अनुमान के रूप में गणना करते हैं। एक अलग नमूना लें और आपको थोड़ा अलग औसत मिलेगा। उन नमूना औसतों (sample means) का अपना एक आकार होता है: नमूना वितरण (sampling distribution), जो सच्चे औसत (true mean) पर केंद्रित होता है।
इसकी चौड़ाई का एक नाम है: मान के मानक त्रुटि (standard error of the mean)।
SE = sigma / sqrt(n)
जहाँ sigma व्यक्तिगत मानों का फैलाव (spread) है और n नमूना आकार (sample size) है। मानक त्रुटि एक नमूना माध्य (sample mean) और वास्तविक माध्य (true mean) के बीच की सामान्य दूरी है: यह आपके अनुमान का फैलाव है, कच्चे डेटा का नहीं।
ज्यामिति उस वर्गमूल (square root) में निहित है। SE 1/n के रूप में नहीं, बल्कि 1/sqrt(n) के रूप में घटता है। अधिक मापों का औसत लेना नमूना वितरण (sampling distribution) को संकुचित करता है, लेकिन ह्रासमान प्रतिफल (diminishing returns) के साथ: हर नया अवलोकन पिछले की तुलना में कम संकुचन प्रदान करता है।
सीधा परिणाम: मानक त्रुटि को आधा करने के लिए आपको नमूना आकार को चार गुना करना होगा। n = 100 से n = 200 जाने से आपकी त्रुटि आधी नहीं होती; आपको n = 400 की आवश्यकता होती है। सटीकता महंगी है क्योंकि यह वर्गमूल के साथ स्केल होती है।
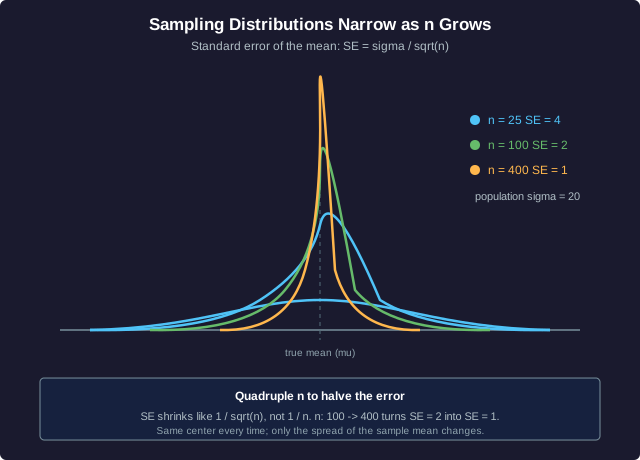
ऊपर दिए गए वक्र एक ही केंद्र साझा करते हैं और n 25 से 100 और फिर 400 तक बढ़ने के साथ चौड़ाई में संकुचित होते हैं, जबकि sigma 20 पर स्थिर रखा गया है। प्रत्येक पर SE पढ़ें: 4, फिर 2, फिर 1।
मानक त्रुटि की गणना करें
टेस्ट स्कोर की एक जनसंख्या का मानक विचलन (standard deviation) sigma = 20 है। आप n = 100 के आकार का एक नमूना (sample) लेते हैं और उसका माध्य (mean) गणना करते हैं।
जब अक्ष (Axis) झूठ बोलता है
छल-बटल भूमिति
चार्ट एक ज्यामितीय अनुवाद है: अंक लंबाई, क्षेत्रफल और ढलानों में बदल जाते हैं, जिन्हें आँख तुरंत पढ़ लेती है। यदि आप इस अनुवाद में छल करें, तो आँख एक ऐसा झूठ रिपोर्ट करेगी जो डेटा ने कभी नहीं बताया था।
कटा हुआ अक्ष (Truncated axis)। एक बार चार्ट को इस तरह होना चाहिए कि इसका मान अक्ष (value axis) शून्य से शुरू हो, ताकि बार की ऊँचाई मान के अनुपात में बनी रहे। यदि आप अक्ष को 0 के बजाय, उदाहरण के लिए, 95 से शुरू करते हैं, तो 100 से 102 तक की वृद्धि (जो कि वास्तव में 2 प्रतिशत की बदलाव है) फ्रेम को भर देती है, मानो वह बहुत बड़ी हो। प्लॉट की गई लंबाइयाँ अब संख्याओं के अनुपातों से मेल नहीं खातीं। एक लाइन चार्ट में यही चाल हर ढलान को अधिक तीव्र बना देती है: एक हल्की चढ़ाई एक गिरावट (cliff) की तरह पढ़ी जाती है क्योंकि ऊर्ध्वाधर पैमाने (vertical scale) को एक संकीर्ण विंडो में सिकोड़ा गया है।
ढलान में वृद्धि (Slope inflation)। ढलान (slope) उठान (rise) और दौड़ (run) का अनुपात है। यदि आप अक्ष द्वारा कवर किए गए दायरे (range) को छोटा करते हैं (जो कि प्रदर्शित मानों की दौड़ है) जबकि पिक्सेल ऊँचाई को स्थिर रखते हैं, तो हर उठान (rise) अधिक तीव्रता से पुनः चित्रित की जाती है। रुझान (trend) नहीं बदला है; केवल फ्रेम की भूमिति बदली है।
क्षेत्रफल बनाम लंबाई विकृति (Area-versus-length distortion)। किसी मात्रा के दोगुना होने को दिखाने के लिए, एक ईमानदार चार्ट एक ही आयाम (dimension) को दोगुना करता है: एक बार जो दोगुनी ऊँचाई का हो। एक बेईमान चार्ट एक आइकॉन या वृत्त को चौड़ाई और ऊँचाई दोनों में स्केल करता है, ताकि 2x का मान 4x क्षेत्रफल वाली एक तस्वीर बन जाए। आँख क्षेत्रफल का आकलन करती है, इसलिए दोगुना होना चार गुना होने जैसा लगता है। बुबल चार्ट (Bubble charts) इसका लगातार दुरुपयोग करते हैं जब वे मान को क्षेत्रफल के बजाय त्रिज्या (radius) से मैप करते हैं, क्योंकि क्षेत्रफल त्रिज्या के वर्ग के रूप में बढ़ता है।
व्यावसायिक आदत: यह जाँचें कि अक्ष कहाँ से शुरू होता है, जाँचें कि क्या लंबाई या क्षेत्रफल मान को एन्कोड करता है, और आकार पर विश्वास करने से पहले मानसिक रूप से पुनः-स्केल (rescale) करें।
विकृति का निदान करें
एक डैशबोर्ड में तिमाही राजस्व 100 से 104 मिलियन तक बढ़ रहा दिखाया गया है। इस वृद्धि को अधिक प्रभावशाली दिखाने के लिए, डिज़ाइनर ने ऊर्ध्वाधर अक्ष (vertical axis) को 0 की बजाय 98 से शुरू किया है। एक दूसरा पैनल उसी 4 प्रतिशत की वृद्धि का प्रतिनिधित्व करता है, जिसमें एक मनी-बैग आइकन को चौड़ाई और ऊंचाई दोनों में 4 प्रतिशत बढ़ाकर (scaled up) बनाया गया है।
आकार, फैलाव, त्रुटि, अक्ष
इसे घर पर ले जाना
स्वचालित डैशबोर्ड आकार को आपके लिए बना देते हैं। वे बारें बनाते हैं, वक्र को फिट करते हैं, और रुझान को एनिमेट करते हैं। लेकिन वे ज्यामिति को विवेक के साथ पढ़ नहीं सकते। यह पेशेवर का काम है।
एक प्रशिक्षित पाठक किसी भी चार्ट पर चार जांचें करता है:
- सेंट्रॉइड (केंद्रक)। आकार कहाँ संतुलित है, और क्या कोई विकृति (skew) माध्य (mean) को मध्यिका (median) से दूर खींच रही है? एक अकेला रिपोर्ट किया गया औसत एक टेढ़ी-मेढ़ी वास्तविकता को छुपा सकता है।
- फैलाव (Spread)। आकार कितना चौड़ा है? विशाल भिन्नता (variance) पर बना एक आत्मविश्वास से भरा औसत एक सूट पहने हुए सिक्का फेंकने के बराबर है।
- नमूना त्रुटि (Sampling error)। n कितना बड़ा था? अनुमान में sigma/sqrt(n) की मानक त्रुटि होती है, और एक छोटा सा नमूना इसका मतलब है कि कोई भी चौड़ा, विश्वसनीय अंतराल (interval) नहीं है, चाहे हेडलाइन संख्या कितनी भी स्पष्ट क्यों न दिखे।
- अक्ष ज्यामिति (Axis geometry)। क्या मान अक्ष शून्य से शुरू होता है? क्या मात्रा को लंबाई के रूप में या क्षेत्रफल के रूप में एन्कोड किया गया है? एक छलपूर्ण अक्ष (rigged axis) एक गोलिंग त्रुटि (rounding error) को क्रांति में बदल देता है।
डैशबोर्ड तस्वीर प्रदान करता है। आप अविश्वास प्रदान करते हैं। कोई भी चार्ट, जिसकी अक्ष ज्यामिति (axis geometry) छल से तैयार की गई हो, या जिसका नमूना (sample) बहुत छोटा हो, चाहे वह कितना भी पॉलिश्ड (polished) क्यों न दिखे, उस पर संदेह जताया जाता है।
इस डैशबोर्ड को पढ़ें
एक स्टार्टअप के डैशबोर्ड का दावा है: इस तिमाही में प्रति उपयोगकर्ता औसत राजस्व (average revenue per user) में उछाल आया है। सूक्ष्म अक्षरों में (fine print): यह औसत n = 9 उपयोगकर्ताओं के नमूने से आया है, जिनमें से दो विशाल उद्यम खाते (enormous enterprise accounts) हैं, और बार चार्ट का अक्ष पिछली तिमाही के मूल्य के 90 प्रतिशत से शुरू होता है।
सांख्यिकी की ज्यामिति: सारांश
आपने क्या सीखा
सांख्यिकी अंकों में ढकी हुई ज्यामिति है:
- माध्य (Mean) एक केंद्रक (centroid) है: यह डेटा का संतुलन बिंदु है। स्कीव (असममितता) उस पिवोट को लंबे पूंछ (long tail) की ओर खींचता है, इसलिए दाईं ओर झुकी (right-skewed) आकृति में माध्य > माध्यिका (median) होता है। माध्यिका केवल स्थितियों की गिनती करता है, इसलिए वह इस खिंचाव का विरोध करता है।
- मानक विचलन (Standard deviation) फैलाव है: केंद्र से सामान्य दूरी, आकृति की चौड़ाई। दो वितरण एक ही माध्य साझा कर सकते हैं, फिर भी उनके मानों के फैलने की दूरी में भारी अंतर हो सकता है।
- सैंपलिंग त्रुटि sigma/sqrt(n) है: सैंपलिंग वितरण की चौड़ाई। यह 1/sqrt(n) की तरह घटती है, इसलिए आपकी त्रुटि को आधा करने के लिए नमूना (sample) चार गुना बड़ा होना चाहिए। सटीकता (precision) वर्गमूल (square root) के माध्यम से खरीदी जाती है।
- अक्ष की ज्यामिति झूठ बोल सकती है: एक कटा हुआ (truncated) अक्ष लंबाई को मान से अलग कर देता है और ढलान को अधिक तीव्र बनाता है; एक आइकॉन को दो आयामों में स्केल करने पर क्षेत्रफल गुणक के वर्ग के रूप में बढ़ता है, इसलिए आँखें दोगुना होने को चार गुना मान लेती हैं।
स्वचालित डैशबोर्ड आकार बनाते हैं। पेशेवर उसे पढ़ता है: केंद्रक (centroid) की पहचान करना, फैलाव (spread) का मापन करना, सैंपलिंग त्रुटि (sampling error) का आंकलन करना, और किसी भी चार्ट को अविश्वास की नज़र से देखना जिसकी अक्ष ज्यामिति (axis geometry) धोखाधड़ी के लिए ढाली गई हो। चित्र नींव है; निर्णय क्षमता छत है।