分布とは形状である
統計には幾何学がある
すべてのデータセットには形状がある。値を数直線上にプロットし、値が密集する場所に棒を積み上げると、シルエットが現れます:隆起、片寄った傾き、長い尾。統計学はその形状に座標を与えます。
形状の中心を特定する2つのランドマークがあります。
平均は重心です:バランスの取れる点です。各データ値を、数直線上に置かれたシーソーの上に乗った等しい重さの重りだと想像してください。平均は、シーソーがバランスを取る単一の支点です。中心から遠い値は、シーソーの端に座った重い子供がそうであるのと同じように、まさに「距離 × 重さ」の方式でレバレッジ(力矩)を発生させます。
中央値は「個数」による真ん中です。データの半分が下側、半分が上側にある値です。これは順序と個数のみを考慮し、値がどれだけ外れているか(距離)は考慮しません。
完全に対称な形状では、支点(平均)と真ん中(中央値)は一致します:平均値は中央値に等しくなります。対称性が崩れると、両者は分離します。
偏り(スキュー)とは、その対称性の崩れです。右の偏り(右に裾野が長い)では、高い値の方向に長い尾(テール)が伸びています(所得データセットにおける少数の億万長者など)。これらの遠い位置にある重みは、バランスの中心(重心)を尾の方向に引き寄せます。そのため、平均値は中央値の右側に位置します。左の偏りはその鏡像です。
これが、世帯所得の中央値と平均値が異なる理由です。片寄った形状の幾何学的性質が、重心(平均)を個数の真ん中(中央値)から引き離します。
平均値はどちらの方向に動くか?
ある町が世帯所得を報告しています。ほとんどの家族の所得は4万ドルから9万ドルの間にありますが、少数の住民が数百万ドルを稼いでいます。所得の分布形状は、右側に長い尾(テール)を持っています。
中心からどのくらい離れているのが典型的か?
分散は距離である
セントロイド(重心)は、形状がバランスを取る場所を教えてくれます。しかし、形状がどれほど広い(ばらついている)かについては何も言いません。平均値が完全に一致する2つのデータセットでも、見た目は全く異なる場合があります。一方は中心の周りに密に集まっており、もう一方は広く散らばっています。
標準偏差(シグマ)は分散を測定する: 実質的に、それは値が平均値からどれだけ離れているかの典型的な距離である。シグマが小さいと、中心に密着した細かく高い形状になる。シグマが大きいと、両側に大きく広がる平らで広い形状になる。
2人のアーチャー(的射ち)を考えてみよう。どちらも平均して的の中心を射抜いている:彼らの重心(セントロイド)は的の中心(ブルズアイ)にある。アーチャーAはすべての矢を中心から手のひら幅以内に集める(シグマが小さい)。アーチャーBは矢を的全体に散らすが、外れが相殺されるため、平均値は依然として中心を示す(シグマが大きい)。平均値は同じだが、分散は正反対である。平均値だけでは彼らを区別できないが、標準偏差なら区別できる。
幾何学的には、シグマは分布の水平方向のスケールを設定する。バランスポイント(中心)を動かさずに形状を横に広げると、平均値を固定したままシグマが上昇する。その1つの数値、すなわち形状の幅こそが、次の概念の基盤となるものである。
同じ中心、異なる幅
2つの工場がそれぞれ、平均重量500グラムの袋に詰め物を行っている。工場Aの標準偏差は4グラムである。工場Bの標準偏差は20グラムである。
顧客は、500グラムから15グラム以上ずれた袋をすべて拒否する。
nの平方根の1倍に比例して縮む誤差
データの分散から推定値の分散へ
あなたはめったに母集団全体を測定しない。サンプルを取り、その平均を推定値として計算する。別のサンプルを取ると、わずかに異なる平均が得られる。これらの標本平均には独自の形がある:サンプリング分布であり、真の平均を中心にしている。
その幅には名前があります:平均の標準誤差です。
SE = sigma / sqrt(n)
ここで、sigma は個々の値のばらつき、n はサンプルサイズです。標準誤差とは、サンプル平均と真の平均の間の典型的な距離であり、生データのばらつきではなく、あなたの推定値のばらつきです。
その幾何学的性質は、あの平方根の中にあります。SE は 1/n ではなく、1/sqrt(n) に比例して減少します。より多くの測定値を平均化するとサンプリング分布は狭くなりますが、その効果は逓減します。新しい観測値を1つ加えるごとに、得られる幅の狭まりは前回のものより小さくなります。
率直な結果はこうです:標準誤差を半分にするには、サンプルサイズを4倍にしなければなりません。n = 100 から n = 200 にしても、誤差は半分になりません。n = 400 が必要なのです。精度は、平方根に比例してスケールするため、非常に高価です。
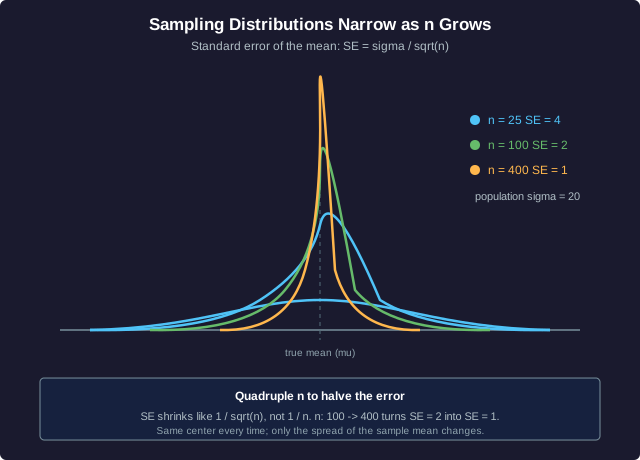
上記の曲線は、すべて同じ中心を持ち、sigma が 20 に固定された状態で、n が 25 から 100、そして 400 に増加するにつれて幅が狭くなります。それぞれの SE を読み取ると、4、次に 2、そして 1 となります。
標準誤差を計算する
あるテストスコアの母集団の標準偏差は sigma = 20 です。サイズ n = 100 のサンプルを抽出し、その平均を計算します。
軸が嘘をつくとき
歪められた幾何学
チャートは幾何学的な翻訳です。数値が長さ、面積、傾きとなり、視覚が瞬時に読み取ります。この翻訳を歪めれば、視覚はデータが決して語っていない嘘を報告します。
切り詰められた軸。 棒グラフでは、棒の高さが値に比例するように、値の軸をゼロから始めるべきです。軸を0ではなく95から始めると、100から102への増加(実際の変化は2パーセント)が、巨大な変化であるかのように画面を埋め尽くして見えます。プロットされた長さがもはや数値の比率と一致しなくなります。折れ線グラフでも同じトリックがすべての傾きを急峻に見せます。垂直方向のスケールが狭い範囲に圧縮されているため、緩やかな上昇が断崖絶壁のように見えます。
傾きの誇張。 傾きとは、変化量(rise)を変化幅(run)で割ったものです。軸がカバーする範囲(表示される値の幅)を縮小し、ピクセルの高さを固定したままにすると、すべての変化がより急峻に描き直されます。トレンド自体は変わっていません。変わったのはフレームの幾何学だけです。
面積と長さの歪み。 数量が2倍になったことを示す場合、誠実なチャートは1つの次元を2倍にします。例えば、2倍の高さの棒です。不誠実なチャートは、アイコンや円を幅と高さの両方でスケーリングするため、2倍の値が4倍の面積を持つ図形になります。視覚は面積を判断するため、2倍の増加が4倍の増加のように見えます。バブルチャートは、値を面積ではなく半径にマッピングするため、この歪みを頻繁に悪用しています。面積は半径の二乗に比例して増加するためです。
プロの習慣:軸がどこから始まっているかを確認し、値が長さでエンコードされているか面積でエンコードされているかを確認し、形状を信頼する前に頭の中で再スケーリングを行います。
歪みの診断
ダッシュボードには、四半期ごとの売上が1億から1.04億に増加していることが示されています。この増加を劇的に見せるために、デザイナーは縦軸の起点を0ではなく98に設定しました。もう一つのパネルでは、同じ4パーセントの増加を、金袋のアイコンの幅と高さの両方を4パーセント拡大して描くことで表現しています。
形状、分布、誤差、軸
実務への応用
自動ダッシュボードは、図形の描画を代行してくれます。棒グラフを描き、曲線を当てはめ、トレンドをアニメーション表示します。しかし、それらが幾何学的な構造を判断力を持って読み解くことはできません。それはプロフェッショナルの役割です。
訓練された読み手は、あらゆるチャートに対して4つのチェックを行います。
- 重心(Centroid)。 形状のバランスはどこにありますか。歪み(スキュー)が平均値を中央値から引き離していませんか。単一に報告された平均値は、片寄った現実を隠蔽している可能性があります。
- 分布(Spread)。 形状の幅はどのくらいですか。大きな分散に基づいて構築された、自信に満ちたように見える平均値は、スーツ姿のコイン投げに過ぎません。
- サンプリング誤差。 サンプルサイズ n はどのくらいでしたか。推定値には sigma/sqrt(n) の標準誤差が伴い、サンプルが極端に小さい場合、ヘッドラインの数値がどれほど鮮明に見えても、信頼性の低い広い区間しか得られません。
- 軸の幾何学。 値の軸はゼロから始まっていますか。量は長さとして、それとも面積としてエンコードされていますか。操作された軸は、端数の誤差を革命へと変えてしまいます。
ダッシュボードが提示するのは「絵」です。あなたが供給すべきは「不信感」です。軸の幾何学的構造が操作されていたり、サンプルサイズが小さすぎたりするチャートは、どれほど洗練されて見えても、懐疑の対象となります。
このダッシュボードを読む
あるスタートアップのダッシュボードはこう宣言しています:「1ユーザーあたりの平均収益は、今四半期に急上昇した」。しかし注釈にはこう書かれています:その平均は n = 9 のユーザーというサンプルから算出されたもので、そのうち2つは巨大なエンタープライズアカウントであり、棒グラフの軸は前四半期の値の90パーセントから始まっています。
統計の幾何学:まとめ
学んだこと
統計は、数字という衣装をまとった幾何学です:
- 平均は重心です:データのバランスの中心点です。偏り(スキュー)はその支点を長い尾側へ引き寄せます。そのため、右に偏った分布では、平均値は中央値より大きくなります。中央値は位置のみを数えるため、その引き寄せに抵抗します。
- 標準偏差は分散です:中心からの典型的な距離、つまり形状の幅です。2つの分布が同じ平均値を共有していても、値がどれだけ散らばっているか(分散の度合い)は大きく異なる可能性があります。
- サンプリング誤差は sigma/sqrt(n) です:標本分布の幅です。これは 1/sqrt(n) に比例して縮小するため、誤差を半分に減らすには、サンプルサイズを4倍にする必要があります。精度は平方根によって買われます。
- 軸の幾何学は嘘をつく可能性があります:切り詰められた軸は、長さと値の対応を切り離し、傾きを急峻に見せます。また、アイコンを2次元で拡大すると、面積は倍率の二乗に比例して大きくなるため、視覚的には倍の増加が4倍の増加として読み取られてしまいます。
自動ダッシュボードが図形を描く。プロフェッショナルはそれを解釈する:重心を特定し、ばらつきを測定し、サンプリング誤差を重み付けし、軸の幾何学が歪められたグラフは疑う。図は床であり、判断が天井である。