Een verdeling is een vorm
Statistiek heeft een geometrie
Elke dataset heeft een vorm. Teken de waarden op een getallenlijn en stapel een balk op waar ze zich concentreren, dan verschijnt een silhouet: een bult, een scheve kant, een lange staart. Statistiek geeft die vorm coördinaten.
Twee kenpunten lokaliseren het midden van de vorm.
Het gemiddelde is het zwaartepunt: het evenwichtspunt. Stel je voor dat elke datawaarde een gelijk gewicht is dat op een wieg ligt, uitgestrekt langs de getallenlijn. Het gemiddelde is het enkele draaipunt waar de wieg in evenwicht is. Waarden ver van het midden oefenen hefbomen uit, precies zoals een zwaar kind ver op een wieg doet: afstand vermenigvuldigd met gewicht.
De mediaan is het midden qua aantal: de waarde waar de helft van de data onder en de andere helft boven ligt. Het draait alleen om volgorde en aantal, nooit om hoe ver een waarde zich bevindt.
Bij een perfect symmetrische vorm vallen het draaipunt en het midden samen: het gemiddelde is gelijk aan de mediaan. Breek de symmetrie en ze scheiden.
Scheefheid is die verbroken symmetrie. Een rechterse schuine verdeling heeft een lange staart die zich uitstrekt naar hoge waarden (een paar miljardairs in een inkomensdataset). Die ver uitlopende gewichten trekken het evenwichtspunt naar de staart, waardoor het gemiddelde rechts van de mediaan komt te liggen. Een linkerse schuine verdeling is de spiegelbeeld.
Dit is waarom het mediane huishoudinkomen en het gemiddelde huishoudinkomen verschillen: de geometrie van een scheve vorm trekt het zwaartepunt weg van het midden qua aantal.
Welke kant op beweegt het gemiddelde?
Een stad rapporteert de inkomens van de huishoudens. De meeste gezinnen verdienen tussen de 40.000 en 90.000, maar een handvol inwoners verdient meerdere miljoenen. De inkomensverdeling heeft een lange staart die naar rechts reikt.
Hoe ver van het centrum is typisch?
Spreiding is een Afstand
Het zwaartepunt (centroïde) vertelt je waar de vorm in evenwicht is. Het zegt niets over hoe breed de vorm is. Twee datasets kunnen een identiek gemiddelde delen en toch totaal anders uitzien: de ene is strak rond het centrum gepakt, de andere is wijd uitgestrooid.
De standaardafwijking (sigma) meet de spreiding: dit is, in feite, de typische afstand van een waarde tot het gemiddelde. Een kleine sigma betekent een smalle, hoge vorm die dicht bij het centrum blijft. Een grote sigma betekent een brede, vlakke vorm die ver uitstrekt aan beide zijden.
Stel je twee boogschutters voor. Beiden hebben een gemiddelde op het middendoel: hun zwaartepunt zit op de roos. Boogschutter A schiet alle pijlen binnen een handbreedte van het centrum (kleine sigma). Boogschutter B verspreidt pijlen over het hele doel, maar de afwijkingen heffen elkaar op, zodat het gemiddelde toch op het midden uitkomt (grote sigma). Zelfde gemiddelde, tegengestelde spreiding. Het gemiddelde alleen kan ze niet van elkaar onderscheiden; de standaardafwijking kan dat wel.
Geometrisch bepaalt sigma de horizontale schaal van de verdeling. Rek een vorm breder uit zonder het evenwichtspunt te verplaatsen, en je verhoogt de sigma terwijl het gemiddelde vast blijft. Dat ene getal, de breedte van de vorm, is waar het volgende idee op is gebaseerd.
Zelfde centrum, verschillende breedte
Twee fabrieken vullen elk zakken met een gemiddeld gewicht van 500 gram. Fabriek A heeft een standaardafwijking van 4 gram. Fabriek B heeft een standaardafwijking van 20 gram.
Een klant weert elke zak af die meer dan 15 gram afwijkt van 500 gram.
De fout die afneemt als 1 over wortel-n
Van spreiding van data naar spreiding van een schatting
Je meet zelden een hele populatie. Je neemt een steekproef en berekent het gemiddelde ervan als schatting. Neem een andere steekproef en je krijgt een iets ander gemiddelde. Die steekproefgemiddeldes hebben een eigen vorm: de steekproefverdeling, gecentreerd op het werkelijke gemiddelde.
Deze breedte heeft een naam: de standaardfout van het gemiddelde.
SE = sigma / sqrt(n)
waarbij sigma de spreiding van de individuele waarden is en n de steekproefgrootte. De standaardfout is de typische afstand tussen een steekproefgemiddelde en het werkelijke gemiddelde: het is de spreiding van je schatting, niet van de ruwe data.
De geometrie zit in die wortel. SE daalt als 1/sqrt(n), niet als 1/n. Het gemiddeld nemen van meer metingen verkleint de steekproefverdeling, maar met afnemende opbrengst: elke nieuwe waarneming levert minder verkleining op dan de vorige.
Het onomwonde gevolg: om de standaardfout te HALVEREN moet je de steekproefgrootte VERVIERVOUDIGEN. Van n = 100 naar n = 200 halveert je fout niet; je hebt n = 400 nodig. Precisie is duur, omdat deze schaalt met de wortel.
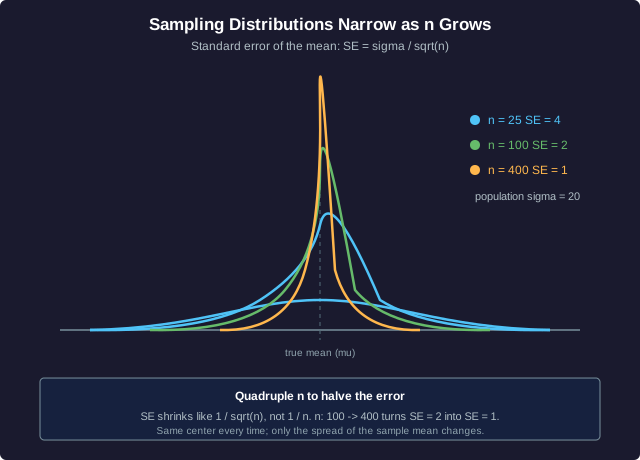
De curven hierboven delen één centrum en worden in breedte kleiner naarmate n stijgt van 25 naar 100 naar 400, waarbij sigma op 20 blijft. Lees de SE af bij elk: 4, dan 2, dan 1.
Bereken de Standaardfout
Een populatie testresultaten heeft een standaardafwijking sigma = 20. Je trekt een steekproef van grootte n = 100 en berekent het gemiddelde ervan.
Wanneer de as liegt
Gemanipuleerde geometrie
Een grafiek is een geometrische vertaling: getallen worden lengtes, oppervlaktes en hellingen die het oog direct leest. Manipuleer de vertaling en het oog rapporteert een leugen die de data nooit vertelde.
Afgekapt assen. Een staafdiagram moet zijn waardenas bij nul starten, zodat de staafhoogte evenredig blijft met de waarde. Start de as bijvoorbeeld bij 95 in plaats van 0, en een stijging van 100 naar 102 (een echte verandering van 2 procent) vult het kader alsof het enorm was. De geplote lengtes komen niet meer overeen met de verhoudingen van de getallen. In een lijndiagram maakt dezelfde truc elke helling steiler: een zachte stijging leest als een klif omdat de verticale schaal op een smal venster werd samengeperst.
Hellingvergroting. Helling is stijging over loop. Verminder het bereik dat de as beslaat (de loop van waarden die hij toont) terwijl de pixelhoogte vast blijft, en elke stijging wordt steiler getekend. De trend is niet veranderd; alleen de geometrie van het kader is veranderd.
Oppervlakte-lengte-verbuiging. Om een verdubbeling van een grootheid te tonen, verdubbelt een eerlijke grafiek EEN dimensie: een staaf die tweemaal zo hoog is. Een oneerlijke grafiek schaalt een pictogram of cirkel in ZOWEL breedte als hoogte, zodat een 2x-waarde een afbeelding wordt met 4x het oppervlak. Het oordeelt naar oppervlak, dus een verdubbeling lijkt een verviervoudiging. Bubbelgrafieken misbruiken dit constant wanneer ze waarde op straal in plaats van op oppervlaktoekennen, aangezien oppervlak groeit met het kwadraat van de straal.
De professionele gewoonte: controleer waar de as begint, controleer of lengte of oppervlak de waarde codeert, en schaal mentaal om voordat je de vorm vertrouwt.
Diagnosticeer de verbuiging
Een dashboard toont een kwartaalopbrengst dat stijgt van 100 naar 104 miljoen. Om de winst dramatisch te laten lijken, begint de ontwerper de verticale as bij 98 in plaats van 0. Een tweede paneel stelt dezelfde winst van 4 procent voor door een icoon van een geldzak 4 procent te vergroten in ZOWEL breedte als hoogte.
De vorm, de spreiding, de fout, de as
Het thuisbrengen
Gedigitaliseerde dashboards tekenen de vorm voor u. Ze renderen de balken, passen de curve aan en animeren de trend. Wat ze niet kunnen, is de meetkunde met oordeelkracht lezen. Dat is het werk van de professional.
Een getrainde lezer voert vier controles uit op elke grafiek:
- Centroid. Waar is het zwaartepunt van de vorm, en trekt een scheefheid het gemiddelde weg van de mediaan? Een enkel gerapporteerd gemiddelde kan een scheve werkelijkheid verbergen.
- Spreiding. Hoe breed is de vorm? Een zelfverzekerd ogend gemiddelde, gebouwd op een enorme variantie, is een muntworp in een pak.
- Stekingsfout. Hoe groot was n? De schatting heeft een standaardfout van sigma/sqrt(n), en een klein steekproefomvang betekent een brede, onbetrouwbare interval, hoe scherp het kopcijfer ook lijkt.
- Asmeetkunde. Begint de waardenas op nul? Wordt de groote als lengte of als oppervlakte gecodeerd? Een gefrikkelde as verandert een afrondingsfout in een revolutie.
Het dashboard levert het beeld. Jij levert het wantrouwen. Een grafiek waarvan de asgeometrie gefraudeerd is, of waarvan de steekproef te klein is, verdient scepsis, hoe gepolijst het er ook uitziet.
Lees dit dashboard
Het dashboard van een startup proclameert: het gemiddelde omzet per gebruiker is deze kwartaal GESPRENGEN. De kleine lettertjes: het gemiddelde is afgeleid uit een steekproef van n = 9 gebruikers, waarvan twee enorme enterprise-accounts zijn, en de as van de staafgrafiek begint op 90 procent van de waarde van het vorige kwartaal.
De meetkunde van de statistiek: Samenvatting
Wat je hebt geleerd
Statistiek is meetkunde die cijfers draagt:
- Het gemiddelde is een zwaartepunt: het evenwichtspunt van de data. Scheefheid trekt dat draaipunt naar de lange staart, dus een rechts-scheve verdeling heeft een gemiddelde > mediaan. De mediaan telt alleen posities, waardoor deze weerstand biedt tegen die trek.
- De standaardafwijking is spreiding: de typische afstand van het centrum, de breedte van de vorm. Twee verdelingen kunnen hetzelfde gemiddelde hebben, maar sterk verschillen in hoe ver hun waarden verspreid liggen.
- Steekproefsfout is sigma/sqrt(n): de breedte van de steekproefverdeling. Deze krimpt als 1/sqrt(n), dus om je fout te halveren kost je een viermaal zo grote steekproef. Precisie wordt gekocht met de wortel.
- Asmeetkunde kan liegen: een afgekapt as loskoppelt lengte van waarde en versterkt de helling; als je een icoon in twee dimensies schaalt, groeit het oppervlak met het kwadraat van de factor, zodat het oog een verdubbeling leest als een ver-vier-voudiging.
Gedigitaliseerde dashboards tekenen de vorm. De professional leest deze: het zwaartepunt lokaliseren, de spreiding meten, de steekproeffout afwegen en wantrouwen tonen jegens elke grafiek waarvan de asgeometrie is gemanipuleerd. Het beeld is de vloer; oordeel is het plafond.