결정은 하나의 형태입니다
선택에는 기하학적 구조가 있다
불확실성 하의 모든 결정은 가능한 수익을 수직선 위에 분산시킵니다. 어떤 결과물은 보상을 주고, 어떤 결과물은 비용을 발생시키며, 각각은 확률을 가집니다. 이 가중치 수익의 구름은 형태를 가지며: & 바로 그 형태가 실제로 결정하는 대상입니다.
그 형태의 첫 번째 랜드마크는 기대값(EV)입니다: 수익의 확률 가중 평균입니다.
EV = sum of p_i x_i
여기서 각 $x_i$는 수익(payoff)이고, 각 $p_i$는 해당 확률입니다. 이를 물리학에 비유해 보겠습니다. 수직선(number line) 위의 $x_i$ 위치에 질량 $p_i$를 놓는다고 상상해 보세요. 기댓값(expected value)은 중심(centroid)으로, 가중치가 적용된 수익들이 기울어지지 않고 균형 잡히는 단 하나의 균형점입니다.
더 무거운 확률(더 높은 확률)은 균형점을 해당 수익 쪽으로 당깁니다. 반면, 아무리 극단적인 결과라도 드물게 일어나는(확률이 낮은) 결과는 균형점을 거의 이동시키지 못합니다. 기댓값(EV)은 한 번의 시도에서 반드시 얻게 될 결과가 아닙니다. 그것은 얻을 수 있는 모든 결과의 질량 중심(center of mass)입니다.
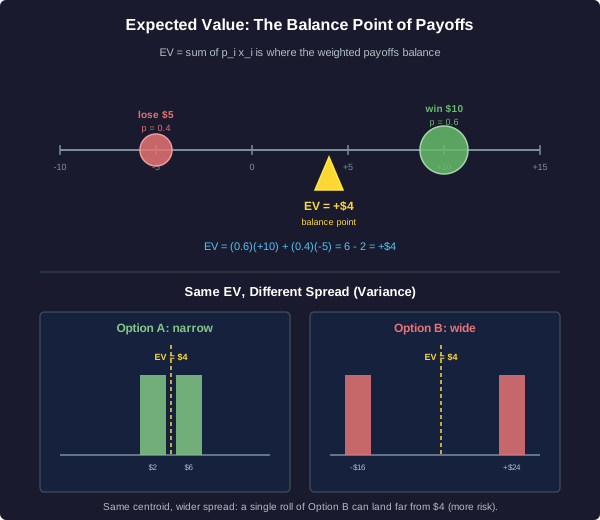
균형점 찾기
길거리 상인이 입장료가 무료인 게임을 제안합니다.
- 60%의 확률로 $10을 이깁니다.
- 40%의 확률로 $5를 잃습니다.
이기는 경우를 +10, 지는 경우를 -5로 취급합니다.
균형점만으로는 전체 이야기가 아닙니다
같은 중심, 다른 형태
중심(centroid)은 수익 분포 구름이 균형 잡히는 위치를 알려줍니다. 그러나 결과가 그 균형점에서 얼마나 흩어져 있는지에 대해서는 아무것도 말해주지 않습니다. 그 흩어짐의 정도는 분산(spread)이며, 분산(variance)으로 측정됩니다. 분산은 각 수익이 중심점에서 떨어진 거리의 제곱 평균입니다.
두 가지 옵션은 동일한 기대값을 가질 수 있으면서도 완전히 다른 형태를 가질 수 있습니다:
- 옵션 A: $2를 받을 확률 50%, $6을 받을 확률 50%. EV = 0.5(2) + 0.5(6) = $4.
- 옵션 B: -$16을 받을 확률 50%, $24를 받을 확률 50%. EV = 0.5(-16) + 0.5(24) = $4.
둘 다 $4에서 균형을 이룹니다. 하지만 옵션 A의 결과는 중심에 가깝게 모여 있는 반면, 옵션 B의 결과는 양쪽으로 멀리 흩어져 있습니다. 기하학적으로 A는 좁은 형태이고 B는 넓은 형태입니다.
수천 번 반복하는 결정의 경우, 분산은 종종 상쇄되어 중심값이 지배적입니다. 하지만 일회성(one-shot) 결정의 경우, 분산이 모든 것입니다: 단 하나의 결과만 얻게 되며, 옵션 B에서 단 하나의 결과만 -$16에 떨어질 수 있습니다. 기대값은 어떤 한 번의 시도에서 평균이 반드시 나타날 것이라고 약속하지 않습니다.
한 번의 시도만
옵션 A 또는 옵션 B를 선택해야 하며, 한 번만 플레이할 수 있습니다. 두 번째 기회는 없습니다.
- 옵션 A: 50% 확률로 $2, 50% 확률로 $6.
- 옵션 B: 50% 확률로 -$16, 50% 확률로 $24.
둘 다 기댓값(EV) = $4입니다.
선택이 뒤바뀌는 선
더 나은 것이 더 나빠지는 곳
제어할 수 없는 것들(확률, 가격, 수요 수준 등) 위에 옵션을 배치해 보세요. 그 불확실성의 공간은 특성 공간(feature space)입니다. 그 안에서는 한 옵션이 일부 영역에서 더 좋고, 다른 옵션이 다른 영역에서 더 좋습니다. 그 영역들을 나누는 표면은 결정 경계(decision boundary)입니다: 두 옵션의 기대 가치가 정확히 동일한 점들의 집합입니다.
경계의 한쪽에서는 옵션 1을 선택합니다. 경계를 건너면 옵션 2가 이깁니다. 경계 자체는 무관심의 칼날과 같은 지점입니다.
1차원 예제를 살펴보겠습니다. $1,000짜리 자전거가 도난당할 수 있습니다. 보험사가 $100의 보험료로 전액 보장을 제공합니다.
- 보험에 가입하지 않음: 기대 비용 = p x 1000 (여기서 p는 도난 확률).
- 보험 가입: 비용 = 100, 어떤 상황이든 동일.
경계는 두 기대 비용이 만나는 도난 확률 p입니다: p x 1000 = 100. p 미만에서는 평균적으로 자가 보험(자가 부담)이 더 저렴합니다. p 초과에서는 보험 가입이 유리합니다. 이 단일 숫자 p는 전체 확률 선을 '보험 미가입 영역'과 '보험 가입 영역'으로 나눕니다.
경계값 구하기
동일한 설정: 도난 시 손실 $1,000, 전액 보장을 위한 보험료 $100.
보험에 가입하지 않으면 평균적으로 p x 1000의 비용이 듭니다. 보험에 가입하면 고정 비용 100이 듭니다.
한 선택지가 모든 면에서 이길 때
모든 측면에서 더 나은 선택지
때로는 확률이 전혀 필요하지 않을 수 있습니다. 각 옵션을 당신이 중요하게 여기는 요소(예: 가격, 배터리 수명, 저장 용량)를 축으로 하는 공간에 배치해 보세요. 한 옵션이 모든 축에서 동시에 다른 옵션보다 우월하다면, 그것은 그것을 지배(dominates) 합니다. 이를 파레토 지배(Pareto dominance) 라고 합니다.
지배되는 옵션은 축의 가중치나 확률에 관계없이 결코 이길 수 없습니다. 왜냐하면 미래가 어떻게 변하든, 지배하는 옵션은 해당 차원에서도 이미 더 나았기 때문입니다. 지배되는 옵션은 어떤 계산도 하지 않고 바로 제외할 수 있습니다.
두 개의 스마트폰을 비교해 보겠습니다:
- 스마트폰 A: 200달러, 12시간 배터리, 128 GB.
- 스마트폰 B: 250달러, 10시간 배터리, 64 GB.
스마트폰 A는 가격이 더 저렴하고, 배터리가 더 오래 지속되며, 저장 용량도 더 큽니다. 세 가지 축 모두에서 A가 이기므로 A가 B를 지배합니다. 확률도, 기대값도, 트레이드오프 가중치도 필요 없습니다: A가 단순히 더 나은 것입니다.
지배는 드물고 귀한 것입니다. 대부분의 실제 선택은 트레이드오프입니다: 더 저렴하지만 느리고, 더 안전하지만 작습니다. 한 옵션이 한 축에서는 이기면서 다른 축에서는 지는 순간, 지배는 사라지고 다시 축을 가중하고, 확률을 부여하고, 기대값을 비교하는 과정으로 돌아갑니다.
지배 관계 찾기
두 대의 노트북을 고려해 보자:
- 노트북 A: $900, 배터리 8시간, 1.4 kg.
- 노트북 B: $1,100, 배터리 6시간, 1.8 kg.
가벼울수록 좋고 배터리가 오래 지속될수록 좋다고 가정하자.
단일 점 추천 뒤에 숨겨진 형태
숫자 하나만으로는 결정이 되지 않습니다
자동 추천 시스템은 하나의 점으로 답변하도록 설계되어 있습니다: 이것을 사세요, 이 경로로 가세요, 그 것을 승인하세요. 단일 선택은 표시하기도 쉽고 행동하기도 쉽습니다. 하지만 그 점은 원래 형태가 만든 그림자에 불과합니다. 그것은 여러분이 배워서 보게 된 모든 것을 가립니다.
전문가는 그 점에서 멈추지 않습니다. 추천을 신뢰하기 전에, 그 뒤에 있는 기하학을 재구성합니다:
- 중심(기대값): 그 선택이 가장 높은 기대값을 추구하고 있는가? 중심은 장기적인 평균이지, 한 번의 시도 결과물이 아님을 기억하세요.
- 분산(Spread, variance): 두 옵션은 동일한 기댓값(EV)을 공유하더라도 위험도는 극단적으로 다를 수 있습니다. 단일 점 추천은 개별 결과가 얼마나 크게 벗어날 수 있는지에 대해 아무것도 말해주지 않으며, 이는 일회성 결정에서 결정적입니다.
- 경계(Boundary): 이 결정이 뒤집히는 지점에 얼마나 가까운가? 입력값이 결정 경계에 가까우면 추정치에 대한 작은 오류가 올바른 선택을 뒤집을 수 있으며, 확신 있어 보이는 선택지는 실제로는 취약합니다.
중심(centroid), 분산(spread), 경계(boundary)를 함께 보는 것은 전체 보상 기하학을 보는 것입니다. 추천은 좌표일 뿐이며, 전문가가 원하는 것은 지도입니다.
추천 뒤에 숨겨진 것을 읽기
자동화 도구가 옵션을 분석하고 한 줄을 출력합니다: "권장 선택지: 옵션 3."
분포, 위험 밴드, 민감도 분석을 보여주지 않습니다.
결정의 기하학: 요약
배운 내용
불확실성 하의 결정은 하나의 형태(shape)이며, 이 형태를 설명하는 네 가지 랜드마크가 있습니다:
- 기대값(Expected value)은 중심(centroid)입니다: EV = sum of p_i x_i, 확률로 가중된 결과(payoffs)의 균형점입니다. 더 높은 확률은 균형을 해당 결과 쪽으로 끌어당깁니다.
- 위험은 분산된다: 분산(variance)은 결과가 중심(centroid)에서 얼마나 흩어져 있는지를 측정한다. 두 선택지가 동일한 기대값(EV)을 공유하더라도 위험도는 다를 수 있으며, 일회성 결정에서 더 넓은 분산은 훨씬 더 나쁠 수 있다.
- 결정 경계는 뒤집어지는 선이다: 두 선택지의 기대값이 동일한 점들의 집합이다. 이 경계를 넘으면 더 나은 선택이 역전되며, 경계 근처의 결정은 취약하다.
- 우월성에는 확률이 필요 없다: 한 선택지가 모든 축에서 이기면, 그것은 우월하며, 가중치나 기대값 없이도 선택할 수 있다.
자동화 시스템은 점을 전달한다. 전문가는 전체 기하학을 본다: 중심, 분산, 그리고 경계가 함께. 추천은 좌표이며, 지혜는 그것이 온 지도를 읽는 것이다.