單一來源僅是一條線
像測量員一樣定位真相
想要確定遠處火災位置的測量員,無法僅從單一觀測塔完成。一座塔提供一個方位:一個方向,指向煙霧的羅盤角度。方位是一條線,而非一個點。火災可能位於該線上的任何位置,近處或遠處皆可。
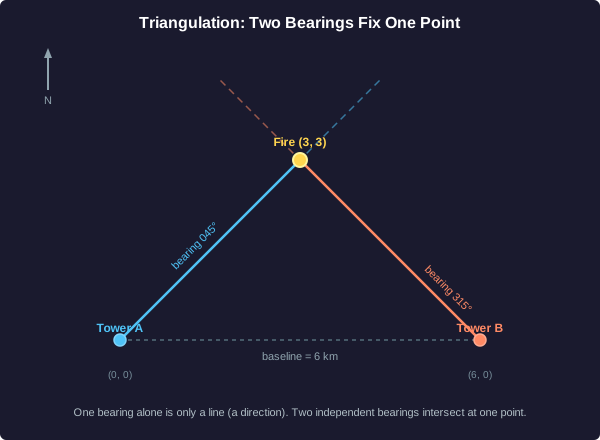
要鎖定火災位置,你需要來自另一座塔的第二個獨立方位。每個方位都是一條線;兩條不平行的線精確相交於一個點。該交點即為定位點。這就是三角測量,也是所有驗證的形狀:單一來源指出方向,獨立來源在真相處相交。
座標設定
將 A 塔 設於原點 (0, 0),B 塔 設於 (6, 0),使兩塔沿東西向基線相距 6 公里。設東方為 +x 方向,北方為 +y 方向。方位角從正北方向起順時針計算。
方位角 045 度 指向正東北方向:東方與北方的增加速率相同。因此,從 A 塔出發、方位角為 045 度的視線方程為 y = x。
方位角 315 度 指向正西北方向:北方增加,而東方以相同速率減少。因此,從 B 塔(起始於 x = 6)出發的視線方程為 y = 6 - x。
兩條直線,一個未知點。這已足夠求解。
定位火點
A 塔報告煙霧的方位角為 045 度。B 塔報告同一煙霧的方位角為 315 度。
兩條視線分別為 y = x(來自 A 塔)和 y = 6 - x(來自 B 塔),距離單位為公里,東方為 +x,北方為 +y。
測量是一個區域,而非一個點
實際方位是模糊的
乾淨的交集假設每個方位角都是一條完美的直線。但現實中的儀器並非完美。羅盤讀數為 045 度,實際意義是「045 度附近的一個狹窄扇形區域內」。測量值不是一個點;它是一個區域:一個區間、一條誤差棒、或一個置信區域,指出真實值可能存在的範圍。
當兩個獨立的測量值各自帶有區域時,真實值很可能位於這些區域重疊的地方:即交集。兩個模糊扇形的交集比單獨任一扇形都小,因此結合獨立測量值可以縮小不確定性。這相當於使用粗線進行三角測量:即使方位角模糊不清,交叉後也能將真實值限制在一個小區域內。
危險信號
如果一個聲明僅以單一自信數值報告,且完全沒有誤差區域,這是一個警告信號。沒有區域,你無法區分精確的測量值與隨機的猜測:兩者看起來都像是一個裸數。誠實的估計值會伴隨其不確定性。沒有誤差棒的數字,隱藏了它有多不確定。
獨立性至關重要。如果兩個測量值共享相同的缺陷,它們的重疊不會導致更小的真實值範圍;它們只是在相同的錯誤上達成一致。這些區域必須來自真正獨立的方法。
為何重疊優於裸數
兩個獨立的實驗室估計同一個量。實驗室 1 報告了一個帶有誤差區域的值;實驗室 2 使用完全不同的方法,報告了其自身的值及其誤差區域。這兩個區域部分重疊。
相信群聚,質疑離群值
獨立估計值的群聚
向多個獨立來源詢問同一個量,並將它們的答案繪製在直線上。當估計值緊密群聚(分佈範圍小)時,你可以信任群聚的中心:許多獨立的路徑抵達了幾乎相同的位置,這很難是偶然造成的。
一個與所有其他結果距離遙遠的單一自信答案,是一個孤立的離群值。它可能是一項突破,但更常見的情況是,它是一個錯誤、回答了不同的問題,或者來源本身就是錯誤的。正因為它與共識相悖,離群值贏得的不是信任,而是審查。
平均化縮小分散度
為什麼一簇獨立的估計值能勝過其中任何一個?因為平均化抵消了獨立的噪音。如果單一讀數的標準差(分散度)為 sigma,那麼 n 個獨立讀數的平均值的標準差為:
sigma / sqrt(n)
方差以 1/n 的速度下降,標準差以 1/sqrt(n) 的速度下降。四個獨立讀數將分散度減半(sqrt(4) = 2)。一百個讀數將其縮小至十分之一(sqrt(100) = 10)。獨立的觀察次數越多,噪音越小,圍繞真值的簇就越緊密。
平均化能帶來多大幫助?
一個儀器測量一個固定量,帶有隨機且獨立的噪音。單一讀數的標準差為 10 個單位。沒有偏誤:讀數圍繞真值對稱分佈。
投影到真實方向
訊號是一個方向;噪聲指向四面八方
想像每個測量值都是一支箭。每支箭都是訊號(真值,指向一個固定的方向)加上一支指向隨機方向的噪聲箭,每次方向都不同。單個測量值是訊號加上一個隨機衝擊:你無法看出哪部分是哪部分。
對許多獨立的測量值取平均時,所有指向同一方向的訊號箭頭會累加。而指向四面八方雜亂無章的雜訊箭頭則大致抵銷。最終留存下來的是在真實方向上的投影:訊號隨 n 增長,而雜訊僅隨 sqrt(n) 增長,因此訊號與雜訊的比值會以 sqrt(n) 的速度改善。這正是從另一個角度看待的 1/sqrt(n) 定律。
這就是為什麼獨立性至關重要。如果雜訊箭頭都指向相同的方向(例如來源彼此抄襲,或存在共同的偏誤),它們不會抵銷,而是會像訊號一樣累加。十份來自同一來源的資料,本質上仍只是一個方位。唯有真正獨立的觀測,才能讓雜訊在平均過程中消失。
因此,整套工具本質上就是一幅幾何圖景:獨立的方位線在真值處相交,獨立的誤差區域重疊成更小的區域,而獨立的測量值則將雜訊平均至趨近於零。驗證的藝術,在於針對同一個點,獲取多於一個誠實的方向。
一個自信的答案只是一個方位
現代驗證問題
自動化系統如今產生了商業與知識工作中大多數的初稿答案:一個價格、一份摘要、一個診斷、一個引用、報告中的一個數字。每個答案都顯得流暢且自信。但流暢不等於準確,自信也不代表第二個來源。每個自動化答案恰好是一個方位:一條線、一個方向,而非一個確定的點。
謹慎的專業人士不會將一條自信的線誤認為一個確定的點。他們會三角定位:獲取第二個、第三個獨立的方位。他們檢視這些獨立答案的分散度。他們信任緊密的聚落,並將那些遠離其他所有答案、孤立的自信答案視為需要檢查的離群值,而非可直接交付的真理。
他們守護獨立性。一個僅僅重複第一個來源的第二來源(相同的數據、相同的方法、相同的自動化起源)根本算不上第二個方位。它只是同一條線畫了兩次。
專業人士接下來會做什麼
你向一個自動化系統提出一個事實性問題。它回傳了一個自信、流暢且具體的答案,沒有錯誤區域,也沒有來源。
驗證即幾何 — 摘要
你已學到的內容
知道何者為真,其形態如同定位一個點:
- 三角測量:單一來源提供的是方位(bearing),是一條線,而非一個點。獨立的方位線在真值處相交。兩座塔將火點定位在 (3, 3);單一塔永遠無法做到。
- 誤差區域:真實的測量是一個區域,而非一個點。獨立的區域重疊形成較小的交集,從而收緊真值的範圍。任何沒有誤差區域的聲稱都是危險信號。
- 收斂與孤立的離群值:緊密聚集的獨立估計值得信賴;孤立的自信數值則值得審視。平均值會像 1/sqrt(n) 一樣縮小分散度。
- 訊號與雜訊:訊號箭頭相加,獨立的雜訊箭頭相消,因此訊號雜訊比(SNR)會像 sqrt(n) 一樣改善。只有真正獨立的觀測,才能讓雜訊被平均掉。
自動化系統整天都會給你流暢且自信的第一稿。每一份都是一個方位。專業人士不會將單一線段誤認為定位點:他們進行三角測量,閱讀分散度,信任聚集的群體,懷疑孤立的離群值,並守護每個來源的獨立性。