Minnet försvinner enligt en kurva
Glömskan har en form
Under 1880-talet memorerade Hermann Ebbinghaus meningslösa stavelser och testade sig själv vid ökande tidsintervall. Hans data skissade en kurva som återkommer i modern minnesforskning: behållningen börjar hög, sjunker snabbt och planar sedan ut när den närmar sig noll.
Den formen har ett namn: exponentiell nedbrytning. En ren modell av det:
R = e^(−t/S)
där R är retention (det andel av minnet som fortfarande kan återkallas, från 1 ner till 0), t är tiden sedan studien, och S är stabilitet: ett tal, mätt i samma enheter som t, som bestämmer hur långsamt minnet försvinner.
Läs geometrin direkt från exponenten t/S. Rätt efter studien är t = 0, så R = e^0 = 1 (100 %). När t ökar, blir exponenten negativ och R glider mot 0 men når aldrig riktigt dit: kurvan planas ut till en lång svans.
Stabiliteten S styr brantheten. En liten S (t.ex. 1 dag) innebär att t/S ökar snabbt, så kurvan faller brant: du glömmer snabbt. En stor S (t.ex. 30 dagar) innebär att t/S ökar långsamt, så kurvan dämpas mjukt: minnet hänger kvar. Större S = planare kurva.
En milstolpe på varje dämpningskurva: retentionen når 50 % när t är lika med S multiplicerat med det naturliga logaritmet av 2 (S × ln2, och ln2 ≈ 0,693). Dubbla stabiliteten och du dubblar tiden till halvgömmande.
Att läsa två dämpningskurvor
Två fakta ligger i ditt minne, båda färska vid R = 100 %.
Faktum A har stabiliteten S = 2 dagar. Faktum B har stabiliteten S = 20 dagar.
Varje repetition gör kurvan flackare
Återkallande ökar stabiliteten
Här är upptäckten som förvandlar glömska till ett verktyg. Varje gång du framgångsrikt hämtar ett minne (återkallar det från en ledtråd, istället för att läsa om det) ökar dess stabilitet S. Det minne du just dragit tillbaka från glömskans kant kommer tillbaka starkare än tidigare.
Geometriskt gör en repetition två saker samtidigt: den nollställer R till 100 % & den ökar S så att den NÄSTA nedbrytningen blir långsammare. Plottar du detta över tid får du en saggtand: behållningen sjunker, en repetition drar tillbaka den till toppen, den sjunker igen men längs en mildare lutning, en ny repetition, ännu mildare. Tandarna blir bredare & den övergripande trenden blir plattare.
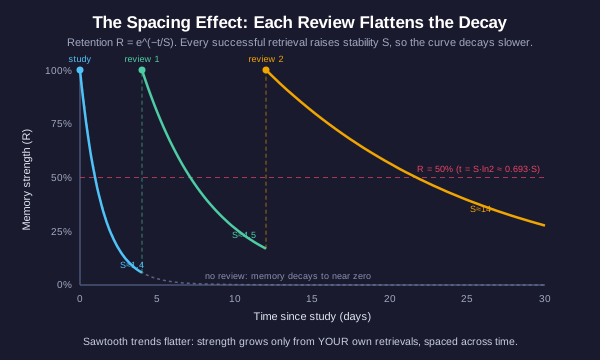
Det är därför spridning slår inlärning i sista stund. Inlärning i sista stund packar många hämtningar i en och samma session medan S fortfarande är liten, så de flyttar knappt kurvan, & nästa vecka har behållningen kollapsat. Spridning väntar tills R har sjunkit en bit (hämtningen känns ansträngande) och repeterar sedan, & det ansträngande draget tillbaka höjer S mest. Samma totala antal repetitioner, mycket högre långsiktig behållning: helt enkelt en fråga om NÄR du placerar dem längs kurvan.
Den idealiska repetitionen landar precis innan du skulle glömma: nära 50 %-marken, vid t ≈ S × ln2. Eftersom S växer, inträffar den stunden senare och senare, så repetitionsintervallen bör sträckas ut: 1 dag, sedan 3, sedan en vecka, sedan en månad. Kurvan berättar för dig när.
Varför saggtanden plattas ut
Du repeterar en fakta tre gånger, med spridning av repetitionerna som diagrammet visar.
Att lösa ut repetitionsdagen
När når behållningen 50 %?
Det bästa tillfället att repetera infaller när behållningen har sjunkit till ungefär hälften. Så en praktisk fråga: givet en stabilitet S, på vilken dag t blir R = e^(−t/S) lika med 0,50?
Sätt R = 0,5 & lös. Ta den naturliga logaritmen av båda sidor: ln(0,5) = −t/S. Eftersom ln(0,5) = −ln2, ger detta t = S × ln2, där ln2 ≈ 0,693.
Detta är exakt halveringstidsformeln från radioaktivt sönderfall: samma geometri styr både en avtagande isotop och ett avtagande minne. Båda förlorar en fast ANDRÅDEL per tidsenhet, så båda halveras med ett konstant intervall som bestäms av deras stabilitet.
Beräknat exempel: en sak med S = 5 dagar når 50 % behållning vid t = 5 × 0,693 = 3,47 dagar. Avrunda för att repetera den på dag 3 eller 4.
Beräkna halveringsdagen
En flashcard-sak har för närvarande stabiliteten S = 10 dagar, & den började med R = 100 %.
Avtagande avkastning & fördelen
Den andra kurvan
Glömska är inte den enda kurvan i lärande. Spårar du en färdighet mot övningstid får du lärkurvan: snabba framsteg i början, sedan långsammare framsteg när du klättrar, och en planing mot en plattning. Psykologerna kallar det praktikens potenslag: prestandan förbättras ungefär som en potens av antalet repetitioner, vilket ritar en kurva som böjer sig och planar ut.
Avtagande marginalnytta är geometrisk. I början är kurvan brant, så en timmes övning ger ett stort hopp. Längre upp har kurvan planat ut, så SAMMA timme ger ett mindre hopp. Du har inte slutat förbättra dig; lutningen där du nu befinner dig har helt enkelt blivit brantare. Den tionde timmen lägger till mindre än den första eftersom den landar på en flackare del av samma kurva.
Medveten övning flyttar hela kurvan, inte bara din punkt på den. Att slita på lätt material som du redan behärskar glider dig bara längre ut på den plana toppen: rörelse, liten vinst. Att öva på kanten av din förmåga (svårare problem, riktade svagheter, omedelbar feedback) gör något annat: det lyfter hela kurvan uppåt och höjer själva plåten. Du vandrar inte längs den gamla kurvan; du byter den mot en högre.
De två kurvorna hänger ihop. Medveten övning är ansträngt återkallande på kanten, & ansträngt återkallande är exakt det som höjer stabiliteten S i glömske modellen. Att arbeta på kanten planar ut glömsken OCH höjer lärandeplåten samtidigt.
Lutning & Förskjutning
En pianist har övat samma lätta skalor i ett år & slutat förbättra sig.
Automatisering planar ut ansträngningen och behållningen
Återkallandet tillhör dig
Alla resultat hittills beror på ett enda drag: DITT eget lyckade återkallande. Det ansträngande återhämtandet från glömskans kant är det som höjer stabiliteten S, planar ut nedbrytningskurvan och lyfter inlärningskurvan.
Automatiserade studieverktyg är lockande för att de planar ut ANSTRÄNGNINGEN. Ett verktyg kan sammanfatta kapitlet, visa svaret det ögonblick du tvekar eller lösa problemet åt dig. Arbetet känns lättare. Men geometrin är okänslig: om VERKTYGET gör återkallandet, stiger S aldrig. Du nollställer R till 100 % genom att läsa om, och sedan släcker samma branta kurva tillbaka dig till noll, eftersom inget ansträngt återkallande någonsin skedde. Sågtandmönster planar inte ut; det upprepar bara samma branta tand.
Detta är fällan. Ett verktyg som sänker ansträngningen till noll sänker också ditt minne till noll, eftersom de två drivs av samma handling. Bekvämlighet och hållbarhet drar åt motsatta håll här.
Används väl, hjälper samma verktyg: en schemaläggare för intervallrepetition som uppmuntrar dig att hämta fram information (och sedan kontrollerar dig) rider på den stigande S:en istället för att stjäla den. Gränsen är enkel: ett verktyg som får dig att hämta fram information bygger minne; ett verktyg som hämtar fram information för dig hyr ut en kopia som försvinner. Geometrin säger att styrkan bara växer genom dina egna lyckade hämtningar, utspridda över tid.
Den självförstörande genvägen
En studieapp visar automatiskt varje svar så fort ett kort öppnas, så du läser istället för att minnas.
Lärandets geometri, i en bild
Vad du har lärt dig
Både lärande och glömska har en form, och formerna är lektionen:
- Glömskorkvan R = e^(−t/S) förfaller exponentiellt. Stabiliteten S bestämmer brantheten: större S, flackare kurva. Retentionen halveras vid t = S × ln2 (ln2 ≈ 0,693).
- Avståndseffekten förvandlar glömska till ett verktyg: varje lyckad hämtning höjer S och gör nästa förfall flackare. Plottad över tid ser det ut som en sågtand där tänderna blir bredare, så repetitionsintervallen kan öka: 1 dag, 3 dagar, en vecka, en månad.
- Halveringstidsberäkningen hittar repetitionstillfället: för S = 10 dagar når retentionen 50 % vid t = 10 × 0,693 = 6,93 dagar. Samma matematik styr radioaktivt sönderfall.
- Lärläggan böjer sig in i avtagande avkastning eftersom du klättrar upp på en flackare lutning. Medveten träning vid förmågens gräns flyttar hela kurvan uppåt istället för att du glider längs den platta toppen.
- Bottenlinjen: varje en av dessa vinster drivs av DIN egen ansträngda, utrymda återkallande. Ett verktyg som får dig att återkalla bygger minnet; ett verktyg som återkallar åt dig plattar ut din ansträngning och ditt minnehåll till noll tillsammans.
Lär dig formerna, och placera sedan din ansträngning där kurvan belönar det: vid kanten, precis innan du glömmer, och gör återkallandet själv.