याददाश्त एक वक्र पर क्षय होती है
भूलने का एक आकार है
1880 के दशक में हेरमन एबिंगहाउस ने अर्थहीन ध्वनि-समूह (nonsense syllables) याद किए, फिर बढ़ते हुए विलंबों पर खुद का परीक्षण किया। उनके डेटा ने एक वक्र को रेखांकित किया जो आधुनिक याददाश्त शोध में बार-बार दिखाई देता है: रीटेंशन (retention) शुरू में उच्च होता है, तेजी से गिरता है, और फिर शून्य के करीब पहुंचते हुए स्थिर हो जाता है।
उस आकार का एक नाम है: घातांकीय क्षय (exponential decay)। इसका एक साफ मॉडल:
R = e^(−t/S)
जहाँ R प्रतिधारण (retention) है (यादों का वह अंश जो अभी भी याद है, 1 से 0 तक), t अध्ययन के बाद बीता हुआ समय है, और S स्थिरता (stability) है: एक संख्या, जो t के समान इकाइयों में मापी जाती है, जो यह निर्धारित करती है कि याद कितनी धीमी गति से मंद होती है।
घातांक t/S से ज्यामिति को सीधे पढ़ें। अध्ययन के तुरंत बाद, t = 0, इसलिए R = e^0 = 1 (100%)। जैसे-जैसे t बढ़ता है, घातांक ऋणात्मक होता जाता है और R शून्य की ओर सरकता है लेकिन कभी पूरी तरह तक नहीं पहुँचता: वक्र एक लंबे पूंछ में सपाट हो जाता है।
स्थिरता S तीव्रता को नियंत्रित करता है। एक छोटा S (मान लें 1 दिन) का अर्थ है कि t/S तेजी से बढ़ता है, इसलिए वक्र गिर जाता है: आप जल्दी भूल जाते हैं। एक बड़ा S (मान लें 30 दिन) का अर्थ है कि t/S धीमे से बढ़ता है, इसलिए वक्र धीरे-धीरे क्षय होता है: याद बना रहती है। बड़ा S = सपाट वक्र।
हर क्षय वक्र पर एक प्रमुख बिंदु: जब t S का प्राकृतिक लघुगणक 2 से गुणा के बराबर होता है, तब प्रतिधारण 50% तक पहुँचता है (S × ln2, और ln2 ≈ 0.693)। स्थिरता को दोगुना करें और आधा-भूलने का समय भी दोगुना हो जाता है।
दो क्षय वक्रों को पढ़ना
आपकी याद में दो तथ्य हैं, दोनों R = 100% पर ताज़ा हैं।
तथ्य A की स्थिरता S = 2 दिन है। तथ्य B की स्थिरता S = 20 दिन है।
हर समीक्षा वक्र को सपाट करती है
पुनर्प्राप्ति स्थिरता को बढ़ाती है
यहाँ वह खोज है जो भूलने को एक उपकरण में बदल देती है। हर बार जब आप सफलतापूर्वक पुनर्प्राप्ति (retrieval) करते हैं (यानी किसी संकेत से याद करते हैं, पुनः पढ़ने से नहीं), तो उसकी स्थिरता S ऊपर उछलती है। वह स्मृति जिसे आपने भूलने के किनारे से वापस खींचा है, पहले से अधिक मजबूती से लौटती है।
ज्यामितीय रूप से, एक समीक्षा दो चीज़ें एक साथ करती है: यह R को 100% पर रीसेट करती है, और यह S को बढ़ाती है ताकि अगली क्षय (decay) धीमी हो। इसे समय के साथ प्लॉट करें और आपको एक सॉ-टूथ (sawtooth) मिलता है: रीटेन्शन गिरता है, एक समीक्षा इसे शीर्ष पर वापस खींचती है, फिर यह फिर से गिरता है लेकिन एक नरम ढलान के साथ, फिर एक और समीक्षा, और फिर और भी नरम। दाँत चौड़े होते जाते हैं और समग्र रुझान सपाट होता जाता है।
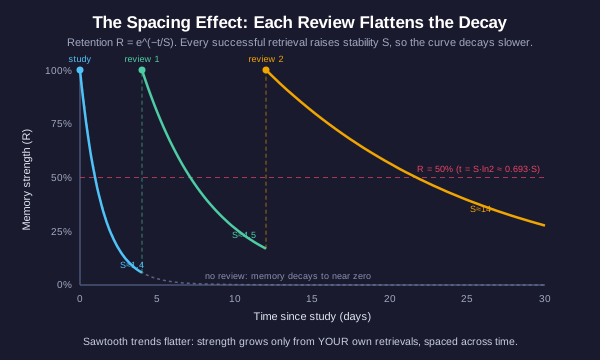
यही कारण है कि स्पेसिंग (अंतराल) क्रैमिंग (अंतिम पल की तैयारी) से बेहतर है। क्रैमिंग S अभी भी छोटी होने के दौरान कई पुनर्प्राप्तियों को एक ही सत्र में ढेर कर देती है, इसलिए वे वक्र को लगभग नहीं हिला पातीं, और अगले हफ्ते तक रीटेन्शन ढह चुका होता है। स्पेसिंग तब तक इंतज़ार करती है जब R आधा गिर चुका हो (पुनर्प्राप्ति मेहनत लगती है), और तब समीक्षा करती है, और वह मेहनती वापसी S को सबसे अधिक बढ़ाती है। कुल समीक्षाएँ समान, लंबी अवधि की रीटेन्शन बहुत अधिक: यह पूरी तरह तय करने का मामला है कि आप वक्र के किनारे उन्हें कब रखते हैं।
आदर्श समीक्षा तब आती है जब आप भूलने वाले हों: 50% के निशान के पास, t ≈ S × ln2 पर। जैसे-जैसे S बढ़ती है, वह क्षण बाद-बाद आता है, इसलिए समीक्षा अंतराल बढ़ते चाहिए: 1 दिन, फिर 3, फिर एक सप्ताह, फिर एक महीना। वक्र आपको बताता है कि कब।
सॉ-टूथ (Sawtooth) क्यों सपाट होता है
आप एक तथ्य तीन बार समीक्षा करते हैं, समीक्षाओं को आरेख के अनुसार अंतराल पर रखते हुए।
समीक्षा के दिन का हल खोजना
जब रिटेंशन 50% पर पहुँचता है?
समीक्षा का सबसे अच्छा समय तब आता है जब याददाश्त (retention) लगभग आधी हो चुकी हो। इसलिए एक व्यावहारिक प्रश्न: यदि स्थिरता (stability) S है, तो किस दिन t पर R = e^(−t/S) का मान 0.50 होता है?
R = 0.5 रखें और हल करें। दोनों पक्षों का प्राकृतिक लॉगरिदम (natural log) लें: ln(0.5) = −t/S। चूंकि ln(0.5) = −ln2, इससे t = S × ln2 प्राप्त होता है, जहाँ ln2 ≈ 0.693 है।
यह रेडियोएक्टिव क्षय (radioactive decay) से आने वाली आधी-आयु (half-life) सूत्र से बिल्कुल मेल खाती है: एक ही ज्यामिति (geometry) एक मंद होती हुई आइसोटोप (isotope) और एक मंद होती हुई याददाश्त दोनों को नियंत्रित करती है। दोनों समय की एक इकाई में एक निश्चित अंश (fixed fraction) खोते हैं, इसलिए दोनों अपनी स्थिरता द्वारा निर्धारित किए गए एक स्थिर अंतराल पर आधा हो जाते हैं।
उदाहरण: यदि किसी तथ्य की S = 5 दिन है, तो यह t = 5 × 0.693 = 3.47 दिन पर 50% याददाश्त तक पहुँचता है। इसे दिन 3 या 4 पर समीक्षा करने के लिए गोल (round) करें।
आधी-आयु वाले दिन की गणना करें
एक फ्लैशकार्ड तथ्य की वर्तमान स्थिरता S = 10 दिन है, और यह R = 100% से शुरू हुआ था।
ह्रासमान रिटर्न और किनारा
दूसरी वक्र रेखा
भूलना सीखने में एकमात्र वक्र रेखा नहीं है। किसी कौशल को अभ्यास समय के विरुद्ध ट्रैक करें और आपको सीखने की वक्र रेखा मिलती है: शुरुआत में तेज़ लाभ, फिर चढ़ाई के दौरान धीमे लाभ, और एक प्लेटो की ओर सपाट होना। मनोवैज्ञानिक इसे अभ्यास की शक्ति नियम कहते हैं: प्रदर्शन दोहरावों की संख्या के लगभग एक शक्ति के रूप में सुधरता है, जो एक वक्र रेखा बनाता है जो मुड़ जाता है और सपाट हो जाता है।
गिरती हुई रिटर्न्स (Diminishing returns) ज्यामितीय हैं। शुरुआत में वक्र (curve) खड़ा होता है, इसलिए एक घंटे की अभ्यास से बड़ा उछाल मिलता है। वक्र के ऊपर की ओर यह सपाट हो जाता है, इसलिए वही एक घंटा छोटा उछाल देता है। आप सुधारने से नहीं रुके हैं; बस जहाँ आप अब खड़े हैं, वहाँ ढलान (slope) पतली हो गई है। दसवां घंटा पहले घंटे से कम जोड़ता है क्योंकि यह उसी वक्र के सपाट हिस्से पर पड़ता है।
इच्छाशक्ति से अभ्यास (Deliberate practice) पूरे वक्र को हिलाता है, न कि केवल उस पर आपका बिंदु। आसान, पहले से ही सीखी गई सामग्री पर मेहनत करना आपको केवल सपाट शीर्ष के साथ-साथ आगे बढ़ाता है: गति है, लेकिन लाभ कम। अपनी क्षमता की सीमा पर (कठिन समस्याएँ, लक्षित कमज़ोरी, तत्काल प्रतिक्रिया) अभ्यास करना कुछ अलग करता है: यह पूरे वक्र को ऊपर उठाता है, प्लेटो (plateau) को स्वयं बढ़ाता है। आप पुराने वक्र के साथ चल रहे नहीं हैं; आप इसे एक ऊँचे वक्र के साथ बदल रहे हैं।
दोनों वक्र आपस में जुड़े हैं। इच्छाशक्ति से अभ्यास सीमा पर परिश्रमपूर्ण पुनर्प्राप्ति (effortful retrieval) है, और परिश्रमपूर्ण पुनर्प्राप्ति वही है जो भूलने के मॉडल में स्थिरता S को बढ़ाती है। सीमा पर काम करना भूलने को सपाट करता है और एक ही समय में सीखने के प्लेटो को ऊपर उठाता है।
ढलान और शिफ्ट
एक पियानिस्ट ने एक साल तक वही आसान स्केल्स (scales) अभ्यास किए और सुधार रुक गया।
स्वचालन (Automation) प्रयास और रीति को समतल करता है
पुनर्प्राप्ति (Retrieval) आपकी है
अब तक का हर परिणाम एक ही चाल पर निर्भर करता है: आपकी अपनी सफल पुनर्प्राप्ति (retrieval)। भूलने के किनारे से वह मेहनती खींच-आना (effortful pull-back) ही है जो स्थिरता S को बढ़ाता है, क्षय वक्र (decay curve) को समतल करता है, और सीखने के वक्र (learning curve) को ऊपर उठाता है।
स्वचालित अध्ययन उपकरणों (automated study tools) का आकर्षण इसलिए है क्योंकि वे प्रयास (EFFORT) को समतल करते हैं। एक उपकरण अध्याय का सारांश दे सकता है, आपके हिचकिचाते ही तुरंत उत्तर दिखा सकता है, या समस्या का हल आपके लिए कर सकता है। काम हल्का लगता है। लेकिन ज्यामिति (geometry) अनासक्त (unsentimental) है: यदि उपकरण पुनर्प्राप्ति करता है, तो S कभी नहीं बढ़ता। आप पुनः पढ़कर R को 100% पर रीसेट करते हैं, फिर उसी तीव्र वक्र (steep curve) आपको शून्य पर वापस गिरा देता है, क्योंकि कोई भी मेहनती पुनर्प्राप्ति (effortful retrieval) कभी नहीं हुई। डंतेदार (sawtooth) समतल होने बंद हो जाता है; यह बस उसी तीव्र दाँत (tooth) को दोहराता है।
यह ही जाल है। एक ऐसा टूल जो प्रयास को शून्य तक कम कर देता है, वह आपके रटने (retention) को भी शून्य तक कम कर देता है, क्योंकि दोनों एक ही क्रिया से निर्भर हैं। यहाँ सुविधा और टिकाऊपन एक-दूसरे के विपरीत दिशा में खींचते हैं।
अच्छी तरह से उपयोग करने पर, वही टूल मदद करते हैं: एक अंतराल-दोहराव शेड्यूलर (spaced-repetition scheduler) जो आपको पुनर्प्राप्ति (retrieve) करने के लिए प्रेरित करता है (और फिर जाँच करता है), बढ़ती S को सवार होता है, उसे चुराता नहीं है। रेखा सरल है: एक ऐसा टूल जो आपको पुनर्प्राप्ति करने पर मजबूर करता है, स्मरण बनाता है; एक ऐसा टूल जो आपके लिए पुनर्प्राप्ति करता है, आपको एक प्रतिलिपि किराए पर देता है जो वाष्प हो जाती है। ज्यामिति कहती है कि शक्ति केवल आपके अपने सफल पुनर्प्राप्ति (retrievals) से, समय के साथ अंतराल पर, बढ़ती है।
स्व-विनाशकारी शॉर्टकट
एक अध्ययन ऐप कार्ड खुलते ही हर उत्तर स्वतः प्रकट कर देता है, ताकि आप पुनर्प्राप्ति (recall) करने के बजाय पढ़ते हैं।
सीखने की ज्यामिति, एक ही चित्र में
आपने क्या सीखा
सीखना और भूलना, दोनों का एक आकार है, और ये आकार ही पाठ हैं:
- भूलने का वक्र R = e^(−t/S) घातांकीय रूप से क्षय होता है। स्थिरता S तीव्रता निर्धारित करती है: बड़ी S, चपटा वक्र। संरक्षण t = S × ln2 पर आधा हो जाता है (ln2 ≈ 0.693)।
- अंतराल प्रभाव (spacing effect) भूलने को एक उपकरण में बदल देता है: हर सफल पुनर्प्राप्ति S को बढ़ाती है, जिससे अगला क्षय चपटा हो जाता है। समय के साथ प्लॉट किया जाए तो यह एक डंठली (sawtooth) जैसा दिखता है जिसके दाँत चौड़े होते जाते हैं, इसलिए समीक्षा अंतराल बढ़ाए जा सकते हैं: 1 दिन, 3 दिन, एक सप्ताह, एक माह।
- अर्ध-आयु गणना समीक्षा का क्षण खोजती है: S = 10 दिनों के लिए, संरक्षण t = 10 × 0.693 = 6.93 दिनों पर 50% पर पहुंचता है। वही गणित रेडियोधर्मी क्षय को भी नियंत्रित करता है।
- सीखने की वक्र रेखा (learning curve) घटते प्रतिफल (diminishing returns) की ओर मुड़ी हुई है क्योंकि आप एक चपटे ढलान पर चढ़ रहे हैं। क्षमता के किनारे पर की गई सजग अभ्यास (deliberate practice) पूरी वक्र रेखा को ऊपर की ओर खिसका देती है, बजाय इसके कि आपको चपटे शीर्ष के साथ-साथ सरकने दें।
- निष्कर्ष: इनमें से हर लाभ आपके अपने प्रयासपूर्ण, अंतरालित पुनर्प्राप्ति (spaced retrieval) से प्रेरित है। एक ऐसा औज़ार जो आपको पुनर्प्राप्त करने के लिए बाध्य करे, वह स्मरण बनाता है; एक ऐसा औज़ार जो आपके लिए पुनर्प्राप्ति कर दे, वह आपके प्रयास और आपके स्मरण को एक साथ शून्य कर देता है।
आकारों को सीखें, फिर अपने प्रयास को वहां लगाएं जहां वक्र रेखा आपको पुरस्कृत करती है: किनारे पर, भूलने से ठीक पहले, पुनर्प्राप्ति खुद करके।