Där tillförlitligheten tar slut
Automatisering har en form
Varje automatiserat system har ett område där det fungerar och ett område där det misslyckas. Rita dessa två områden i ett plan och du får en kompetensgräns: kurvan som skiljer tillförlitligt beteende från fel.
Placera två axlar under den. Den horisontella axeln mäter uppgiftens komplexitet och nyhet: hur långt en uppgift ligger från de vanliga fallen systemet byggdes för. Den vertikala axeln mäter insatsen: hur mycket ett felaktigt resultat kostar.
Nära origo är uppgifterna rutinmässiga och lågriskade. Systemet hanterar dem lätt. Detta är det tillförlitliga området: arbeta fritt inom det.
Långt från originalet är uppgifterna nya och högriskade. Systemet gissar, och dess gissningar är kostsamma. Detta är felområdet: gör detta arbete själv.
Mellan dem löper ett band längs frontiern själv. Här är systemet ofta rätt men inte pålitligt rätt. Detta är verifieringsbandet: låt maskinen utkast, men kontrollera varje utdata innan du litar på den.
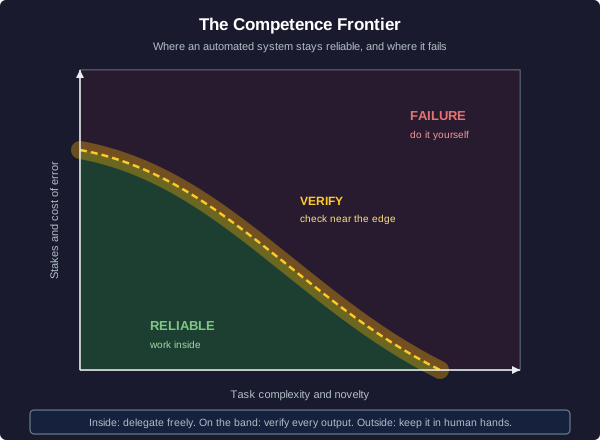
Hela disciplinen att arbeta med automation reduceras till en geometrisk vana: veta i vilket område din uppgift befinner sig, och agera därefter.
Att läsa de tre områdena
En kollega lägger ett nytt verktyg i din arbetsflöde och säger "låt det bara köra på allt".
Två kurvor och ett skärningspunkt
Vad som ska delegeras är en skärningspunkt
Att veta att en uppgift ligger inom gränsen säger dig att maskinen kan utföra den. Det säger dig inte att maskinen bör utföra den. För det, plotta två kurvor.
Placera dina uppgifter längs den horisontella axeln, ordnade från de uppgifter maskinen hanterar sämst till vänster till de den hanterar bäst till höger. Plotta färdighet per uppgift på den vertikala axeln.
Rita människans färdighetskurva och maskinens färdighetskurva över dessa uppgifter. Någonstans korsar de varandra. Det korsningarna är det geometriska svaret på "vad bör jag delegera?"
Till höger om korsningen ligger maskinkurvan ovanför mänsklig kurva: delegera dessa uppgifter. Till vänster ligger mänsklig kurva överst: behåll dessa.
Den subtila delen är relativ fördel, inte absolut. Du kan vara snabbare än maskinen i nästan allt. Det lönar sig ändå att delegera de uppgifter där maskinen är relativt stark, eftersom det frigör dina timmar för de uppgifter där din fördel är störst. Det handlar om relativa lutningar, inte om vem som är bättre isolerat.
Detta är samma geometri som ekonomer använder för handel mellan två producenter: den totala produktionen ökar när varje specialiserar sig där dess relativa fördel ligger, även om en producent är bättre på allt.
Att hitta linjen
Du driver ett litet studio. Du är personligen bättre än dina automatiserade verktyg i varje uppgift du utför. Din vecka är full, så timmar som spenderas på ett ställe kan inte spenderas på ett annat.
Fel skalar med produktionen
Hevstångseffekt multiplicerar i båda riktningarna
Automatisering är en hävarm. Dra den en gång och du får många utdata för en enhet av arbete. Utdata ökar linjärt med antalet objekt du skickar genom systemet: leverera N objekt, få N resultat.
Fångsten är att fel åker på samma hävarm. Om systemet producerar ett felaktigt resultat med sannolikheten p för varje objekt, blir förväntat antal fel över N objekt:
förväntat antal fel = p x N
Detta är bara medelvärdet för en summa av N oberoende försök, där varje försök är felaktigt med sannolikheten p. Dubbla din volym och du dubblar ditt förväntade antal defekter. Antal fel är inte en fast kostnad du betalar en gång; det ökar med din hävarm.
Den ensamma raden omformar hur du verifierar. Vid N = 10 innebär en felrate på 2 % ungefär ett förväntat misstag: lätt att upptäcka med blotta ögat. Vid N = 100 000 innebär samma 2 % 2 000 förväntade misstag som levereras ut i världen. Samma system, samma tillförlitlighet per objekt, helt olika exponering.
Så regeln är: verifiering måste skala med hävarmen. Ju mer hävarmen multiplicerar din produktion, desto mer multiplicerar den också de fel du måste fånga, och din budget för kontroller måste växa med N, inte vara fast.
Att räkna defekterna
En automatiserad pipeline formaterar produktlistningar. För varje listning introducerar den ett fel med sannolikheten p = 0,02 (en felrate på 2 %). Du kör den över N = 4 000 listningar i en enda batch.
Verifiera där produkten är stor
Två dimensioner, en produkt
Förväntat antal fel berättar för dig hur många misstag att förvänta sig. Det berättar inte hur mycket varje enskilt fel skadar. En felaktigt formaterad intern anteckning & en felaktig siffra i en skatteanmälan är inte samma defekt.
Så lägg till en andra dimension. På ena axeln placerar du sannolikheten för fel. På den andra placerar du kostnaden för ett enskilt fel. Varje uppgift är en punkt på det planet, & den kvantitet som bör styra ditt verifieringsarbete är produkten:
verifieringsinsatsen bör skala med (sannolikheten för fel) x (kostnaden för fel)
Läst som en yta, stiger produkten mot hörnet där båda är höga & sjunker mot hörnet där båda är låga. Ditt verifieringsfokus bör följa höjden på den ytan.
Hörnen är lätta. Frekventa & katastrofala: verifiera hårt. Sällsynta & triviala: kontrollera knappt. De instruktiva fallen är de avdiagonala hörnen. Ett sällsynt men katastrofalt fel kräver fortfarande omfattande verifiering, eftersom den stora kostnaden bär produkten även när sannolikheten är liten. Ett frekvent men triviellt fel kan i princip inte behöva verifieras alls, eftersom den lilla kostnaden håller produkten låg oavsett hur ofta det inträffar.
Det är därför "hur pålitlig är det?" är felaktiga ensamma frågan. Pålitlighet är en axel. Kostnad är den andra. Du verifierar längs produkten av de två.
Vilken får granskningen
Två automatiserade jobb körs i ditt företag.
Jobb A skissar rutinmässiga interna påminnelser. Det gör fel ganska ofta, men ett felaktigt påminnelse kostar nästan ingenting: någon ler och rättar det.
Jobb B lämnar in regulatoriska handlingar. Det gör sällan fel, men ett enda felaktigt inlämning är katastrofalt: böter, juridisk risk, förlorad förtroende.
Proffsens geometri
Var detta landar
Automatiserade system ligger nu mellan människor och en växande del av handel och kunskapsarbete. De utkastar, sorterar, prissätter, rutterar och sammanfattar. Den professionell som arbetar bra tillsammans med dem är inte den som litar mest eller minst på dem. Det är den som förstår geometrin.
Tre former bär på det omdömet:
- Gränsen: veta var tillförlitligheten slutar. Delegera inom den, verifiera längs den och håll det utomför inom mänskliga händer.
- Övergången: veta vad som ska lämnas över. Delegera den maskinmässigt fördelade sidan av övergången, och kom ihåg att ändlig tid gör relativ fördel till den avgörande faktorn.
- Hevstångseffekt & felytan: förväntade fel = p x N ökar med skalan, så verifiering måste skala med hevstångseffekten, viktad med sannolikhet x kostnad, så att din uppmärksamhet hamnar där misstag är både troliga & dyra.
Inget av detta handlar om maskinens inre. Det handlar om geometri: regioner, gränser, skärningspunkter & produkter. Få geometrin rätt & verktyget förstärker dig. Få den felaktig & det förstärker dina misstag i samma takt.
Automatiseringens geometri: Sammanfattning
Vad du har lärt dig
Att bestämma vad som ska automatiseras är tillämpad geometri:
- Kompetensgränsen: kurvan mellan det tillförlitliga området och felområdet. Delegera inuti, verifiera längs bandet och behåll det utomför inom mänskliga händer.
- Jämförd fördel – korsningspunkten: ordna dina uppgifter, plotta mänsklig skicklighet mot maskinell skicklighet och överlämna den maskinfördelade sidan av korsningen. Begränsad tid gör att relativ fördel avgör, även om du är absolut bättre.
- Hevstångseffekt och skalning: uttaget ökar linjärt med volymen, och så gör felen också. Förväntade fel = p x N. En frekvens på 2 % över 4 000 objekt ger 80 förväntade defekter, så verifieringen måste skala med hevstångseffekten.
- Felkostnadens yta: verifiera i proportion till (sannolikheten för fel) x (kostnaden för felet). Ett sällsynt men katastrofalt fel kan väga tyngre än ett frekvent men bagatellmässigt.
Maskinen multiplicerar det du riktar den mot. Läs geometrin rätt och den multiplicerar din räckvidd. Läs den felaktigt och den multiplicerar dina misstag precis lika snabbt.