Waar betrouwbaarheid ophoudt
Automatisering heeft een vorm
Elk geautomatiseerd systeem heeft een gebied waar het werkt & een gebied waar het faalt. Teken die twee gebieden op een vlak & je krijgt een competentiegrens: de curve die betrouwbaar gedrag scheidt van falen.
Plaats twee assen eronder. De horizontale as meet taakcomplexiteit & vernieuwing: hoe ver een taak zich bevindt van de gewone gevallen waarvoor het systeem is ontworpen. De verticale as meet belang: hoeveel een foutieve output kost.
In de buurt van de oorsprong zijn taken routine en van weinig belang. Het systeem verwerkt ze moeiteloos. Dit is het betrouwbare gebied: werk hierin vrij.
Ver weg van de oorsprong zijn taken nieuw en van hoge waarde. Het systeem gokt, en zijn gokken is kostbaar. Dit is het falisgebied: doe dit werk zelf.
Tussen hen in ligt een band langs de frontier zelf. Hier is het systeem vaak goed, maar niet betrouwbaar goed. Dit is de verificatieband: laat de machine een concept maken, maar controleer elke output voordat je erop vertrouwt.
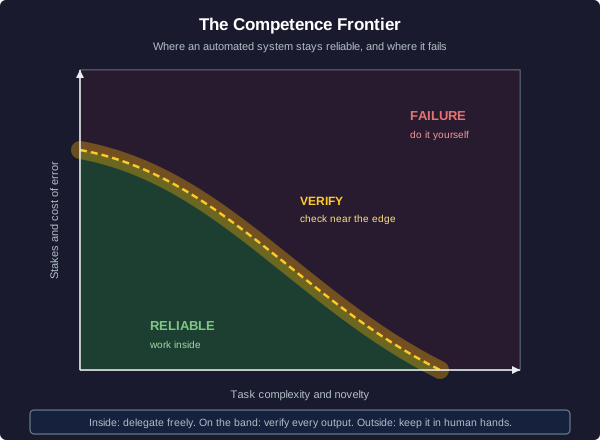
De hele discipline van werken met automatisatie reduceert tot één geometrische gewoonte: weet in welk gebied je taak zich bevindt, en handel dienovereenkomstig.
De drie gebieden lezen
Een collega voegt een nieuw hulpmiddel toe aan je workflow en zegt: "laat het gewoon overal draaien."
Twee curven en een kruispunt
Wat je moet delegeren is een kruispunt
Weten dat een taak binnen de grens valt, vertelt je dat de machine het kan. Het vertelt je niet dat de machine het moet. Voor dat doel plot je twee curven.
Rangschik je taken langs de horizontale as, gesorteerd van de taken die de machine het slechtst uitvoert (links) naar de taken die het het beste uitvoert (rechts). Op de verticale as plot je de vaardigheid per taak.
Teken de mensenlijke vaardigheidscurve en de machinesvaardigheidscurve over deze taken. Ergens kruisen ze elkaar. Dat kruispunt is het geometrische antwoord op de vraag "wat moet ik delegeren?"
Rechts van het kruispunt ligt de machinecurve boven de menselijke curve: geef die taken door. Links ligt de menselijke curve bovenop: behoud die.
Het subtiele aspect is relatief voordeel, niet absoluut. Je kunt sneller zijn dan de machine bij vrijwel alles. Het loont nog steeds om de taken te delegeren waar de machine relatief sterk is, omdat dat je uren vrijmaakt voor de taken waar je voordeel het grootst is. Het kruispunt gaat om relatieve hellingen, niet om wie er geïsoleerd beter is.
Dit is dezelfde geometrie die economen gebruiken voor handel tussen twee producenten: de totale output stijgt wanneer elke partij zich specialiseert waar zijn relatieve voordeel ligt, zelfs als één producent beter is in alles.
De lijn vinden
Je runt een kleine studio. Je bent persoonlijk beter dan je geautomatiseerde tools in elke taak die je uitvoert. Je week zit vol, dus uren die ergens worden besteed, kunnen niet ergens anders worden besteed.
Fouten Schalen Met Output
Hebel Vermenigvuldigt in Beide Richtingen
Automatisering is een hefboom. Trek er één keer aan en je krijgt veel outputs voor één eenheid aan inspanning. De output groeit lineair met het aantal items dat je verwerkt: lever N items, krijg N resultaten.
Het probleem is dat fouten dezelfde hefboom gebruiken. Als het systeem per item met een waarschijnlijkheid p een onjuist resultaat produceert, dan is het verwachte aantal fouten over N items:
verwachte fouten = p x N
Dit is niets anders dan het gemiddelde van een som van N onafhankelijke proeven, waarbij elke proef met waarschijnlijkheid p fout is. Verdubbel je volume en je verdubbelt je verwachte defecten. Het aantal fouten is geen vaste kost die je één keer betaalt; het groeit met je hefboom.
Die ene regel verandert hoe je verifieert. Bij N = 10 betekent een foutpercentage van 2% ongeveer één verwachte fout: makkelijk te zien met het blote oog. Bij N = 100.000 betekent hetzelfde 2% dat er 2.000 verwachte fouten de wereld in gaan. Zelfde systeem, zelfde betrouwbaarheid per item, enorm verschillende blootstelling.
Dus de regel: verificatie moet schalen met de hefboom. Hoe meer de hefboom je output vermenigvuldigt, hoe meer hij de fouten vermenigvuldigt die je moet vangen, en je controlebudget moet groeien met N, in plaats van vast te blijven staan.
Het tellen van de defecten
Een geautomatiseerde pipeline formateert productaanbiedingen. Per aanbieding introduceert deze een fout met een waarschijnlijkheid p = 0,02 (een foutpercentage van 2%). Je voert dit uit op N = 4.000 aanbiedingen in één batch.
Verifieer waar het product groot is
Twee dimensies, één product
Het verwachte aantal fouten vertelt je hoeveel fouten je kunt verwachten. Het vertelt je niet hoe zwaar elke fout weegt. Een verkeerd opgemaakte interne notitie & een verkeerd cijfer in een belastingaangifte zijn niet dezelfde fout.
Voeg daarom een tweede dimensie toe. Op de ene as staat de kans op fout. Op de andere as staat de kosten van één fout. Elke taak is een punt op dat vlak, & de grootheid die je inspanning voor verificatie moet sturen, is het product:
verificatie-inspanning moet schalen met (kans op fout) x (kosten van fout)
Gelezen als een oppervlak, stijgt het product richting de hoek waar beide hoog zijn & daalt richting de hoek waar beide laag zijn. Je aandacht voor verificatie moet de hoogte van dat oppervlak volgen.
De hoeken zijn duidelijk. Veelvoorkomend & catastrofaal: streng verifiëren. Zeldzaam & triviaal: nauwelijks controleren. De instructieve gevallen zijn de hoeken buiten de diagonaal. Een zeldzame maar catastrofale fout vereist nog steeds zware verificatie, omdat de hoge kosten het product hoog houden, zelfs wanneer de kans klein is. Een veelvoorkomende maar triviale fout verdient misschien nauwelijks enige verificatie, omdat de lage kosten het product laag houden, ongeacht hoe vaak het gebeurt.
Dit is waarom "hoe betrouwbaar is het?" de verkeerde enkele vraag is. Betrouwbaarheid is de ene as. Kosten zijn de andere. Je verifieert langs het product van beide.
Welke krijgt de scherpste aandacht
Er lopen twee geautomatiseerde taken in je winkel.
Taak A maakt concepten voor routine-herinneringen voor intern gebruik. Deze taak maakt vrij vaak fouten, maar een verkeerde herinnering kost bijna niets: iemand lacht erom en corrigeert het.
Taak B dient regelgevende documenten in. Deze taak maakt zelden fouten, maar één verkeerde indiening is rampzalig: boetes, juridische blootstelling, verlies van vertrouwen.
De geometrie van de professional
Waar dit neerkomt
Gautomatiseerde systemen zitten nu tussen mensen en een groeiend aandeel van de handel en kenniswerk. Ze maken concepten, sorteren, bepalen prijzen, sturen door en vatten samen. De professional die goed samenwerkt met deze systemen, is niet degene die ze het meest of het minst vertrouwt. Het is degene die de geometrie leest.
Drie vormen dragen dat oordeel:
- De grens: weet waar de betrouwbaarheid ophoudt. Delegeer binnen die grens, verifieer langs die grens en houd wat daarbuiten valt in menselijke handen.
- Het kruispunt: weet wat je over moet dragen. Delegeer het deel van het kruispunt waar de machine een voordeel heeft, en onthoud dat eindige tijd het relatieve voordeel tot de bepalende factor maakt.
- Hevechtaal & het foutoppervlak: verwachte fouten = p x N groeien met de schaal, dus verificatie moet mee schalen met de hevechtaal, gewogen naar waarschijnlijkheid x kosten, zodat je aandacht uitgaat naar waar fouten zowel waarschijnlijk als kostbaar zijn.
Geen van dit gaat over de interne werking van de machine. Het gaat om geometrie: gebieden, grenzen, snijpunten & producten. Krijg de geometrie goed & het hulpmiddel versterkt je. Krijg het fout & het versterkt je fouten met dezelfde snelheid.
De geometrie van automatisering: Samenvatting
Wat je hebt geleerd
Bepalen wat je automatiseert, is toegepaste geometrie:
- De competentiefrontier: de curve tussen het betrouwbare gebied en het falingsgebied. Delegeer binnenin, verifieer langs de band en houd het gebied daarbuiten in menselijke handen.
- Het kruispunt van relatieve voorsprong: rangschik je taken, plot menselijke vaardigheid tegenover machinevaardigheid en geef de kant van het kruispunt met machinievoorsprong door. De eindige tijd zorgt ervoor dat de relatieve voorsprong beslist, zelfs als je absoluut beter bent.
- Hebel en schaal: de output groeit lineair met het volume, en de fouten doen dat ook. Verwachte fouten = p x N. Een tarief van 2% over 4.000 items betekent 80 verwachte defecten, dus verificatie moet schalen met de hebel.
- Het oppervlak van de foutkosten: verifieer in verhouding tot (kans op fout) x (kosten van de fout). Een zeldzame maar catastrofale fout kan belangrijker zijn dan een veelvoorkomende maar triviale fout.
De machine vermenigvuldigt wat je erop richt. Lees de geometrie goed en het vermenigvuldigt je bereik. Lees het verkeerd en het vermenigvuldigt je fouten net zo snel.