모델은 얼마나 놀라야 할까요?
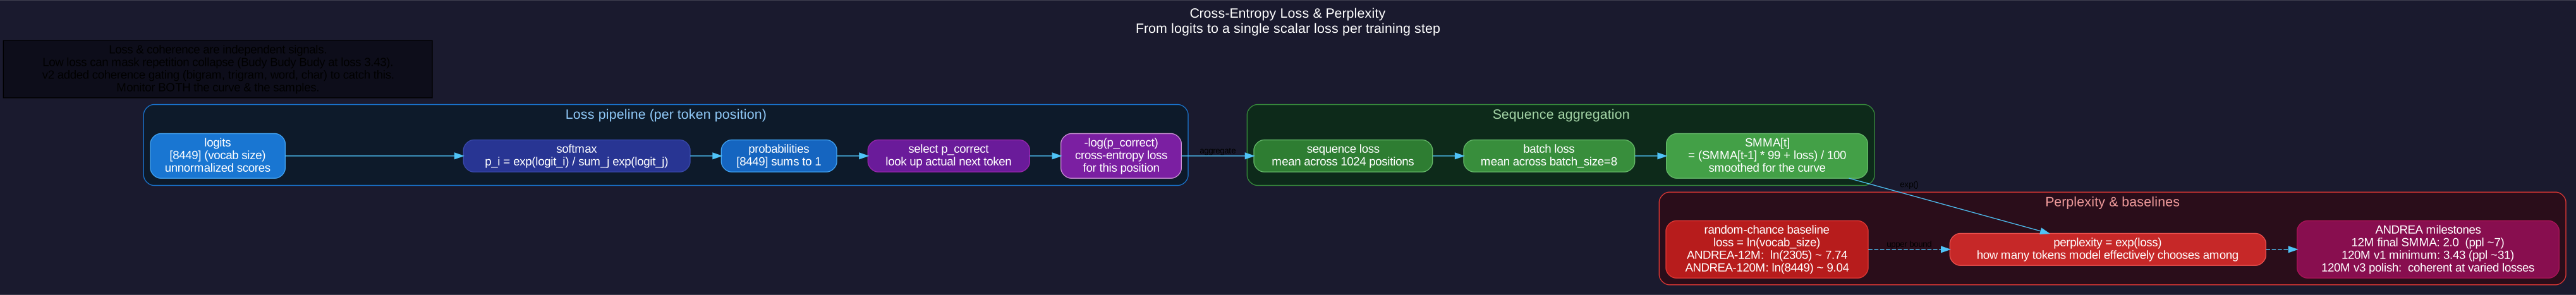
로짓에서 확률로
12개의 트랜스포머 블록을 거친 후, ANDREA-120M은 각 토큰 위치마다 vocab_size개의 숫자 벡터를 생성합니다: 로짓(logits)입니다. ANDREA-120M의 경우, vocab_size = 8449이므로 모든 위치에서 8449개의 로짓이 출력됩니다. 로짓은 정규화되지 않은 점수입니다; 일부는 양수, 일부는 음수이며, 합이 1이 되어야 한다는 제약이 없습니다.
Softmax는 로짓을 확률 분포로 변환합니다:
p_i = exp(logit_i) / sum_j exp(logit_j)Softmax 적용 후, 모든 8,449개의 숫자는 0과 1 사이에 위치하며 합이 1이 됩니다. 모델은 모든 가능한 다음 토큰에 확률을 부여합니다.
교차 엔트로피 손실
학습에는 손실 함수가 필요합니다. 이는 주어진 정답에 대해 모델의 예측이 얼마나 틀렸는지를 측정하는 수치입니다. 교차 엔트로피는 언어 모델링에 적합합니다:
loss_t = -log(p_correct_token_t)모델이 실제 다음 토큰(학습 데이터에 있는 토큰)에 대해 예측한 확률을 가져옵니다. 해당 확률의 음의 로그(negative log)를 취합니다. 이것이 한 위치(position)에 대한 손실(loss)입니다.
왜 음의 로그(Negative Log)인가
-log(p)가 자연스러운 손실 함수가 되는 세 가지 성질이 있습니다:
- -log(1) = 0: 모델이 올바른 토큰을 100% 확신으로 예측할 때, 손실은 0이 됩니다.
- -log(0) = ∞: 모델이 올바른 토큰에 0의 확률을 할당할 때, 손실은 무한대가 됩니다. (실제로는 softmax가 정확히 0을 출력하지 않으므로, 손실은 유한하지만 매우 큰 값을 유지합니다.)
- 단조성(Monotonic): 올바른 토큰에 대한 예측 확률이 증가함에 따라, 손실은 매끄럽게 감소합니다.
정답에 대한 확신이 높을수록 손실이 낮아집니다. 학습 목표는 단순합니다: 실제 다음 토큰에 대한 예측 확률을 최대화하는 것입니다.
시퀀스별 손실
ANDREA는 길이 1024(컨텍스트 윈도우)의 시퀀스로 학습합니다. 각 시퀀스는 1024개의 다음 토큰 예측을 생성합니다. 시퀀스 손실은 모든 위치의 평균을 취합니다:
sequence_loss = mean(-log(p_correct_t)) for t in 0..1023그 후 시퀀스 손실은 배치 전체에 걸쳐 평균화됩니다(ANDREA-120M은 batch_size = 8을 사용함). 학습 단계마다 하나의 스칼라 값이 생성됩니다. 이 값이 손실 곡선(loss curve)에 플롯되는 것입니다.
하나의 위치에서 손실 계산하기
퍼플렉시티 = exp(loss)
더 직관적인 척도
2.0이나 3.43과 같은 손실 값은 모델이 무엇을 할 수 있는지를 즉시 전달하지 않습니다. 퍼플렉시티는 손실을 더 직관적인 척도로 변환합니다:
perplexity = exp(loss)Perplexity(퍼플렉시티)는 명확한 질문에 답합니다: 모델은 실제로 얼마나 많은 동일한 확률의 토큰 중에서 선택하는가? 퍼플렉시티가 7이라는 것은 모델이 각 위치에서 7개의 타당한 다음 토큰 중에서 선택하는 것과 같은 방식으로 행동한다는 것을 의미합니다. 퍼플렉시티가 1이면 완벽한 예측을 의미합니다.
일반적인 손실-퍼플렉시티 쌍
| 손실 | 퍼플렉시티 | 느낌 |
|---|---|---|
| 0.0 | 1.0 | 완벽한 예측 |
| 1.0 | 2.7 | 약 3개의 합리적 토큰 중 선택 |
| 2.0 | 7.4 | ANDREA-12M 최종 SMMA 영역 |
| 3.0 | 20.1 | 합리적인 텍스트이지만 불확실함 |
| 3.43 | 30.9 | ANDREA-120M v1 최소값 (마무리 작업 전) |
| 5.0 | 148 | 초기 학습 단계, 어휘 분포 학습 중 |
| 9.04 | 8449 | ANDREA-120M 어휘에 대한 무작위 확률 기준선 |
퍼플렉시티(Perplexity)는 손실 값을 맥락화합니다: 손실 값 2.0은 모델이 8449개 중이 아닌 약 7개의 토큰에서 효과적으로 선택한다는 것을 의미합니다.
무작위 추측 기준선
아무것도 모르고 균일하게 추측하는 모델은 모든 토큰에 1/V의 확률을 할당합니다. 여기서 V = vocab_size입니다:
p_uniform = 1 / V
loss      = -log(1/V) = log(V)
V = 8449인 ANDREA-120M의 경우:
loss_uniform = ln(8449) ≈ 9.04V = 2305인 ANDREA-12M의 경우:
loss_uniform = ln(2305) ≈ 7.74이 기준선보다 높은 손실 값은 모델이 무작위 추측보다 나쁜 성능을 보인다는 것을 의미합니다. 이 기준선보다 낮은 손실 값은 모델이 무언가를 학습했다는 것을 의미하며, 이는 균등 분포보다 더 작은 토큰 부분집중도에 확률 질량을 집중하고 있음을 나타냅니다.
손실 값 읽기
스텝 레벨 노이즈 스무딩
원시 손실은 노이즈가 큽니다
스텝별 손실은 변동이 큽니다. ANDREA의 밴딧은 7~42스텝마다 다른 소스를 선택합니다; 일부 소스(사전 정의)는 쉬운 손실을 생성하고, 다른 소스(구텐베르크 단락)는 더 어려운 손실을 생성합니다. 원시 스텝 손실을 스텝 번호에 대해 플롯하면 혼란스러운 산포도가 생성됩니다.
평활화 수정 이동 평균(SMMA)은 노이즈를 감쇠시키고 추세를 드러냅니다. ANDREA의 학습 프록시는 SMMA를 다음과 같이 계산합니다:
SMMA[0]  = loss[0]
SMMA[t]  = (SMMA[t-1] * (N-1) + loss[t]) / N
N = 100일 때(ANDREA의 기본 평활화 윈도우), 각 새로운 SMMA 값은 이전 SMMA의 99%와 새로운 스텝 손실의 1%를 혼합합니다. 갑작스러운 스파이크는 흡수되고, 지속되는 변화는 점진적으로 나타납니다.
왜 단순 평균을 쓰지 않는가?
최근 100단계에 대한 단순 이동 평균은 100개의 손실 값을 저장해야 합니다. SMMA는 하나의 값(누적 평균)과 하나의 상수(윈도우 크기)만 저장합니다. 메모리 비용이 적고, 계산이 매우 간단하며, 곡선을 읽기에 충분히 매끄럽습니다.
다양한 스무딩 가중치는 서로 다른 질문에 답합니다:
- N = 10: 단기 변화를 추적합니다; 위상 전이(phase transition) 동안 유용합니다
- N = 100: ANDREA의 기본값; 중기 진전을 추적합니다
- N = 1000: 장기 추세만 표시; 학습 종료 시점에 유용함
ANDREA가 추적하는 내용
매 100단계마다 학습 프록시(proxy)가 현재 SMMA, 원시 손실(raw loss), 단계 번호 및 소스별 세부 내역을 loss.json 파일에 기록합니다. training.ai.unturf.com/dashboard에 있는 대시보드는 이 파일을 10초마다 폴링(polling)하여 조회합니다. 외부 사용자는 실시간 진행 상황을 확인할 수 있으며, 대시보드는 읽기 전용입니다.
ANDREA-12M의 실제 곡선
SMMA 2.0에 도달한 레시피
| 단계 | 평균 손실 | 비고 |
|---|---|---|
| 0--2.5K | 4.50 | 초기 무작위 초기화, 학습 초기 단계 |
| 2.5K--5K | 3.88 | 구조 형성 단계에서 급격한 감소 |
| 5K--10K | 3.30 | 일관성 경계 접근 중 |
| 10K--20K | 2.80 | 밴딧이 최적 혼합을 탐색하는 중 |
| 20K--25K | 2.40 | 평탄화 --- 데이터 부족 |
| 25K--30K | 2.50 | Hermes 데이터 도입 + 학습률 재시작 |
| 30K--35K | 2.35 | Hermes 통합, 새로운 최저치 달성 |
| 35K--40K | 2.10 | 4-arm 집중, 급격한 하강 |
| 40K--43.6K | 2.00 | 지식 영역, SMMA가 2.0 미만 |
세 가지 단계가 눈에 띕니다:
1. 초기 급격한 하강 (0-10K). 모델이 어휘 분포 & 기본 턴 구조를 학습하면서 손실이 4.50에서 3.30으로 떨어집니다. 무작위 추측 기준선 ln(2305) ≈ 7.74는 이 곡선보다 훨씬 위에 위치합니다; 임베딩이 안정되면 모델은 확률 질량을 빠르게 집중시킵니다.
2. 평탄화 (20K-25K). 손실이 2.40에서 정체됩니다. 밴딧은 현재 소스 믹스에서 더 이상 여유 공간이 없었습니다. 25K 단계에서 Hermes 데이터가 추가되고, 학습률(LR) 워밍 리스타트가 이루어지면서 평탄화가 깨졌습니다.
3. 최종 하강 구간 (35K~43.6K). 커리큘럼이 16개 소스에서 4개(hermes3-general + dictionary + gutenberg + chat)로 축소되었습니다. 전체 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔 팔팔
ANDREA-120M v1: A Cautionary Curve
Same vocabulary calculation: ln(8449) ≈ 9.04. ANDREA-120M v1 reached SMMA 3.43 at step 110K (its minimum), then diverged:
| Steps | EMA Loss | Trend |
|---|---|---|
| 26K--40K | 4.29 | 수렴 중 |
| 70K--85K | 3.60 | 최적 영역 |
| 85K--110K | 3.43 | 최소값 |
| 110K--125K | 3.54 | 발산 중 |
| 140K--155K | 4.05 | 발산 중 |
| 155K--165K | 4.54 | 붕괴 |
전체적으로 수치적으로 합리적인 손실 값(3.43은 무작위 기준선인 9.04보다 훨씬 낮음). 그러나 샘플은 반복 붕괴 상태였습니다: Budy Budy Budy Budy. 손실 값은 오도하는 이야기를 들려주었고, 샘플 감사는 그렇지 않았습니다.
v2의 일관성 게이트 기반 조기 종료(활동 78)는 병렬 신호를 추가했습니다: 바이그램 다양성, 트리그램 다양성, 영어 단어 존재 여부, 문자 다양성. 이 네 가지 점수가 5개 연속 샘플 동안 30 미만으로 유지되면 학습이 자동으로 중단됩니다. 이 신호는 v1에서 132K 스텝 시점에 문제를 포착하여 3.8일치의 컴퓨트 비용을 절약했을 것입니다.
각 단계가 알려주는 것
120M v1 레슨
두 개의 독립적인 신호
ANDREA-120M v1은 110K 스텝에서 SMMA 3.43를 달성했습니다. 수치적으로: 무작위 확률보다 273배 더 좋습니다(퍼플렉시티 31 대 어휘 크기 8449). 곡선상으로는 훌륭해 보입니다.
110K 스텝 시 샘플::
''''' ''''' '' ''' '' ''' '''?' ''' ' '' '' '손실(Loss)과 일관성(Coherence)은 독립적인 신호입니다. 낮은 손실은 모델이 확률 질량을 효과적으로 집중시킨다는 것을 의미합니다. 일관성은 모델이 인간이 읽을 수 있는 텍스트를 생성한다는 것을 의미합니다. 전자는 후자를 함축하지 않습니다.
왜 이러한 격차가 존재하는가
모델은 다음 방법으로 손실을 낮출 수 있습니다:
1. 실제 언어 패턴 학습 (긍정적): 주어-동사 일치, 일반적인 구, 사실적 연관성.
2. 구조적 산물의 암기 (나쁨): 고빈도 반복 패턴, 데이터셋 특유의 이상 현상, 퇴화적 끌개(degenerate attractors).
둘 다 손실을 줄입니다. 첫 번째는 인간이 좋아하는 샘플을 생성합니다. 두 번째는 Budy Budy Budy Budy를 생성합니다. 학습 목적 함수만으로는 이 둘을 구별할 수 없습니다.
ANDREA-120M v3 다듬기: 손실과 일관성이 만나는 곳
v3 다듬기(112K 스텝 이후) 후, ANDREA-120M은 다음을 생성합니다:
112,584 스텝, 손실 0.30, ppl 1::
> [절멸 프롬프트]
< 검은 거미 원숭이는 살아 있고, 캐롤라이나 앵무새는 절멸했습니다.
두 사실 모두 정확합니다. 캐롤라이나 앵무새는 1939년에 절멸로 선언되었고, 검은 거미 원숭이는 현존합니다. 낮은 손실(0.30) AND 일관된 사실 회상.
112,500번째 스텝, 손실 1.94, ppl 7::
> Python 프로젝트에서 오래된 패키지를 어떻게 찾나요?
< pip list --outdated 명령을 사용하여 pip 패키지 목록을 확인합니다...
손실이 더 높음(1.94 → ppl 7)이지만, 올바른 도구가 학습 데이터에서 드러납니다. 학습 진행률 56% 시점에서 표현의 유창성은 아직 발전 중입니다.
두 가지 신호의 규율
현대 학습 파이프라인은 다음 두 가지를 모두 모니터링합니다:
- 손실 곡선(Loss curve). 모델이 정량적으로 무언가를 학습하고 있는지 알려줍니다.
- 샘플 감사(Sample audit). 모델이 학습한 내용이 유용한지 알려줍니다.
v2에서는 일관성 게이트 기반의 조기 종료(coherence-gated early stopping)가 추가되었습니다(활동 78). v3의 다듬기는 손실 값이 아닌 샘플 감사를 통해 트리거된 커리큘럼 교란(curriculum perturbation)이었습니다. 손실만으로는 필요 조건은 충족하지만 충분 조건은 결코 아닙니다.