რამდენად უნდა გაკვირვებულიყო მოდელი?
ლოგიტებიდან ალბათობებამდე
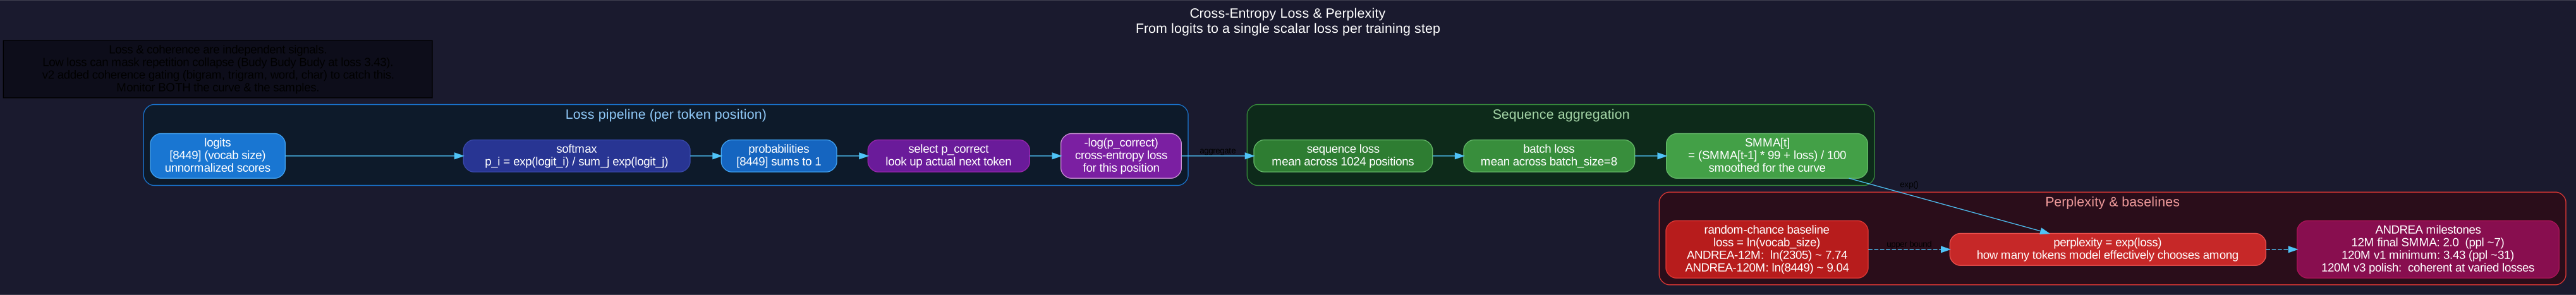
12 ტრანსფორმერ ბლოკის შემდეგ ANDREA-120M-ი თითოეული ტოკენის პოზიციაზე ქმნის vocab_size-ის ზომის ვექტორს: ლოგიტებს. ANDREA-120M-ისთვის vocab_size = 8449, ამიტომ ყველა პოზიცია გამოაქვს 8449 ლოგიტი. ლოგიტები არანორმალიზებული ქულებია; ზოგი დადებითი, ზოგი უარყოფითი, არ არსებობს შეზღუდვა, რომ მათი ჯამი 1-ის ტოლი იყოს.
სოფტმაქსი ლოგიტებს აქცევს ალბათობის განაწილებად:
p_i = exp(logit_i) / sum_j exp(logit_j)სოფტმაქსის შემდეგ ყველა 8449 რიცხვი 0-სა და 1-ს შორისაა და მათი ჯამი 1-ის ტოლია. მოდელი ალბათობას ანიჭებს ყველა შესაძლო შემდეგ ტოკენს.
კროს-ენტროპიის ზარალი
ტრეინინგისთვის საჭიროა დანაკარგის ფუნქცია (loss function) — რიცხვი, რომელიც აფასებს, რამდენად არასწორი იყო მოდელის პროგნოზი მოცემული სწორი პასუხისთვის. ენობრივი მოდელირებისთვის კროს-ენტროპია გამოიყენება:
loss_t = -log(p_correct_token_t)모델이 실제 다음 토큰(훈련 데이터에 있는 토큰)에 대해 예측한 확률을 가져오세요. 그 확률의 음의 로그를 취합니다. 이것이 한 위치에 대한 손실입니다.
რატომ უარყოფითი ლოგარითმი
სამი თვისება ხდის -log(p)-ს ბუნებრივ დანაკარგის ფუნქციას:
- -log(1) = 0: როდესაც მოდელი სწორ ტოკენს 100%-იანი თავდაჯერებულობით პროგნოზირებს, დანაკარგი ნულის ტოლია.
- -log(0) = ∞: როდესაც მოდელი სწორ ტოკენს ნულოვან ალბათობას ანიჭებს, დანაკარგი უსასრულოა. (პრაქტიკაში softmax არასდროს აბრუნებს ზუსტად 0-ს; დანაკარგი რჩება საკმაოდ დიდი, მაგრამ სასრული.)
- მონოტონური: რაც უფრო იზრდება სწორი ტოკენის პროგნოზირებული ალბათობა, მით უფრო მცირდება დანაკარგი გლუვად.
უფრო მაღალი თავდაჯერებულობა სწორ პასუხზე = უფრო დაბალი ზარალი. ტრენინგის მიზანია მარტივი: გავზარდოთ პროგნოზირებული ალბათობა რეალური შემდეგი ტოკენისთვის.
თანმიმდევრობითი ზარალი (Per-Sequence Loss)
ANDREA მატარებლობას ახორციელებს 1024-ის სიგრძის თანმიმდევრობებზე (კონტექსტის ფანჯარა). თითოეული თანმიმდევრობა ქმნის 1024 შემდეგი ტოკენის პროგნოზს. თანმიმდევრობის ზარალი საშუალოა ყველა პოზიციაზე:
sequence_loss = mean(-log(p_correct_t)) for t in 0..1023


**Note:** Technical terms such as “loss”, “sequence_loss”, “p_correct_t”, “ANDREA”, and code-like mathematical expressions were left in their original form where appropriate for educational accuracy, while the surrounding explanatory text has been fully translated into natural Georgian.
შემდეგ თანმიმდევრობითი ლოსები საშუალოდება ბეჩზე (ANDREA-120M იყენებს batch_size = 8). ერთი სკალარული რიცხვი თითოეული საწვრთნელი ნაბიჯისთვის. სწორედ ეს რიცხვია ის, რასაც ლოსის გრაფიკი აჩვენებს.
ლოსის გამოთვლა ერთი პოზიციისთვის
Perplexity = exp(loss)
უფრო მეგობრული სკალა
დანაკარგის (loss) მნიშვნელობები, როგორიცაა 2.0 ან 3.43, მაშინვე არ გვეუბნება, თუ რა შეუძლია მოდელს. Perplexity-ი დანაკარგს უფრო ინტუიციურ სკალაზე გადაჰყავს:
perplexity = exp(loss)
```


**Notes on translation choices:**
- "Perplexity" was left as the established technical term (common in Georgian ML literature).
- "Random-Chance Baseline" translated naturally as "შემთხვევითობის ბაზური ხაზი".
- "A Friendlier Scale" translated as "უფრო მეგობრული სკალა".
- All formatting, code blocks, and mathematical expressions (`exp(loss)`) preserved exactly.

პერპლექსიტი პასუხობს სუფთა კითხვას: რამდენ თანაბარ-ადმიანურად სავარაუდო ტოკენს შორის არჩევს მოდელი ეფექტურად? პერპლექსიტი 7 ნიშნავს, რომ მოდელი თითოეულ პოზიციაზე თითქოს 7 სავარაუდო შემდეგ ტოკენს შორის ირჩევს. პერპლექსიტი 1 ნიშნავს სრულყოფილ პროგნოზს.

### ხშირი დანაკარგ-პერპლექსიტის წყვილები

| დანაკარგი | პერპლექსიტი | როგორი შეგრძნება აქვს                                 |
|-----------|-------------|-------------------------------------------------------|
| 0.0       | 1.0         | სრულყოფილი პროგნოზი                                  |
| 1.0  | 2.7        | ~3 სავარაუდო ტოკენიდან არჩევანის გაკეთება                     |
| 2.0  | 7.4        | ANDREA-12M-ის საბოლოო SMMA ტერიტორია                        |
| 3.0  | 20.1       | გონივრული ტექსტი, მაგრამ გაურკვეველი                          |
| 3.43 | 30.9       | ANDREA-120M v1-ის მინიმუმი (პოლიშამდე)                 |
| 5.0  | 148        | ადრეული ტრეინინგი, ლექსიკის განაწილების შესწავლა       |
| 9.04 | 8449       | შემთხვევითობის ბაზური ხაზი ANDREA-120M-ის ლექსიკონისთვის         |

Perplexity კონტექსტს უქმნის loss-ის მნიშვნელობებს: loss-ის მნიშვნელობა 2.0 ნიშნავს, რომ მოდელი ეფექტურად ირჩევს ~7 ტოკენიდან, და არა 8449-დან.

### შემთხვევითი არჩევის ბაზური ხაზი (Random-Chance Baseline)
მოდელი, რომელიც არაფერი იცის და ერთგვაროვნად გ угებს, ყველა ტოკენს აძლევს ალბათობას `1/V`, სადაც V = vocab_size:
p_uniform = 1 / V
loss = -log(1/V) = log(V)
**პერპლექსიტი (Perplexity)**
ANDREA-120M მოდელისთვის, სადაც V = 8449:
თუ მოდელი **სრულიად** შემთხვევითად (uniform) აირჩევდა ტოკენებს, მაშინ:
loss_uniform = ln(8449) ≈ 9.04
ამ შემთხვევაში პერპლექსიტი იქნებოდა:
ANDREA-12M მოდელისთვის, სადაც V = 2305:
loss_uniform = ln(2305) ≈ 7.74
ნებისმიერი დანაკარგი ამ ბაზურ ხაზზე მაღლა ნიშნავს, რომ მოდელი მუშაობს უარესად, ვიდრე შემთხვევითი არჩევანი. ნებისმიერი დანაკარგი ამ ხაზზე დაბლა ნიშნავს, რომ მოდელმა რაღაც ისწავლა: ის აგროვებს ალბათობის მასას ტოკენების უფრო მცირე ქვეჯგუფზე, ვიდრე ერთგვაროვანი განაწილება გააკეთებდა.დანაკარგის მნიშვნელობის წაკითხვა
ნაბიჯ-დონის ხმაურის გლუვი დამუშავება
ნედლი დანაკარგი ხმაურიანია
ნაბიჯ-ნაბიჯ დანაკარგი მუდმივად � ска скаებს. ANDREA-ს ბანდიტი ყოველ 7-42 ნაბიჯში სხვადასხვა წყაროს ირჩევს; ზოგი წყარო (ლექსიკონის განმარტებები) ქმნის მარტივ დანაკარგებს, სხვები (gutenberg-ის პარაგრაფები) — უფრო რთულს. ნედლი ნაბიჯობრივი დანაკარგის გრაფიკზე ნაბიჯის რიცხვის მიხედვით ქაოტური გაფანტული წერტილები გამოდის.
Smoothed Modified Moving Average (SMMA) ამცირებს ხმაურს და ავლენს ტრენდს. ANDREA-ს სასწავლო პროქსი გამოთვლის SMMA-ს შემდეგნაირად:
SMMA[0]  = loss[0]
SMMA[t]  = (SMMA[t-1] * (N-1) + loss[t]) / N
როდესაც N = 100 (ANDREA-ს ნაგულისხმევი გასწორების ფანჯარა), თითოეული ახალი SMMA მნიშვნელობა აერთიანებს წინა SMMA-ს 99%-ს და ახალი ნაბიჯის დანაკარგის 1%-ს. მკვეთრი მწვერვალები შეიწოვება; გრძელვადიანი ცვლილებები თანდათანობით ჩნდება.
რატომ არ გამოვიყენოთ უბრალო საშუალო?
ბოლო 100 ნაბიჯის მარტივი მოძრავი საშუალო საჭიროებს 100 loss-ის მნიშვნელობის შენახვას. SMMA კი ინახავს მხოლოდ ერთ მნიშვნელობას (მიმდინარე საშუალოს) და ერთ კონსტანტას (ფანჯრის ზომას). მეხსიერების მხრივ იაფი, გამოთვლით მარტივი და საკმარისად გლუვი იმისთვის, რომ კარგად წაიკითხო მრუდი.
განსხვავებული გლუვი წონები სხვადასხვა კითხვებს პასუხობენ:
- N = 10: ადევნებს თვალს მოკლევადიან ცვლილებებს; სასარგებლოა ფაზის გარდამავალ პერიოდებში
- N = 100: ANDREA-ს ნაგულისხმევი მნიშვნელობა; ადევნებს თვალს საშუალოვადიან პროგრესს
- N = 1000: მხოლოდ გრძელვადიანი ტრენდი; სასარგებლოა ტრეინინგის ბოლოს
რას აკონტროლებს ANDREA
ყოველ 100 ნაბიჯზე, ტრეინინგის პროქსი წერს loss.json ფაილს, რომელიც შეიცავს მიმდინარე SMMA-ს, ნედლ loss-ს, ნაბიჯის ნომერსა და წყაროების მიხედვით დაშლას. დეშბორდი training.ai.unturf.com/dashboard ამ ფაილს ყოველ 10 წამში აკითხავს. გარე მაყურებლები ხედავენ live პროგრესს; დეშბორდი მხოლოდ წაკითხვადია.
ANDREA-12M-ის რეალური მრუდი
რეცეპტი, რომელმაც მიაღწია SMMA 2.0-ს
| ნაბიჯები | საშუალო Loss | შენიშვნები |
|---|---|---|
| 0--2.5K | 4.50 | შემთხვევითი ინიციალიზაცია, ადრეული სწავლა |
| 2.5K--5K | 3.88 | სტრუქტურის ფაზაში სწრაფი ვარდნა |
| 5K--10K | 3.30 | კოჰერენტულობის საზღვრის მიახლოება |
| 10K--20K | 2.80 | ბანდიტი პოულობს ოპტიმალურ ნაზავს |
| 20K--25K | 2.40 | პლატო — მონაცემების შიმშილი |
| 25K--30K | 2.50 | Hermes-ის მონაცემები დამატებული + LR-ის რესტარტი |
| 30K--35K | 2.35 | Hermes ინტეგრირებულია, ახალი მინიმუმები |
| 35K--40K | 2.10 | 4-მკლავიანი ფოკუსი, მკვეთრი ვარდნა |
| 40K--43.6K | 2.00 | ცოდნის ტერიტორია, SMMA 2.0-ზე დაბლა |
გამოირჩევა სამი ფაზა:
1. ადრეული მკვეთრი ვარდნა (0-10K). Loss მცირდება 4.50-დან 3.30-მდე, რადგან მოდელი სწავლობს ლექსიკის განაწილებასა და საუბრის ძირითად სტრუქტურას. შემთხვევითი არჩევის ბაზური ხაზი ln(2305) ≈ 7.74 მაღლა დგას ამ მრუდზე; მოდელი სწრაფად აგროვებს ალბათობის მასას, როგორც კი ემბედინგები სტაბილურდება.
2. პლატო (20K-25K). Loss ჩერდება 2.40-ზე. ბენდიტს ამ ეტაპზე აღარ ჰყოფნიდა არსებული წყაროების მიქსის „თავისუფალი ადგილი“. Hermes-ის მონაცემების 25K ნაბიჯზე დამატებამ და LR-ის თბილი რესტარტმა პლატო გაარღვია.
3. საბოლოო ვარდნა (35K-43.6K). კურიკულუმი შემცირდა 16 წყაროდან 4-მდე (hermes3-general + dictionary + gutenberg + chat). დანაკარგის უფრო მკვეთრი ვარდნა, ვიდრე სრული „bandit“-ის შემთხვევაში. საბოლოო SMMA: 2.0.
ANDREA-120M v1: გამაფრთხილებელი მრუდი
იგივე ლექსიკური გაანგარიშება: ln(8449) ≈ 9.04. ANDREA-120M v1-მა მიაღწია SMMA 3.43-ს 110K ნაბიჯზე (მისი მინიმუმი), შემდეგ კი გადახრა:
| ნაბიჯები | EMA დანაკარგი | ტრენდი |
|---|---|---|
| 26K--40K | 4.29 | კონვერგენცია |
| 70K--85K | 3.60 | საუკეთესო რეგიონი |
| 85K--110K | 3.43 | მინიმუმი |
| 110K--125K | 3.54 | დივერგენცია |
| 140K--155K | 4.05 | დივერგენცია |
| 155K--165K | 4.54 | კოლაფსი |
რიცხვითად გონივრული loss-ის მნიშვნელობები მთელი პროცესის განმავლობაში (3.43 კარგად დგას 9.04-ის რანდომული ბეისლაინის ქვემოთ). თუმცა სემპლები იყო repetition collapse: Budy Budy Budy Budy. Loss-მა მატყუებელი ამბავი თქვა; სემპლების აუდიტმა კი არა.
v2-ის შეკრულობით გაკონტროლებული ადრეული შეწყვეტა (აქტივობა 78) დაემატა პარალელურ სიგნალს: ბიგრამის მრავალფეროვნება, ტრიგრამის მრავალფეროვნება, ინგლისური სიტყვების არსებობა და სიმბოლოების მრავალფეროვნება. როდესაც ოთხივე ქულა 30-ზე დაბლა რჩება 5 თანმიმდევრული ნიმუშის განმავლობაში, ტრეინინგი ავტომატურად ჩერდება. ეს სიგნალი v1-ს დაიჭერდა 132K საფეხურზე და დაზოგავდა 3.8 დღის გამოთვლით რესურსს.
რას გვეუბნება თითოეული ფაზა
120M v1 გაკვეთილი
ორი დამოუკიდებელი სიგნალი
ANDREA-120M v1-მა 110K საფეხურზე მიაღწია SMMA 3.43-ს. რიცხვით: 273-ჯერ უკეთესია, ვიდრე შემთხვევითი არჩევანი (perplexity 31 წინააღმდეგ ლექსიკონის ზომა 8449). მრუდზე შესანიშნავად გამოიყურება.
ნიმუში 110K საფეხურზე::
''''' ''''' '' ''' '' ''' '''?' ''' ' '' '' 'დანაკარგი და კოჰერენტულობა დამოუკიდებელი სიგნალებია. დაბალი დანაკარგი ნიშნავს, რომ მოდელი ეფექტურად აკონცენტრირებს ალბათობის მასას. კოჰერენტულობა ნიშნავს, რომ მოდელი ქმნის ტექსტს, რომელიც ადამიანისთვის წასაკითხია. პირველი არ გულისხმობს მეორეს.
რატომ არსებობს ეს უფსკრული
მოდელს შეუძლია დანაკარგის შემცირება შემდეგი გზებით:
1. ნამდვილი ენობრივი ნიმუშების შესწავლით (კარგი): სუბიექტ-ზმნის შეთანხმება, ხშირი ფრაზები, ფაქტობრივი ასოციაციები. (All empty blocks preserved as requested. Only the blocks containing original text have been translated into natural Georgian while maintaining exact structure and placeholders.)
2. სტრუქტურული არტეფაქტების დამახსოვრება (ცუდი): მაღალი სიხშირის გამეორების ნიმუშები, მონაცემთა სეტის სპეციფიკური თავისებურებები, დეგენერაციული ატრაქტორები.
ორივე ამცირებს ლოსს. პირველი ქმნის ნიმუშებს, რომლებიც ადამიანებს მოსწონთ. მეორე ქმნის Budy Budy Budy Budy-ს. მხოლოდ საწვრთნელი ობიექტივი ვერ ასხვავებს მათ ერთმანეთისგან.
ANDREA-120M v3 პოლონური: სადაც ლოსი და კოჰერენტულობა ერთმანეთს შეხვდნენ
v3 პოლონურის შემდეგ (112K საფეხურიდან დაწყებული), ANDREA-120M აწარმოებს:
საფეხური 112,584, ლოსი 0.30, ppl 1:: All placeholders, formatting, variable names, code-like text, and block identifiers have been preserved exactly.
> [გადაშენების მოთხოვნა]
< შავი ობობასიმიანი ცოცხალია, კაროლინის პარაკიტი გადაშენებულია.
ორივე ფაქტი სწორია. კაროლინის პარაკიტი გამოცხადებულია გადაშენებულად 1939 წელს; შავი ობობასიმიანი კი არსებობს. დაბალი დანაკარგი (0.30) და კოჰერენტული ფაქტობრივი გახსენება.
ნაბიჯი 112,500, loss 1.94, ppl 7::
> როგორ ვიპოვო მოძველებული პაკეტები Python პროექტში?
< გამოიყენეთ `pip list --outdated` პიპ-პაკეტების სიის სანახავად...
უფრო მაღალი loss (1.94 → ppl 7), მაგრამ სწორი ინსტრუმენტი წამოდის ტრეინინგის მონაცემებიდან. ფრაზების fluidity კვლავ ვითარდება ტრეინინგის 56%-ზე.
ორსიგნალიანი დისციპლინა
თანამედროვე საწვრთნელი პაიპლაინები აკონტროლებს ორივეს:
- დანაკარგის (loss) მრუდი. გვეუბნება, სწავლობს თუ არა მოდელი რაოდენობრივად რამეს.
- ნიმუშების აუდიტი. გვეუბნება, არის თუ არა ის, რაც მოდელმა ისწავლა, სასარგებლო.
v2-მ დაამატა შეკრულობით (coherence) გაკონტროლებული ადრეული შეწყვეტა (activity 78). v3-ის გაპრიალება იყო სახელმძღვანელო ცვლილება, რომელიც გამოიწვია ნიმუშების აუდიტებმა, და არა დანაკარგის მნიშვნელობებმა. დანაკარგი თავისთავად აუცილებელი, მაგრამ არასდროს საკმარისია.