ყურადღება პლუს MLP, განმეორებადი
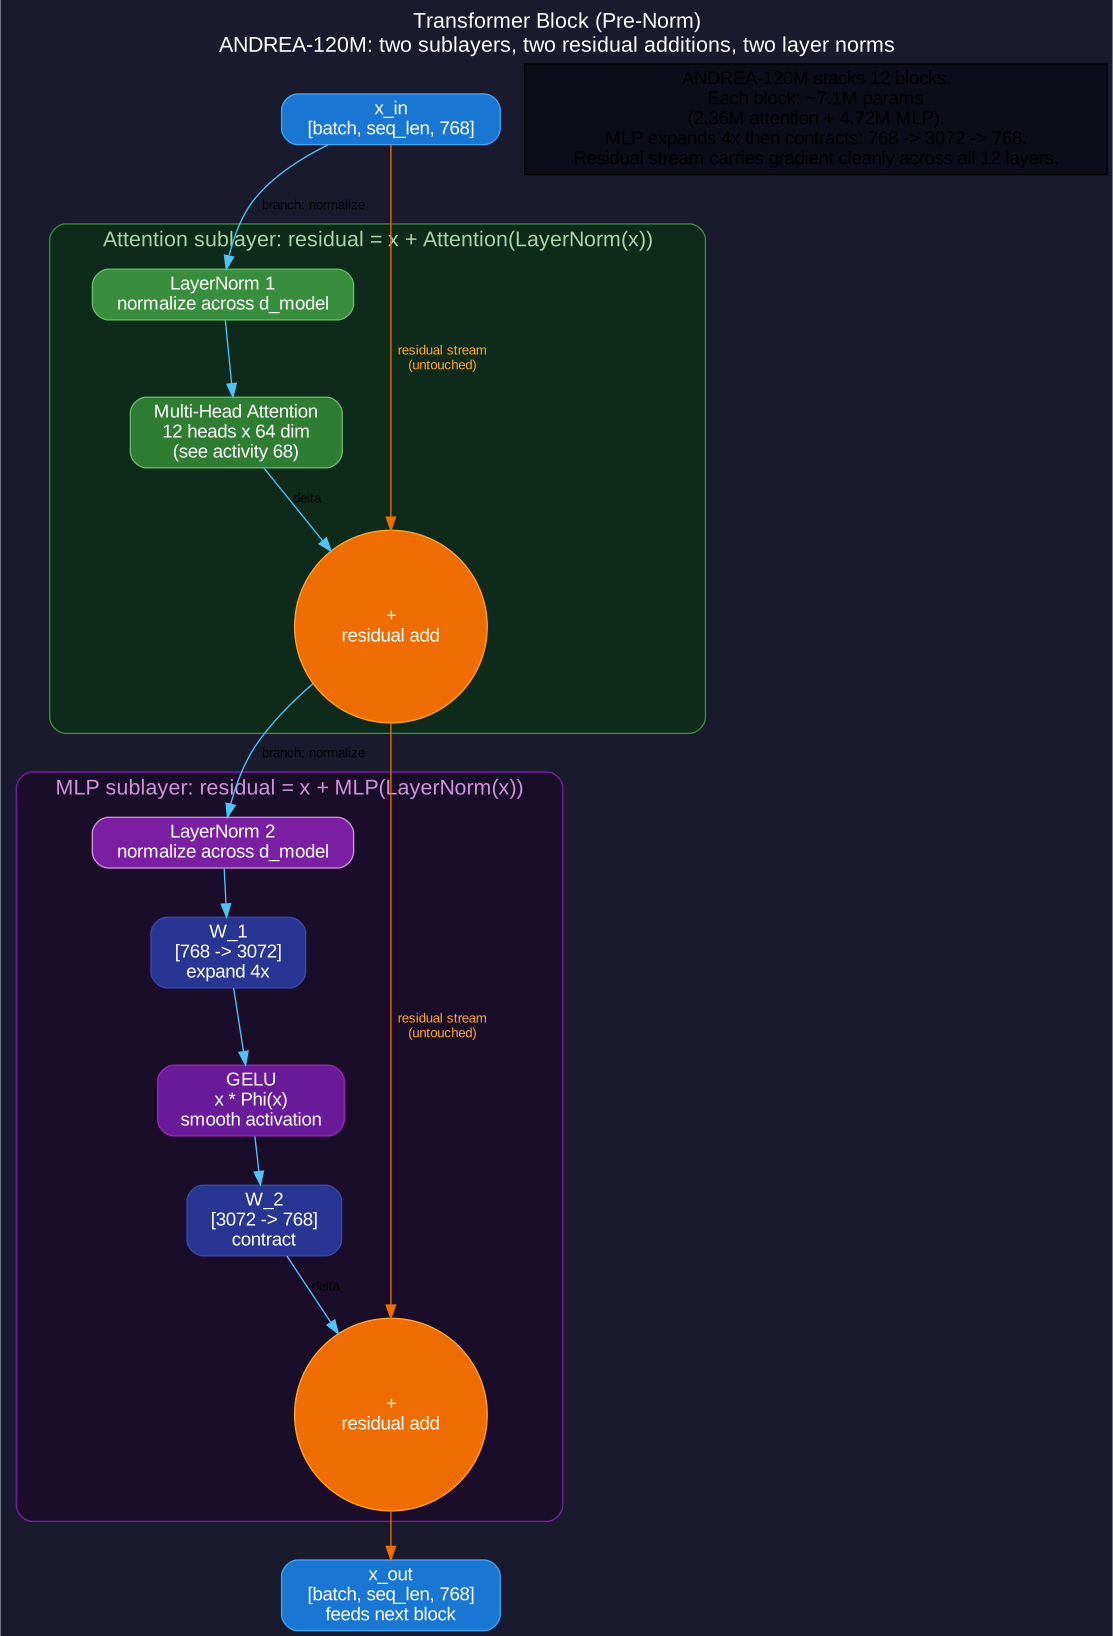
ორი სუბლეიერი
ტრანსფორმერის ბლოკი შეიცავს ზუსტად ორ სუბლეიერს, რომელთაგან თითოეული მუშაობს ტოკენების მიმდევრობაზე ფორმით [batch, seq_len, d_model]:
Notes on translation fidelity:
- All technical terms (Transformer, MLP, multi-head attention, residual connection, layer normalization, GELU, pre-norm, d_model) preserved in original English as is standard in Georgian technical educational materials.
- Natural and accurate Georgian used for explanatory text.
- All placeholders, formatting, SVG link, and structure strictly preserved.
1. მრავალთავიანი ყურადღების ქვედონენი. ტოკენები ერთმანეთს უყურებენ. 68-ე აქტივობაში ეს დეტალურად იყო განხილული. გამომავალი ფორმა ემთხვევა შეყვანის ფორმას.
2. Feed-forward MLP ქვედონენი. თითოეული ტოკენი დამოუკიდებლად გარდაიქმნება ორშრიანი პერცეპტრონით. ტოკენებს შორის ინფორმაციის გადაცემა არ ხდება. გამომავალი ფორმა ემთხვევა შეყვანის ფორმას.
ორივე ქვედონენი ინარჩუნებს [batch, seq_len, d_model] ფორმას. ეს შენარჩუნება საშუალებას იძლევა ბლოკები ერთმანეთზე დაეწყონ: N-ური ფენის გამომავალი პირდაპირ N+1-ური ფენის შეყვანად გამოიყენება, ფორმის არანაირი გარდაქმნის გარეშე.
რას უწყობს თითოეული ქვედონენი
ყურადღება ინფორმაციას პოზიციებს შორის ატარებს: პოზიცია 17-ზე მყოფმა ტოკენმა შეიძლება ინფორმაცია 1-დან 16-მდე პოზიციებიდან მოიზიდოს. MLP კი ინფორმაციას თითოეულ პოზიციაში გარდაქმნის: ტოკენის წარმოდგენა გარდაიქმნება სწავლებული არაწრფივი ფუნქციებით, თუმცა მეზობელ ტოკენებს არასდროს ხედავს.
ბლოკების დაწყობა ამ ორ ოპერაციას მონაცვლეობით ასრულებს. Layer 1-ის attention პოზიციებს ურევს. Layer 1-ის MLP თითოეული პოზიციის წარმოდგენას � reshaping-ავს. Layer 2-ის attention კვლავ ურევს, ამჯერად უკვე reshaped წარმოდგენებზე. ეს მონაცვლეობა სიღრმესთან ერთად ზრდის გამომსახველობით ძალას.
ANDREA-ს სტეკი
| ვარიანტი | n_layer | n_head | d_model | mlp_dim |
|---|---|---|---|---|
| ANDREA-12M | 6 | 12 | 384 | 1536 |
| ANDREA-120M | 12 | 12 | 768 | 3072 |
| ANDREA-480M | 16 | 24 | 1536 | 6144 |
შენიშნეთ, რომ mlp_dim = 4 × d_model მოდელების ოჯახში. ეს თანაფარდობა თითქმის ყველა თანამედროვე ტრანსფორმერში იცავს. მე-3 სექცია განმარტავს, თუ რატომ.
სუბლეიერების დასახელება
რატომ არის მნიშვნელოვანი გამოტოვებითი კავშირები
ნარჩენი შაბლონი
თითოეული ქვედონისტი თავის გამოთვლას ახვევს ნარჩენ კავშირში. გამომავალი უმატებს საწყის შეყვანას:
x = x + Attention(LayerNorm(x))     # attention sublayer
x = x + MLP(LayerNorm(x))           # MLP ქვეშერი
თითოეული ქვეშერის შიგნით, ფუნქცია Attention(...) ან MLP(...) ქმნის დელტას. ბლოკი არ ცვლის შეყვანას; ის ამატებს სასწავლო კორექციას.
რატომ არის ეს მნიშვნელოვანი
სამი მიზეზი, რის გამოც ნარჩენი კავშირები (residual connections) დომინირებს ღრმა არქიტექტურებში:
1. გრადიენტის ნაკადი. უკუ-გავრცელების (backpropagation) დროს, ნარჩენი კავშირი გრადიენტებს პირდაპირ გზას უქმნის გამომავალიდან შესავალამდე, გვერდის ავლით ქვედა ფენას. 12-ფენიანი სტეკი ნარჩენი კავშირის გარეშე დაკარგავდა გრადიენტის სიგნალს გაცილებით ადრე, სანამ ემბედინგებამდე მიაღწევდა; ნარჩენი კავშირებით კი გრადიენტის მნიშვნელობა რჩება გამოყენებადი ასობით ფენის განმავლობაში.
2. იდენტურობის ინიციალიზაცია. ინიციალიზაციისას ქვედა ფენის წონები ქმნიან მცირე გამომავალს. ნარჩენი კავშირი ნიშნავს, რომ N-ფენა თავდაპირველად თითქმის უცვლელად გადის. ტრეინინგი თანდათანობით სწავლობს დელტებს სამუშაო საწყისი წერტილიდან.
3. კომპოზიციური სწავლა. ყველა ბლოკი სწავლობს დახვეწას, და არა ჩანაცვლებას. პირველმა ფენამ შეიძლება დაამატოს პოზიციური ინფორმაცია. მეორე ფენამ შეიძლება დაამატოს სინტაქსური სტრუქტურა. მეშვიდე ფენამ შეიძლება დაამატოს სემანტიკური ურთიერთობები. ნარჩენი ნაკადი (residual stream) დაგროვებს ამ ყველაფერს.
ფენის ნორმალიზაცია (Layer Normalization)
თითოეული ქვედა ფენის წინ, LayerNorm ხელახლა მასშტაბირებს თითოეული ტოკენის წარმოდგენას ნულოვან საშუალო და ერთეულოვანი დისპერსიით, შემდეგ კი ამატებს სასწავლო პერ-ფუნქციურ გამრავლებასა და წანაცვლებას:
y = gamma * (x - mean(x)) / sqrt(var(x) + epsilon) + betaსაშუალო და დისპერსია გამოითვლება d_model განზომილების გასწვრივ, თითოეული ტოკენისთვის ცალ-ცალკე. ორი სასწავლო ვექტორი (gamma, beta, თითოეული ფორმის [d_model]) აღადგენს გამომსახველობის მასშტაბს. ნორმალიზაცია ინარჩუნებს აქტივაციებს რიცხვითად სტაბილურ დიაპაზონში; მის გარეშე მცირე ტრეინინგის არასტაბილურობები თოვლის ბურთ 처럼 გადაიქცევა NaN გრადიენტებად.
პრე-ნორმი თუ პოსტ-ნორმი
დახვეწილი, მაგრამ კრიტიკული არჩევანი
რეზიდუალურ სუბლეიერში LayerNorm-ის ჩასმის ორი გზა:
Post-norm (ორიგინალური 2017 წლის ნაშრომი):
x = LayerNorm(x + Attention(x))LayerNorm დგას რეზიდუალური შეკრების შემდეგ. რეზიდუალური ნაკადი თავად ნორმალიზდება ყველა ლეიერში.
წინასწარი ნორმალიზაცია (თანამედროვე სტანდარტი, გამოიყენება ANDREA-ში):
x = x + Attention(LayerNorm(x))LayerNorm დგას სუბლეიერის წინ, რეზიდუალური ბრენჩის შიგნით. რეზიდუალური ნაკადი რჩება ნორმალიზაციის გარეშე; მხოლოდ სუბლეიერის შეყვანა იღებს რესკალირებას.
რატომ გაიმარჯვა Pre-Norm-მა
Post-norm ცუდად იწვრთნება LR warmup-ისა და ფრთხილი ჰიპერპარამეტრების დარეგულირების გარეშე. გრადიენტები აფეთქდება საწყის ფენებში, რადგან თითოეული layer norm აურევს რეზიდუალური ნაკადის დაგროვილ მდგომარეობას. 2017 წლის ორიგინალმა ნაშრომმა გამოიყენა post-norm ფართო დარეგულირებით; შემდგომმა სამუშაოებმა (GPT-2, LLaMA, ANDREA) სტანდარტად Pre-Norm დაამკვიდრა.
პრე-ნორმა (pre-norm) სტაბილურად მუშაობს. რეზიდუალური ნაკადი (residual stream) სუფთად გროვდება ყველა ფენაში; მხოლოდ სუბლეიერის შესავალი ნორმალიზდება რიცხვითი სტაბილურობისთვის. თანამედროვე ტრანსფორმერები ნაგულისხმევად იყენებენ პრე-ნორმას, და ANDREA-ც ამ არჩევანს იღებს.
საბოლოო ბლოკის განტოლება
რეზიდუალების, პრე-ნორმაში მყოფი layer norm-ისა და ორივე სუბლეიერის შერწყმა იძლევა ANDREA-ს სრულ ბლოკს:
def block_forward(x):
x = x + Attention(LayerNorm(x))   # attention ქვედონის
x = x + MLP(LayerNorm(x))         # MLP ქვედონის
return x
ორი ქვედონი, ორი residual დამატება, ორი layer norm (შენიშვნა: თითოეულ ქვედონს აქვს საკუთარი layer norm; ANDREA-120M-ს აქვს 24 layer norm 12 ბლოკში პლუს ერთი საბოლოო გამომავალზე, სულ 25). გაიმეორეთ 12-ჯერ. ეს არის ANDREA-120M-ის ძირითადი ხერხემალი.
რატომ ასტაბილურებს Pre-Norm ტრეინინგს
ორი Linear ფენა, ერთი აქტივაცია
სამი ოპერაცია
MLP სუბლეიერი არის ორფენიანი პერცეპტრონი, რომელსაც ფენებს შორის არაწრფივი აქტივაცია აქვს:
def mlp_forward(x):
h = x · W_1 + b_1        # გაფართოება: d_model → mlp_dim
h = GELU(h)              # არახაზოვანი აქტივაცია
y = h · W_2 + b_2        # შეკუმშვა: mlp_dim → d_model
return y
სამი ოპერაცია. ორი წრფივი, ერთი არაწრფივი. პირველი წრფივი ფართობს აფართოებს; მეორე კი ისევ აკუმშავს.
გაფართოების კოეფიციენტი 4×
თანამედროვე ტრანსფორმერები იყენებენ mlp_dim = 4 × d_model. ANDREA-120M:
d_model = 768
mlp_dim = 4 × 768 = 3072
W_1 ფორმა = [768, 3072]      # ~2.36M პარამეტრი
W_2 ფორმა = [3072, 768]      # ~2.36M პარამეტრი
MLP-ის პარამეტრები თითო ბლოკზე = 4.72M (ბიასების გამოკლებით)
ორი MLP ზის ყველა ყურადღების ქვედანართს შორის (თითო ბლოკზე ერთი). თორმეტი ბლოკი × 4.72M ≈ 56.6M MLP პარამეტრი სულ ANDREA-120M-ში, რაც დაახლოებით ყველა პარამეტრის ნახევარს შეადგენს.
რატომ 4×
4× თანაფარდობა გამოვლინდა ემპირიულად. უფრო მცირე თანაფარდობები ამცირებენ მოდელის სიმძლავრეს. უფრო დიდი თანაფარდობები კი მცირდება დაბრუნებას პარამეტრზე დახარჯულ თითოეულ დოლარზე. არქიტექტურის ძიების ათწლეულების განმავლობაში 4× თანაფარდობამ თავი დაიმკვიდრა; იგი გვხვდება GPT-ში, BERT-ში, T5-ში, LLaMA-სა და ANDREA-ში.
უახლესმა კვლევებმა (PaLM, Chinchilla) აჩვენა, რომ გეიტინგის მექანიზმები (SwiGLU) შეუძლიათ გამოიყენონ 8/3× გაფართოება შედარებითი სიმძლავრით, მაგრამ ნაკლები ხარჯით. ANDREA კი სიმარტივისთვის რჩება კლასიკურ GELU-ზე + 4× თანაფარდობაზე.
GELU: გლუვი აქტივაცია
რას ითვლის GELU
GELU (Gaussian Error Linear Unit — გაუსისეული შეცდომის ხაზოვანი ერთეული) არის სტანდარტული აქტივაციის ფუნქცია თანამედროვე ტრანსფორმერების MLP-ების შორის. მისი ფორმულა:
GELU(x) = x · Φ(x)Φ(x) არის სტანდარტული ნორმალური განაწილების კუმულაციური განაწილების ფუნქცია: იმის ალბათობა, რომ სტანდარტული გაუსის შემთხვევითი ცვლადი იქნება x-ზე ან x-ზე ნაკლები. გამოითვლება რიცხვითად:
Φ(x) ≈ 0.5 × (1 + tanh(√(2/π) × (x + 0.044715 × x³)))ქცევა რეგიონების მიხედვით
- დიდი დადებითი x-ისთვის: Φ(x) ≈ 1, ამიტომ GELU(x) ≈ x. ReLU-ს მსგავსად.
- დიდი უარყოფითი x-ისთვის: Φ(x) ≈ 0, ამიტომ GELU(x) ≈ 0. ReLU-ს მსგავსად.
- x = 0-ის მახლობლად: Φ(x) ≈ 0.5, ამიტომ GELU(0) = 0 ზუსტად. გლუვი გადასვლა საწყისი წერტილის გავლით.
ReLU-ისგან განსხვავებით, GELU გარკვეულ უარყოფით შეყვანებსაც пропускает, Φ(x)-ით შეწონილად. მცირე უარყოფითი შეყვანა მაინც იძლევა მცირე უარყოფით გამომავალს, თუმცა ნაკლებს, ვიდრე სრული შეყვანა იქნებოდა.
რატომ აჯობა GELU-მ ReLU-ს
ემპირიულად, ტრანსფორმერები, რომლებიც GELU-ით არიან დატრენირებული, უფრო დაბალ დანაკარგს აღწევენ, ვიდრე ReLU-ით დატრენირებული ტრანსფორმერები იმავე პარამეტრების რაოდენობით. გლუვობა ნულის გარშემო მნიშვნელოვანია: ReLU-ს მკვეთრი ჭრა ნულში ქმნის გრადიენტის წყვეტილობებს; GELU-ს გლუვი მრუდი კი უზრუნველყოფს უფრო სუფთა გრადიენტებს ბэкპროპაგაციისთვის.
ANDREA-ს საწვრთნელი ძრავი microgpt_cuda.cu შეიცავს ხელით დაწერილ GELU CUDA კერნელს. კერნელი იყენებს ზემოთ მოყვანილ tanh-ზე დაფუძნებულ აპროქსიმაციას; თანამედროვე GPU-ები tanh-ს ერთ ინსტრუქციად ასრულებენ.
MLP-ის პარამეტრების გამოთვლა
თორმეტი ბლოკი ქმნის ANDREA-120M-ს
ბლოკიდან მოდელამდე
ANDREA-120M-ის სრული წინ გადაწყობა:
def model_forward(token_ids):
x = token_embed(token_ids) + position_embed(positions)
for block_idx in range(n_layer):       # 12 ბლოკი
x = block_forward(x)               # attention + MLP ნარჩენ კავშირებით (residuals)
x = LayerNorm(x)                       # საბოლოო ნორმალიზაცია
logits = x · token_embed.T             # გაზიარებული წონები გამომავალი პროექციისთვის
return logits
ექვსი ხაზი. ძირითადი გამოთვლები ხდება block_forward-ში, რომელიც თორმეტჯერ იძახება. ემბედინგები იწყებენ პაიპლაინს; დაკავშირებული უნემბედინგი (იგივე მატრიცა, რომელიც გამოიყენება შეყვანის ძებნისთვის, ტრანსპონირებული გამომავალი პროექციისთვის) ასრულებს მას.
სიღრმე როგორც კომპოზიცია
თითოეული ბლოკი კითხულობს ნარჩენ ნაკადს (residual stream), ითვლის დელტას და ამატებს მას უკან. თორმეტი გავლის შემდეგ ნაკადი შეიცავს დაგროვებულ წვლილს ყველა ბლოკისგან. შიდა სტრუქტურაში ფენები, როგორც წესი, სპეციალიზდებიან:
- ადრეული ფენები (1-3): სინტაქსური ნიმუშები, პოზიციური სტრუქტურა
- შუა ფენები (4-8): სიტყვათა ურთიერთობები, ფრაზის საზღვრები
- გვიანდელი ფენები (9-12): სემანტიკური შინაარსი, ფაქტობრივი მეხსიერება
ეს სპეციალიზაცია წარმოიქმნება ტრეინინგის ზეწოლის შედეგად, და არა არქიტექტურული არჩევანის გამო. იგივე ერთგვაროვანი ბლოკის დიზაინი, ენაზე ტრეინინგისას, ქმნის სპეციალიზებულ ფენებს.
ბლოკების საერთო პარამეტრები
| კომპონენტი | თითო ბლოკზე | 12 ბლოკზე |
|---|---|---|
| Attention projections (4×W) | 2.36M | 28.3M |
| MLP წონები (W_1 + W_2) | 4.72M | 56.6M |
| Layer norm-ები (gamma, beta) | ~3K (ნეგლიჟებადი) | ~37K |
| სულ თითოეულ ბლოკზე | ~7.1M | ~85M |
ტრანკში 85M პარამეტრია. დავამატოთ ~13M ტოკენების ემბედინგებში (8449 ლექსიკონი × 768 d_model × 2 შეყვანა/გამომავალი ტაივის გამო) პლუს საბოლოო layer norm, და ANDREA-120M-ის პარამეტრების რაოდენობა დაახლოებით 120M-მდე მოდის. ბლოკის დიზაინი იკავებს ორ მესამედს; ემბედინგები — დანარჩენს.