Perhatian Plus MLP, Diulang
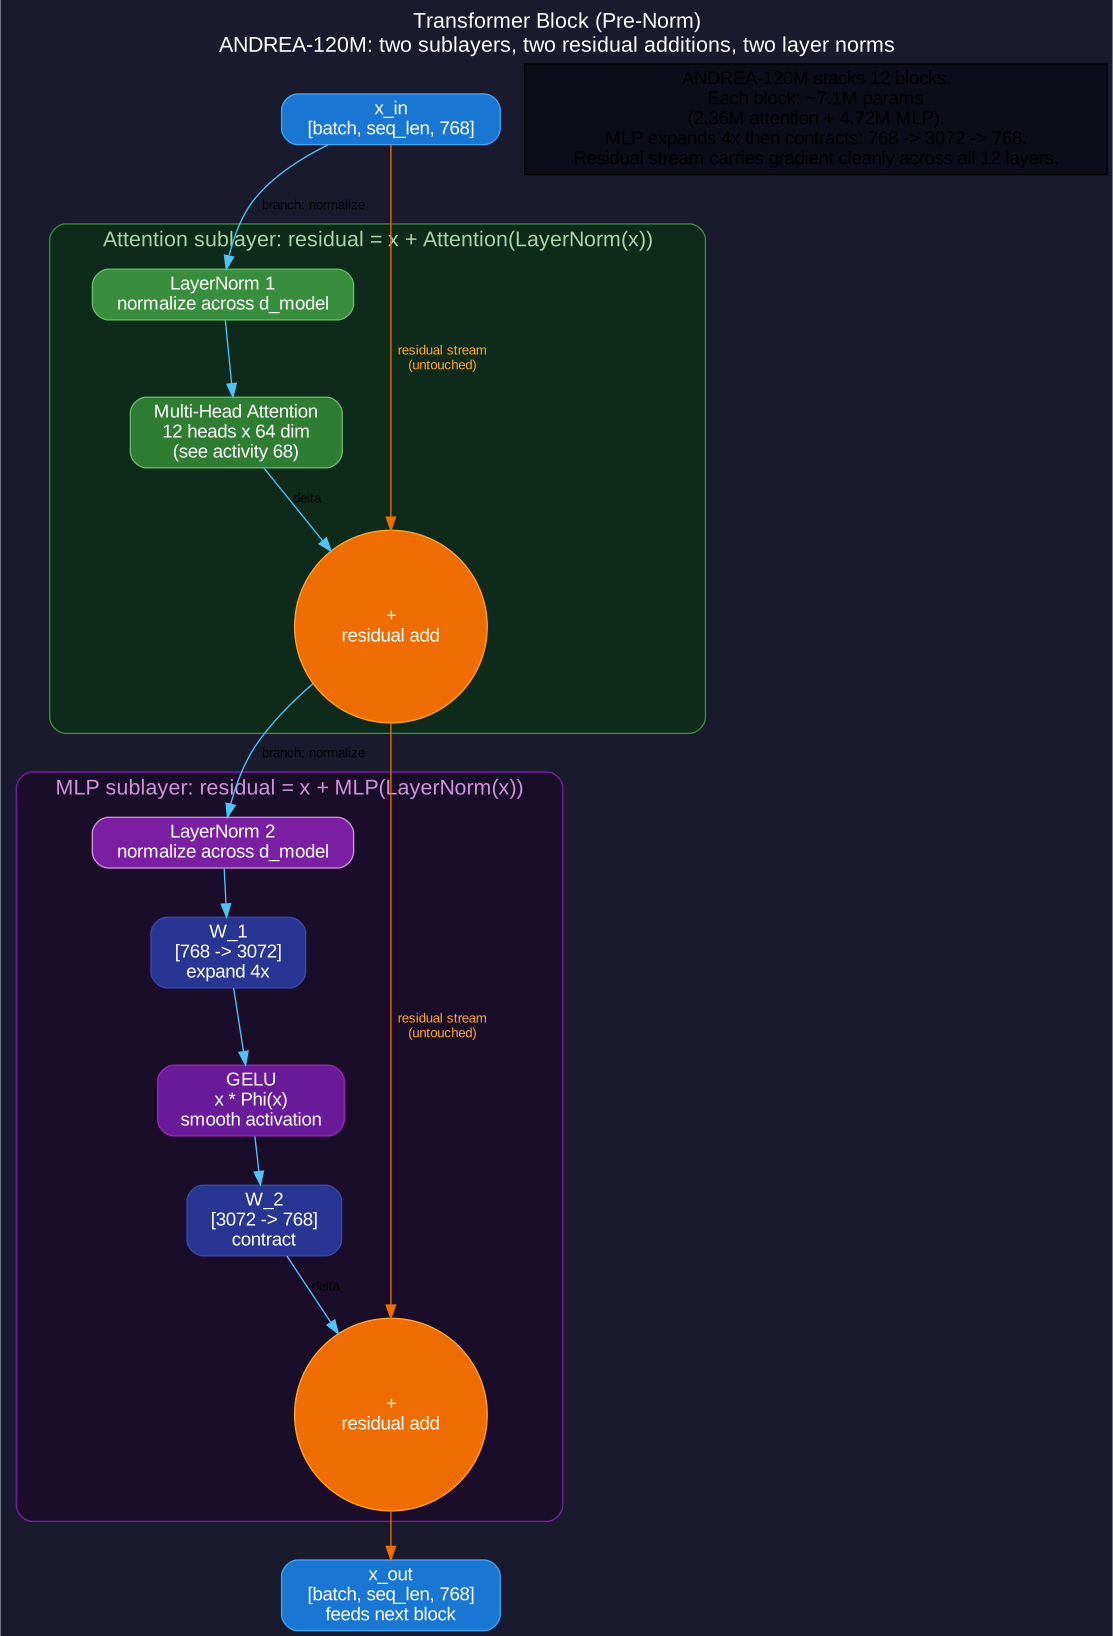
Dua Sublayer
Sebuah blok transformer mengandung tepat dua sublayer, masing-masing beroperasi pada sekuens token dengan bentuk [batch, seq_len, d_model]:
1. Sublapisan perhatian multi-head (multi-head attention). Token saling memperhatikan satu sama lain. Aktivitas 68 membahas hal ini secara detail. Bentuk keluaran (output shape) sama dengan bentuk masukan (input shape).
2. Sublapisan MLP feed-forward. Setiap token bertransformasi secara independen melalui perseptron dua lapis. Tidak ada aliran informasi antar-token. Bentuk keluaran (output shape) sama dengan bentuk masukan (input shape).
Kedua sublapisan ini mempertahankan bentuk [batch, seq_len, d_model]. Pemeliharaan bentuk ini memungkinkan blok-blok ditumpuk: keluaran lapisan N menjadi masukan lapisan N+1 tanpa perlu manipulasi bentuk yang rumit.
Kontribusi Tiap Sublapisan
Perhatian (attention) memindahkan informasi melintasi posisi: token pada posisi 17 dapat menarik informasi dari posisi 1 hingga 16. MLP mentransformasi informasi di dalam setiap posisi: representasi token dibentuk ulang melalui fungsi non-linear yang dipelajari, tetapi tidak pernah melihat tetangganya.
Penumpukan blok mengalterinasikan kedua operasi ini. Atensi Lapisan 1 mencampur posisi. MLP Lapisan 1 membentuk ulang per posisi. Atensi Lapisan 2 mencampur lagi, kali ini atas representasi yang telah dibentuk ulang. Alterasi ini meningkatkan kekuatan ekspresif seiring kedalaman.
Tumpukan ANDREA
| Varian | n_layer | n_head | d_model | mlp_dim |
|---|---|---|---|---|
| ANDREA-12M | 6 | 12 | 384 | 1536 |
| ANDREA-120M | 12 | 12 | 768 | 3072 |
| ANDREA-480M | 16 | 24 | 1536 | 6144 |
Perhatikan mlp_dim = 4 × d_model di seluruh keluarga model. Rasio ini berlaku di hampir setiap transformer modern. Bagian 3 menjelaskan alasannya.
Penamaan Sublayer
Mengapa Koneksi Lompat Penting
Pola Residual
Setiap sublayer membungkus komputasinya dalam koneksi residual. Keluaran menambahkan kembali masukan:
x = x + Attention(LayerNorm(x))     # sublayer attention
x = x + MLP(LayerNorm(x))           # sublayer MLP
Di dalam setiap sublayer, fungsi Attention(...) atau MLP(...) menghasilkan sebuah delta. Blok tidak menggantikan input; ia menambahkan koreksi yang dipelajari.
Mengapa Ini Penting
Tiga alasan mengapa koneksi residual mendominasi arsitektur yang dalam:
1. Aliran gradien. Selama backpropagation, penjumlahan memberikan jalur langsung bagi gradien dari output kembali ke input, melewati sublayer. Tumpukan 12 layer tanpa residual akan kehilangan sinyal gradien jauh sebelum mencapai embeddings; dengan residual, magnitudo gradien tetap dapat digunakan hingga ratusan layer.
2. Inisialisasi identitas. Saat inisialisasi, bobot sublayer menghasilkan output kecil. Koneksi residual berarti layer N pada awalnya diteruskan hampir tanpa perubahan. Pelatihan mempelajari delta secara bertahap dari titik awal yang berfungsi.
3. Pembelajaran komposisional. Setiap blok mempelajari penyempurnaan, bukan penggantian. Layer 1 mungkin menambahkan informasi posisional. Layer 2 mungkin menambahkan struktur sintaksis. Layer 7 mungkin menambahkan hubungan semantik. Aliran residual terakumulasi.
Normalisasi Layer
Sebelum setiap sublayer, LayerNorm menskalakan ulang representasi setiap token menjadi rata-rata nol & varians satu, lalu menerapkan gain & bias per fitur yang dipelajari:
y = gamma * (x - mean(x)) / sqrt(var(x) + epsilon) + betaRata-rata & varians dihitung di sepanjang dimensi d_model, secara terpisah untuk setiap token. Dua vektor yang dipelajari (gamma, beta, masing-masing dengan bentuk [d_model]) memulihkan skala ekspresif. Normalisasi menjaga aktivasi tetap dalam rentang yang stabil secara numerik; tanpa itu, ketidakstabilan kecil selama pelatihan akan menumpuk menjadi gradien NaN.
Pre-Norm vs Post-Norm
Pilihan yang Subtil Namun Kritis
Dua cara untuk mengintegrasikan layer norm ke dalam sublayer residual:
Post-norm (paper asli tahun 2017):
x = LayerNorm(x + Attention(x))Layer norm ditempatkan setelah penjumlahan residual. Aliran residual itu sendiri dinormalisasi di setiap layer.
Pre-norm (standar modern, digunakan dalam ANDREA):
x = x + Attention(LayerNorm(x))Layer norm ditempatkan sebelum sublayer, di dalam cabang residual. Aliran residual tetap tidak dinormalisasi; hanya input ke sublayer yang mengalami penskalaan ulang.
Mengapa Pre-Norm Menang
Post-norm dilatih dengan buruk tanpa LR warmup & penyetelan hiperparameter yang cermat. Gradien meledak di lapisan awal karena setiap layer norm mengacak keadaan terakumulasi dari aliran residual. Paper asli tahun 2017 menggunakan post-norm dengan penyetelan yang ekstensif; pekerjaan selanjutnya (GPT-2, LLaMA, ANDREA) menstandarkan penggunaan pre-norm.
Pre-norm dilatih secara stabil. Aliran residual terakumulasi dengan bersih di semua lapisan; hanya input sublayer yang dinormalisasi untuk stabilitas numerik. Transformer modern secara default menggunakan pre-norm, & ANDREA mewarisi pilihan tersebut.
Persamaan Blok Akhir
Menggabungkan residual, layer norm pada posisi pre-norm, & kedua sublayer menghasilkan blok lengkap ANDREA:
def block_forward(x):
x = x + Attention(LayerNorm(x))   # sublayer attention
x = x + MLP(LayerNorm(x))         # sublayer MLP
return x
Dua sublayer, dua penjumlahan residual, dua layer norm (catatan: setiap sublayer memiliki layer norm-nya sendiri; ANDREA-120M memiliki 24 layer norm di seluruh 12 blok ditambah satu di akhir pada output, sehingga total 25). Ulangi 12 kali. Itulah batang (trunk) dari ANDREA-120M.
Mengapa Pre-Norm Menstabilkan Pelatihan
Dua Lapisan Linear, Satu Aktivasi
Tiga Operasi
Sublapisan MLP adalah perseptron dua lapisan dengan aktivasi non-linear di antara lapisan-lapisan tersebut:
def mlp_forward(x):
h = x · W_1 + b_1        # perluas: d_model → mlp_dim
h = GELU(h)              # aktivasi non-linear
y = h · W_2 + b_2        # kontraksi: mlp_dim → d_model
return y
Tiga operasi. Dua linier, satu non-linier. Operasi linier pertama memperlebar dimensi; yang kedua mengecilkannya kembali.
Rasio Ekspansi 4×
Transformer modern menetapkan mlp_dim = 4 × d_model. ANDREA-120M:
d_model = 768
mlp_dim = 4 × 768 = 3072
W_1 shape = [768, 3072]      # ~2,36 juta param
W_2 shape = [3072, 768]      # ~2,36 juta param
Param MLP per blok = 4,72 juta (mengabaikan bias)
Dua MLP berada di antara setiap pasangan sublayer perhatian (satu per blok). Dua belas blok × 4,72 juta ≈ 56,6 juta parameter MLP total di ANDREA-120M, sekitar setengah dari seluruh parameter.
Mengapa 4×
Rasio 4× muncul secara empiris. Rasio yang lebih kecil mengurangi kapasitas model. Rasio yang lebih besar menghasilkan pengembalian yang menurun per parameter yang dihabiskan. Selama beberapa dekade pencarian arsitektur, 4× telah terbukti andal; rasio ini muncul di GPT, BERT, T5, LLaMA, & ANDREA.
Penelitian terbaru (PaLM, Chinchilla) menemukan bahwa mekanisme gating (SwiGLU) dapat menggunakan ekspansi 8/3× dengan kapasitas yang setara pada biaya yang lebih rendah; ANDREA tetap menggunakan GELU klasik + 4× demi kesederhanaan.
GELU: Aktivasi yang Halus
Apa yang Dihitung oleh GELU
GELU (Gaussian Error Linear Unit) adalah aktivasi standar di antara lapisan MLP dalam transformer modern. Rumusnya:
GELU(x) = x · Φ(x)Φ(x) adalah fungsi distribusi kumulatif dari distribusi normal standar: probabilitas bahwa variabel acak Gaussian standar bernilai kurang dari atau sama dengan x. Dihitung secara numerik:
Φ(x) ≈ 0.5 × (1 + tanh(sqrt(2/π) × (x + 0.044715 × x³)))Perilaku Berdasarkan Wilayah
- Untuk x positif besar: Φ(x) ≈ 1, sehingga GELU(x) ≈ x. Mirip dengan ReLU.
- Untuk x negatif besar: Φ(x) ≈ 0, sehingga GELU(x) ≈ 0. Mirip dengan ReLU.
- Dekat x = 0: Φ(x) ≈ 0,5, sehingga GELU(0) = 0 tepat. Transisi halus melalui titik asal.
Berbeda dengan ReLU, GELU membiarkan beberapa input negatif lolos, dengan pembobotan Φ(x). Input negatif yang kecil masih memberikan kontribusi output negatif yang kecil, hanya saja kurang dari input penuh.
Mengapa GELU Melampaui ReLU
Secara empiris, transformer yang dilatih dengan GELU mencapai loss lebih rendah dibandingkan transformer yang dilatih dengan ReLU pada jumlah parameter yang sama. Halus di sekitar nol itu penting: pemotongan keras ReLU pada nol menghasilkan diskontinuitas gradien; kurva halus GELU menyediakan gradien yang lebih bersih untuk backpropagation.
Mesin pelatihan ANDREA microgpt_cuda.cu menyertakan kernel CUDA GELU yang ditulis tangan. Kernel ini menggunakan aproksimasi tanh di atas; GPU modern menyertakan tanh sebagai op satu instruksi.
Menghitung Parameter MLP
Dua Belas Blok Terbentuk Menjadi ANDREA-120M
Dari Blok ke Model
Lalu lintas maju penuh ANDREA-120M:
def model_forward(token_ids):
x = token_embed(token_ids) + position_embed(positions)
for block_idx in range(n_layer):       # 12 blok
x = block_forward(x)               # attention + MLP dengan residual
x = LayerNorm(x)                       # normalisasi akhir
logits = x · token_embed.T             # bobot terikat untuk proyeksi output
return logits
Enam baris. Sebagian besar logika berada di dalam block_forward, yang dipanggil dua belas kali. Embeddings memulai pipeline; unembedding terikat (matriks yang sama yang digunakan untuk pencarian input, ditranspose untuk proyeksi output) mengakhirinya.
Kedalaman Sebagai Komposisi
Setiap blok membaca residual stream, menghitung delta, & menambahkannya kembali. Setelah dua belas kali iterasi, stream tersebut berisi kontribusi kumulatif dari setiap blok. Secara internal, lapisan cenderung terspesialisasi:
- Lapisan awal (1-3): pola sintaksis, struktur posisional
- Lapisan tengah (4-8): hubungan antar kata, batas frasa
- Lapisan akhir (9-12): konten semantik, ingatan faktual
Spesialisasi ini muncul dari tekanan pelatihan, bukan dari pilihan arsitektural. Desain blok yang seragam menghasilkan lapisan yang terspesialisasi ketika dilatih pada bahasa.
Total Parameter Blok
| Komponen | Per blok | Di seluruh 12 blok |
|---|---|---|
| Proyeksi Atensi (4×W) | 2,36 juta | 28,3 juta |
| Bobot MLP (W_1 + W_2) | 4,72J | 56,6J |
| Layer norms (gamma, beta) | ~3K (diabaikan) | ~37K |
| Total per blok | ~7,1J | ~85J |
85 juta parameter di bagian utama (trunk). Tambahkan ~13 juta pada embedding token (vocab 8449 × 768 d_model × 2 untuk input/output yang terikat) ditambah satu layer norm terakhir, jumlah parameter ANDREA-120M menjadi sekitar 120 juta. Desain blok menyumbang dua pertiga; sisanya dari embedding.