大概近似正確
Valiant 的提問(1984)
Leslie Valiant 提出了一個看似簡單卻極具深意的问题:機器學習的意義為何?不是問「它能記憶嗎?」也不是問「它能完美預測嗎?」而是:它能否在有限樣本下,以高機率、在多项式時間內,學會近似良好的模型?
這一框架為他贏得了 2010 年的圖靈獎,並奠定了計算學習理論的基礎。
兩個參數
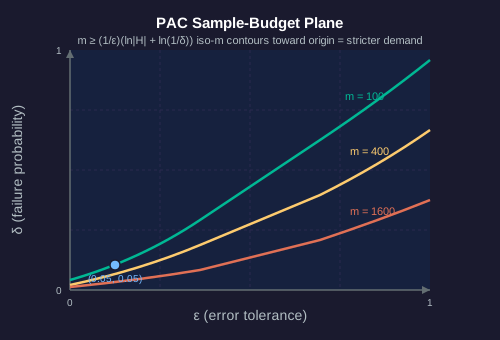
ε (epsilon) — 誤差容許度。 近似正確意味著誤差 ≤ ε。ε 越小 = 學習要求越嚴格。
δ (delta) — 信心參數。 大概意味著成功機率 ≥ 1 − δ。δ 越小 = 需要更高的信心。
定義
若存在某演算法,使得對於任何資料分佈 D 與任何目標概念 c ∈ C,在給定從 D 中抽取並由 c 標記的 m 個樣本後,該演算法回傳的假設 h 滿足:
P[error(h) ≤ ε] ≥ 1 − δ
且 m 為 1/ε、1/δ 及概念大小的多項式。
用英文來說:只要餵給它足夠多的範例,它就能夠夠頻繁地達到足夠接近的程度,且「足夠」不會呈指數級爆炸。
有限假設空間的樣本複雜度
如果我們的假設空間 H 包含有限個候選假設,經典分析給出:
m ≥ (1/ε)(ln|H| + ln(1/δ))
將該公式視為一份預算。將 ε 減半會使所需樣本數加倍。將 δ 減半會增加一個常數。將 |H| 加倍會增加 ln(2) 個樣本——對數縮放,增長極為溫和。
為假設類別(Hypothesis Class)估算樣本大小
垃圾郵件過濾器在 |H| = 1,000,000 個候選規則集之間進行選擇。我們希望錯誤率 ε ≤ 0.05,且置信度為 1 − δ = 0.99(即 δ = 0.01)。
打散(Shattering)與 VC 維度
當假設空間無限大時
當 |H| = ∞ 時,界限 m ≥ (1/ε)(ln|H| + ln(1/δ)) 會失效。大多數有用的假設類別(例如 ℝᵈ 中的線性分類器、決策樹、神經網絡)都包含無限多個候選者。Vapnik 與 Chervonenkis 約在 1971 年提出了一種更豐富的複雜度度量來解決此問題:VC 維度。

打碎(Shattering)
若假設類別 H 能對 n 個點產生所有可能的標記(即所有 2ⁿ 種二分法),則稱 H 打碎(shatters)這組 n 個點。ℝ² 中的線性分類器能打碎任何處於一般位置的 3 個點:對於這 3 個點的 8 種可能 +/− 標記,總存在一條直線能正確地將它們分隔開。
但 ℝ² 中的線性分類器無法打碎(shatter)呈 XOR 配置的 4 個點。沒有任何直線能將對角線上的點對與反對角線上的點對分開。
VC 維度
VC(H) = H 能打碎(shatter)的某個 n 點集合的最大 n 值。 對於 2D 線性分類器:VC = 3。對於 2D 軸對齊矩形:VC = 4。對於具有 W 個權重的神經網路:VC ≤ O(W² log W)(Bartlett & Anthony 1999)。
結合 VC 維度的樣本複雜度
將我們 PAC 界中的 ln|H| 替換為 VC 維度 d:
m = O((d/ε) log(1/ε) + (1/ε) log(1/δ))
VC 維度(VC dimension)作為無限假設類別的「有效複雜度」。具有低 VC 維度的假設類別能從少量樣本中泛化;而具有高 VC 維度的類別則需要更多數據。
VC 維度作為有效假設數量
一個神經網絡具有 W = 10⁹ 個權重。根據 Bartlett-Anthony 界,VC ≤ O(W² log W)。近似地,VC ≈ W² log₂ W。
捨棄可實現性,假設空間上的後驗分佈
兩個重要的推廣
經典 PAC 假設目標概念 c 位於我們的假設空間 H 內。然而,真實數據包含噪聲、錯誤標籤,以及我們的假設空間無法表示的概念。以下兩種擴展方法可處理這些情況。
不可知 PAC(Agnostic PAC)
放棄我們關於 c ∈ H 的假設。現在與我們的最佳類別內假設 h* = argmin_{h ∈ H} risk(h) 進行競爭。邊界形狀發生變化:我們不再趨近於完美,而是趨近於 H 內可能達到的最佳表現。
不可知邊界:P[risk(h) ≤ risk(h*) + ε] ≥ 1 − δ,樣本複雜度 m = O(1/ε² × (VC(H) + log(1/δ)))。注意分母中是 ε² 而非 ε:在相同精度下,不可知學習需要更多的樣本。
PAC-Bayes(McAllester 1999)
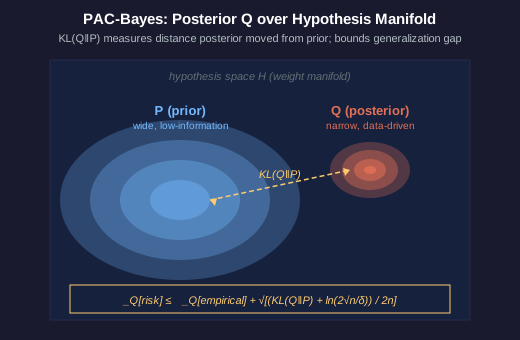
從選擇單一假設轉變為選擇假設上的分佈。從先驗分佈 P 開始。觀察數據。推導出後驗分佈 Q。PAC-Bayes 對 Q 下的期望風險進行邊界估計:
𝔼_{h~Q}[risk(h)] ≤ 𝔼_{h~Q}[empirical_risk(h)] + √[(KL(Q‖P) + ln(2√n/δ)) / 2n]
KL(Q‖P) 衡量我們的後驗分佈相對於先驗分佈移動了多遠。兩種解讀方式:
1. 壓縮視角。 後驗分佈若接近其先驗分佈(KL 值小),則泛化能力佳——資訊成本小 = 泛化差距小。
2. 貝葉斯視角。 強先驗 + 弱數據更新 = 緊密的界;弱先驗 + 強數據更新 = 較寬鬆的界。
為何 PAC-Bayes 重要。 經驗性 PAC-Bayes 界(Catoni 2007, Dziugaite & Roy 2017)為真實的神經網路提供了數值上有意義的泛化保證,而在這些情境中,經典的 PAC 界往往變得毫無意義(vacuous)。它們仍然是我們理解過參數化(overparameterized)模型泛化能力的最緊密理論工具。
閱讀 PAC-Bayes 界
假設我們使用 n = 50,000 個標記樣本訓練一個網路。訓練後,權重上的後驗分佈 Q 相對於高斯先驗分佈 P 的 KL(Q‖P) = 200 nats。在 Q 下的經驗風險為 0.10。設定 δ = 0.05。
過參數化與雙重下降
經典 PAC 預測的災難
經典 PAC 預測:參數多於樣本 = 災難性過擬合。在訓練資料上完美學習,在測試資料上隨機泛化。VC 界預測的是死記硬背而非學習。
現代神經網路通常擁有比訓練樣本多 10 倍至 1000 倍的參數,卻仍能泛化。根據經典理論,這不應該發生。但它就是發生了。
我們被教導的 U 型曲線
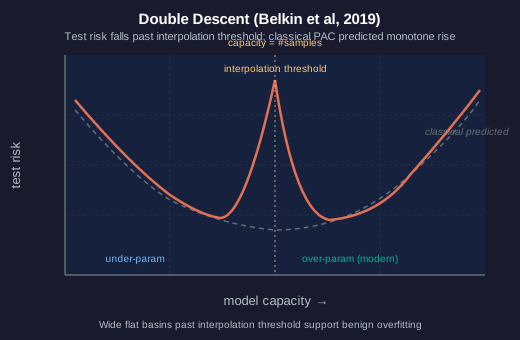
經典的偏差-方差(bias-variance):隨著模型容量增加,訓練誤差單調下降;測試誤差先下降(欠擬合減少),達到最小值後再上升(過擬合)。此 U 型曲線由 VC 理論預測。
實際發生的是什麼——雙重下降(Double Descent)
Belkin 等人(2019)指出,測試誤差在達到插值閾值(capacity = 樣本數)之前,遵循我們經典的 U 型曲線;但超過該閾值後,誤差會再次下降。極度過參數化(massively overparameterized)的模型,其泛化能力甚至優於「剛好夠大」的模型。
為何經典 PAC 理論遺漏了這一點
1. 「與分佈無關」的假設過於悲觀。 真實數據具有結構(低內在維度、流形幾何)。PAC 界(bounds)針對最壞情況的分佈成立;而真實分佈所具備的結構,也正是 SGD 所善加利用的。
2. 隱式正則化(Implicit regularization)。在過參數化(overparameterized)網路上使用隨機梯度下降(SGD),會找到最小範數或最小複雜度的內插解,而非任意解。經典理論假設的是最壞情況下的經驗風險最小化器;而實際演算法會選擇良性的解。
3. 假設類別的定義錯誤。SGD 實際探索的有效假設類別遠小於名義上的權重空間。PAC-Bayes 後驗分佈能捕捉到這一點,但 VC 維度則不能。
現代的理論研究(例如 Bartlett, Long, Lugosi, Tsigler 2020 關於良性過擬合的研究;Nakkiran et al 2020 關於雙重下降的研究)正在建立後 PAC 時代的泛化理論,以涵蓋我們的過參數化情境。
診斷經典 PAC 的失效
一個研究團隊使用 100,000 個標記樣本訓練了一個具有 10 億個參數的網路。經典 PAC 理論預測會得到空洞的界(vacuous bounds)。然而,實驗上測試準確率達到了 95%。
Kaplan、Chinchilla 與自動調整通用智慧規模
從界限到經驗縮放定律
經典 PAC 從理論上預測資料集大小,但結果往往空洞無效。經驗縮放定律從觀察中預測資料集大小,且實際有效。它們已取代 PAC,成為我們為大型模型進行規模調整的實用工具。
Kaplan 等人 (2020)
損失(Loss)遵循參數 N、資料集 token 數 D 與計算量 C 的冪律:
L(N) ≈ (Nc/N)^αN L(D) ≈ (Dc/D)^αD L(C) ≈ (Cc/C)^αC
參數翻倍會使損失下降一個固定的乘法係數。資料翻倍會使損失下降另一個固定的係數。這些指數(αN, αD, αC)可衡量並預測跨多個數量級的前沿模型行為。
Hoffmann 等人 2022(Chinchilla)
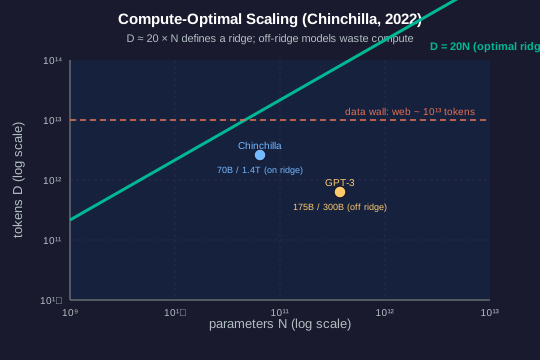
Chinchilla 證明 Kaplan 的指數過度高估了參數相對於資料的重要性。計算最佳化訓練大約需要每個參數 20 個 token:
D_opt ≈ 20 × N
GPT-3(175B 參數)使用約 300B 個 token 進行訓練——根據 Chinchilla 的計算,嚴重訓練不足。一個計算最佳化的 175B 參數模型需要約 3.5 兆個 token。
資料牆
擴展我們的參數數量需要按比例擴展我們的 token 數量。公開網路爬取可獲得約 10¹³ 個有效 token。一個假設的具有 10¹⁵ 個參數的自動化通用智能體將需要約 2×10¹⁶ 個 token——這比可用的網路數據高出三個數量級。
這就是我們的數據壁壘。 擴展定律預測,我們會在遇到計算資源短缺之前,先遇到語料庫短缺。合成數據、多模態語料庫(視頻、音頻、感測器數據流)以及來自環境的強化學習(RL-from-environment)都旨在突破這一壁壘。
經典 PAC 理論告訴我們(錯誤地)我們需要 10²¹ 個樣本。擴展定律告訴我們(基於現實校準)我們需要 2×10¹⁶ 個。這兩個數字都超過了可用的文本量。當前的前沿工作正在努力縮小這一差距。
估算自動化通用智能的語料庫規模
假設一家前沿實驗室提出了一個具有 10¹⁴ 個參數的模型,並聲稱它將達到自動化通用智能。我們希望根據 Chinchilla 法則來確定其訓練語料庫的規模。
從理論邊界到生產測量
停止計算邊界;開始測量它們
經典 PAC 邊界往往變得虛無。PAC-Bayes 邊界在難以驗證的假設下才緊密。一個務實的替代方案:在您的真實分佈上經驗性地測量 ε,並隨著系統運行而更新它。
想法 1 — 將覆蓋率視為經驗性 PAC
make coverage 目標會將 N 個保留問題輸入您的查詢系統,並測量兩項比率:
- cache_hit_rate — 您的系統找到已知答案的比例
- i_dont_know_rate — 您的系統誠實表示不知道的比例
每次測量 = 一次伯努利試驗。從觀測到的計數中,計算真實費率的威爾遜信賴區間。範例:N = 1000 個查詢,觀測到的 i_dont_know_rate = 0.20 → 95% 信賴區間 ≈ [0.177, 0.226]。上界 0.226 在 δ = 0.05 時,其功能與 PAC 中的 ε 完全相同,且是基於真實資料與真實分佈導出,而非最壞情況的理論分析。
經典 PAC 詞彙依然適用(ε, δ, 信賴度)。但機制不同(二項分佈濃縮 vs. VC 理論)。由於真實分佈具有可利用的結構,因此結果更緊密。
概念 2 — 透過反證事件進行 PAC-Bayes 審計
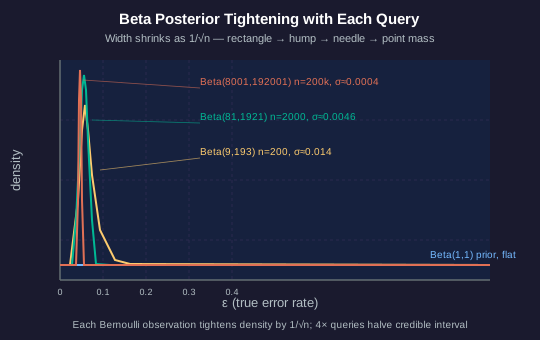
將每次反證(系統答案被證明是錯誤的)視為證據,以更新關於真實錯誤率 ε 的後驗分佈:
1. 先驗分佈: ε ~ Beta(α₀, β₀)。選擇弱先驗分佈,例如 Beta(1, 1) = 均勻分佈。
2. 每個查詢 產生一個伯努利結果:被證偽(1)或成立(0)。
3. 在 n 次查詢中出現 k 次證偽後的後驗分佈: Beta(α₀ + k, β₀ + n − k)。
4. 後驗均值: (α₀ + k) / (α₀ + β₀ + n) → 當 n → ∞ 時趨近於經驗證偽率。
5. ε 的 95% 可信區間 隨 1/√n 收緊。
這為我們帶來什麼
- 來自實際部署的真實世界 ε₀ 估計值,而非最壞情況理論
- 隨時有效的警報:當後驗可信區間跨越合約門檻時,通知相關人員
- 單調信心:觀察到的查詢越多 → 可信區間越窄 → 保證越強
近親技術:帶有線上重新校準的共形預測(Vovk)、序貫概率比檢驗(Wald)、線上 PAC-Bayes(Haddouche & Guedj 2022)。同屬一個家族,但數學機制不同。
計算關於反例的 Beta 後驗分佈
我們的團隊對一個生產環境中的查詢系統進行覆蓋率審計。關於真實錯誤率 ε 的先驗分佈為 Beta(1, 1)(均勻分佈)。在 200 個保留查詢中,我們觀察到 8 個反例。