梯度尖峰的來源
平靜的小批次與令人震驚的小批次
大多數小批次產生的梯度幅度合理。對於已大致擬合資料的模型,其交叉熵損失維持在狹窄區間內;反向傳播將此訊號傳回,形成大小相似的梯度。
某些小批次並非如此。梯度尖峰的三個來源:
1. 離群值範例。 單一序列若包含極其罕見的代元(token)組合,會產生遠偏離平均值的損失(loss)以及遠偏離平均值的梯度。
2. 數值邊界情況。 接近零的 Softmax 分母、會產生 NaN 的 LayerNorm、FP16 溢位。每一種情況都可能產生比典型值大幾個數量級的梯度。
3. 分佈偏移。 在單次訓練運行期間切換數據來源,會以新的分佈衝擊模型。ANDREA 的賭徒(bandit)每 7 到 42 步重新洗牌來源權重。每次切換都是一次小的分佈偏移。
ANDREA-120M v1:尖峰級聯
v1 沒有梯度裁剪。賭徒每 7 到 42 步進行一次來源轉換,向模型輸入短暫的 repo-docs(列表結構化)、接著是 gutenberg(長篇散文)、然後是 hermes3-general(問答)的爆發。每次轉換都產生梯度尖峰:在 120M 規模下,每個尖峰都將權重推向退化吸引子(degenerate attractors)。
關鍵經驗事實。 ANDREA-12M 在面對相同的梯度尖峰時,即使未進行裁剪(clipping)也安然無恙。較小的權重矩陣對梯度衝擊具有較強的韌性;單一不良批次(bad batch)無法像推高 120M 參數模型那樣,將 12M 參數模型推入失控的吸引子(runaway attractor)。隨著模型規模擴大,裁剪的重要性也隨之增加。
全域 L2 範數裁剪
兩種選擇:逐張量或全域
限制梯度幅度的兩種方式:
逐張量裁剪(Per-tensor clipping)。 獨立裁剪每個梯度張量。嵌入層(Embedding)的梯度被裁剪至其自身的範數;注意力層(Attention)的梯度則被裁剪至其自身的範數。此方法簡單,但會扭曲相對尺度:某個張量中的小尖峰(現在梯度為零)會與另一個張量中巨大的梯度(未受影響)配對。
全域 L2 範數裁剪(Global L2 norm clipping)。 將所有梯度視為一個大向量。計算所有參數的總 L2 範數。如果範數超過 max_norm,則以相同係數縮放所有梯度。此方法保留了各張量之間的相對幅度。
ANDREA 使用全域(global)剪枝。Pascanu 等人(2013)透過實證研究證明,在 Transformer 訓練中,全域剪枝的效果優於逐張量(per-tensor)剪枝。
數學原理
計算全域 L2 範數:
norm = sqrt(sum over all params of g_i^2)
若 norm <= max_norm,梯度將原封不動地通過。若 norm > max_norm,則將每個梯度縮放 max_norm / norm 倍:
g_i_clipped = g_i * (max_norm / norm)
縮放後,新的範數將精確等於 max_norm。ANDREA 使用 max_norm = 1.0。
計算縮放係數
為何梯度範數計算需要三個核心
簡易演算法無法在 GPU 上執行
全域 L2 範數計算的偽代碼:
total = 0
for each param p:
for each element g in p.grad:
total += g * g
norm = sqrt(total)
在 GPU 上,這種簡單迴圈因兩個原因而失敗:
1. 順序累加(Sequential accumulation)。 單一的 total 累加器迫使每個執行緒(thread)等待其他所有執行緒,這破壞了 GPU 的並行性。
2. 異質張量(Heterogeneous tensors)。 ANDREA-120M 包含形狀差異極大的張量:嵌入層(8449 x 768)、注意力 QKV(768 x 768)、層正規化(768)。單一核心(kernel)無法高效地迭代處理所有這些形狀。
ANDREA 的三核心管線
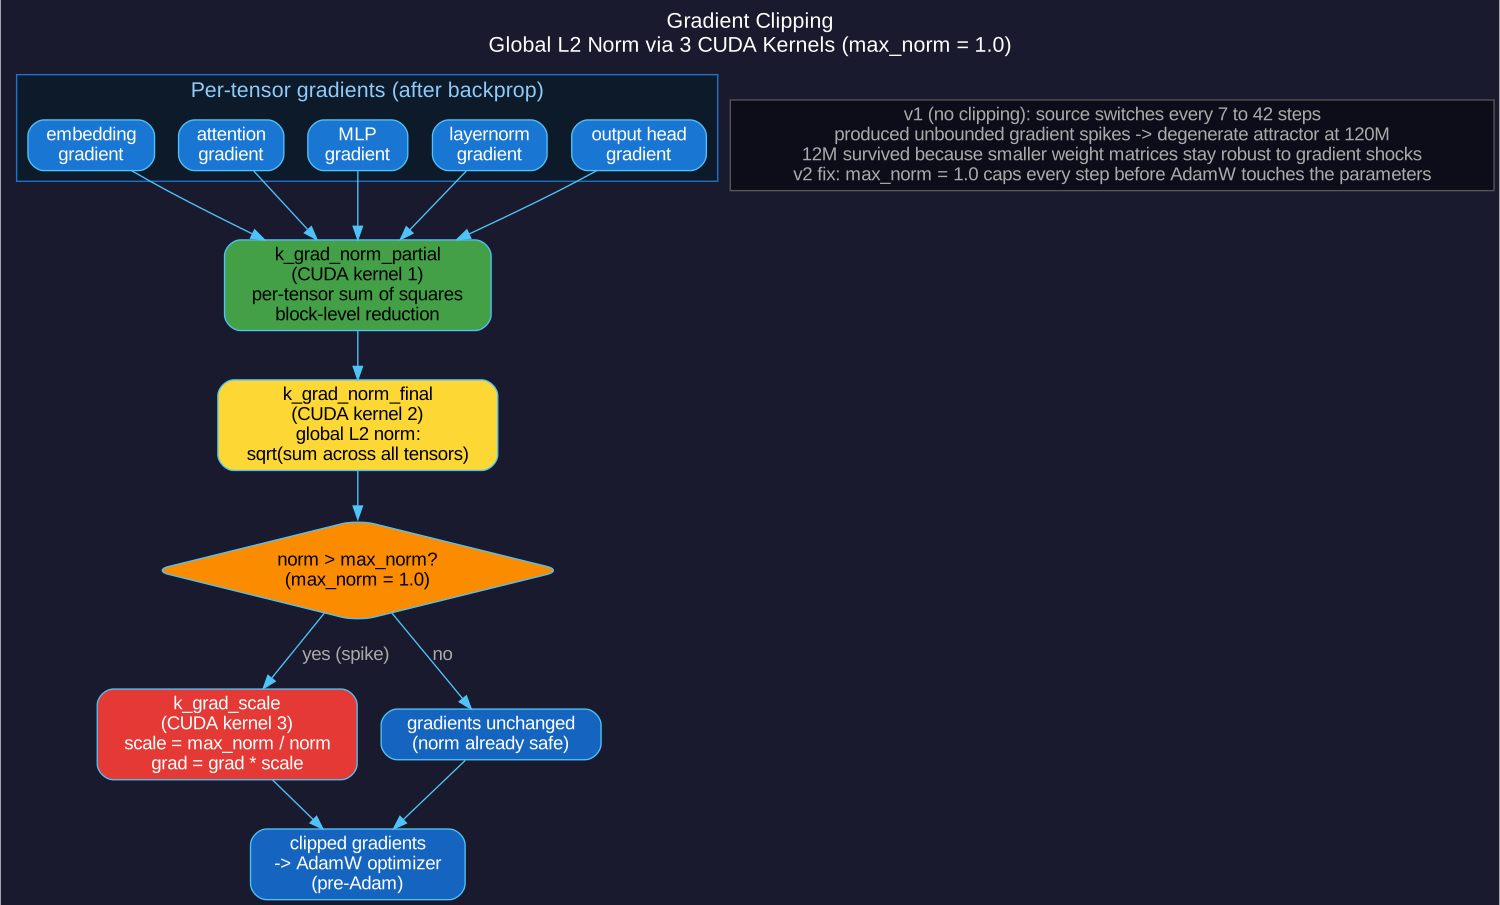
將工作拆分到 microgpt_cuda.cu 中的三個 CUDA 核心:
核心 1:k_grad_norm_partial。 針對每個參數張量,計算平方和的部分總和。每個執行緒區塊(thread block)對張量的一個區塊進行歸約(reduction);結果寫入一個小型暫存緩衝區。並行性:每個區塊對應一個區塊(chunk),跨所有張量共有數百個區塊。
Kernel 2:k_grad_norm_final。 將暫存緩衝區(scratch buffer)歸約為單一標量。取其平方根。這是一個小型 kernel,執行時間僅為微秒級別。
Kernel 3:k_grad_scale。 若 norm > max_norm,計算 scale = max_norm / norm,並將每個梯度元素乘以 scale。對所有梯度張量進行一次遍歷,具有極高的並行性(embarrassingly parallel)。
順序至關重要:Adam 之前
裁剪(clipping)管線在 AdamW 更新 m、v 或任何參數之前執行。為什麼?
裁剪後的梯度會輸入 AdamW 的指數移動平均。如果允許尖峰直接流入 m 與 v,將污染這些運行中的平均值,並導致尖峰發生後的多個步驟內恢復速度變慢。在 Adam 之前進行裁剪,可將尖峰的影響限制在該單一錯誤步驟內。
為什麼需要三個核心,而不是一個?
無裁剪(No-Clipping)如何導致 v1 崩潰
Bandit 來源每 7 至 42 步轉換一次
ANDREA 的 Bandit 機制以階段方式運作。每個階段持續 7、14、21、28 或 42 步(隨機選擇)。在每個階段邊界,來源權重會發生偏移:例如 repo-docs 可能從 0.1 跳升至 0.6,gutenberg 從 0.4 降至 0.1,而 hermes3-general 則從 0.5 升至 0.7。
每次轉換對模型而言都是一次分佈衝擊。損失函數(Loss)會短暫飆升。梯度(Gradients)也會隨之飆升:一個原本針對 gutenberg 風格散文進行損失最小化的模型,現在卻看到了 repo-docs 風格的列表結構,& 梯度承載的修正信號可能達到典型幅度的 10 倍甚至 100 倍。
v1 失敗模式
在沒有梯度裁剪的情況下,那些 10-100 倍的梯度尖峰會流入 AdamW 的 m 與 v 平均數中。由於 AdamW 的平滑機制,尖峰的影響會在實際的壞批次(bad batch)出現後持續許多步。再加上沒有權重衰減(v1 版本使用原生 Adam),由尖峰驅動的權重更新在各階段中不斷累積,最終導致權重漂移至退化吸引子(degenerate attractor):某個 token 的 logit 在 softmax 中佔據主導,採樣輸出即為該 token,訓練上下文包含該 token,梯度進一步強化該 token。這形成了重複鎖定(Repetition lock-in)。
v2 穩定性
v2 版本加入了 max_norm = 1.0 的梯度裁剪,並配合 AdamW 與學習率熱身(LR warmup)。尖峰對 m 與 v 的影響被限制在邊界內;在峰值時,權重每個參數每步的漂移速度不會超過 lr max_norm = 0.0003 1.0 = 0.0003。雖然階段轉換(phase transitions)仍會產生尖峰,但這些尖峰在到達優化器之前已被截斷。
結果:v2 版本(在經過數據過濾 v2.5 與 v3 精修後)達到了事實回憶能力、多段落連貫性,以及在生物學與訊號處理樣本上獲得 9.5/10 的外部評分。
容量與脆弱性的耦合
相同的帶通。相同的資料。相同的超參數,除了裁剪(clipping)。為什麼 12M 在沒有裁剪的情況下存活下來,而 120M 卻崩潰了?
兩個相互加劇的因素:
1. 更大的權重矩陣儲存了更多的吸引子(attractors)。 一個 768x768 的注意力投影(attention projection)擁有 59 萬個參數;即使每個參數的微小漂移也會對注意力行為產生顯著的變化。一個 384x384 的注意力投影擁有 14.7 萬個參數,且保持在一個更受限的子空間中。
2. 更多的層意味著更多的乘法交互作用。 v3 有 12 個 Transformer 層(而 12M 只有 6 個)。尖峰(spikes)透過 12 層相互加劇的非線性傳播;每一層都可能放大前一層的漂移。
脆弱性隨容量增加而加劇。當規模超過某個閾值時,裁剪(clipping)變得強制必要;ANDREA 將該閾值設定在 12M 與 120M 參數之間。
診斷 v1 級聯
截斷還應用於哪裡?
相鄰活動
有三個相鄰活動與裁剪相關:
- 活動 10:AdamW。 裁剪保護 AdamW 的 m 與 v 免受尖峰污染。若無裁剪,一個糟糕的批次會使優化器狀態在 50 步以上持續受到污染。
- 活動 11:學習率熱身(LR warmup)。 熱身機制衰減 lr;裁剪衰減 g。兩者結合:在第 1 步,最壞情況下的參數更新量為 lr_after_warmup max_norm = 1.5e-7 1.0 = 1.5e-7,而若無任何保護機制,則為 0.0003 * 50 = 0.015。這使早期最壞情況下的更新幅度減少了 100,000 倍。
- 活動 14:多臂老虎機(Multi-armed bandits)。 老虎機階段的長度(7 到 42 步)之所以設定得如此短,是為了防止任何單一資料來源佔據主導地位;正是「截斷」(clipping)機制使得這些頻繁的轉換變得安全。
截斷(Clipping)是 Transformer 訓練中成本最低的穩定性提升手段:僅需 3 個小型 CUDA 核心,每步僅耗用微秒級時間,卻對 1.2 億參數以上的模型能否收斂或崩潰具有決定性影響。