什麼是資料科學?
資料科學不只是機器學習。它不只是統計學。它也不只是程式設計。
資料科學是從資料中萃取有用知識的學科。其中大部分工作並不光鮮亮麗:而是清理凌亂的試算表、提出正確的問題,以及向不關心你程式碼的人溝通結果。
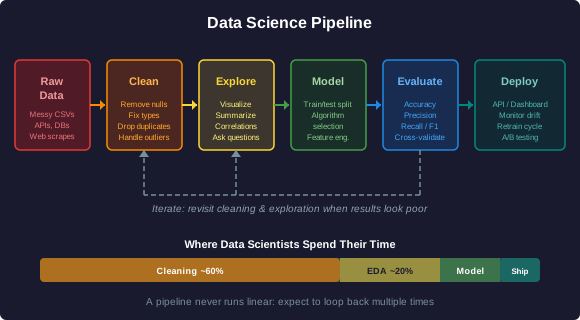
典型的資料科學管線如下所示:
1. 收集:從資料庫、API、CSV 檔案或網頁爬蟲中獲取原始資料
2. 清洗:處理缺失值、修正資料型別、移除重複項目
3. 探索:視覺化資料分佈、發現模式、提出問題
4. 特徵工程:建立有助於模型學習的新特徵
5. 建模:訓練演算法、評估效能、進行迭代
6. 溝通:向做出決策的利害關係人呈現分析結果
如果您曾經使用過 Excel 的樞紐分析表、條件格式或 VLOOKUP 函數,那麼您實際上已經完成了第 1 至 3 步。本課程將把這些經驗銜接到產業中常用的基於 Python 的工作流程。
暖身活動
您的數據經驗
每個人都曾以某種形式處理過數據:預算試算表、成績追蹤表、健身應用程式,甚至是帶有播放次數的播放清單。
垃圾進,垃圾出
為何資料清理至關重要
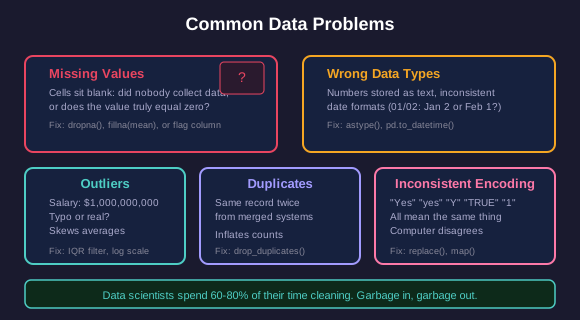
資料科學家花費 60-80% 的時間在清理資料上。這並非誇大:這是業界調查中一致的發現。
原因很簡單:垃圾進,垃圾出。如果您的資料存在錯誤、遺失值或格式不一致,基於其上的任何分析都將是錯誤的。一個完美的模型若使用髒資料進行訓練,將產出自信但錯誤的答案。
常見資料問題
- 遺失值:儲存格為空白。是資料未被收集,還是該值實際為零?這些是不同的情況,需要不同的處理方式。
- 錯誤的資料型別:數字欄位以文字儲存,日期格式不一致(01/02/2024:那是 1 月 2 日還是 2 月 1 日?)
- 離群值:薪資欄位中有一個 $1,000,000,000 的條目。這是真實的,還是打字錯誤?無論如何,它都會使您的平均值產生偏差。
- 重複項目:同一筆記錄出現兩次,因為兩個系統合併時未完美處理
- 類別編碼:某欄位同時出現 'Yes'、'yes'、'Y'、'TRUE' 和 '1'。這些都代表相同的意思,但你的電腦並不知道這一點。
在 pandas(標準的 Python 資料庫)中,你可以使用 dropna()、fillna()、astype() 和 drop_duplicates() 等方法來處理這些問題。但困難之處不在於程式碼,而在於決定對每個問題該做什麼。
清理決策
決定該做什麼
這是一個真實情境。你擁有一個包含 10,000 筆客戶記錄的資料集。其中 'age'(年齡)欄位有 500 個缺失值。
您的選項:
- 刪除這些行:移除全部 500 筆記錄。簡單直接,但您將失去 5% 的資料。如果這 500 位客戶具有某種共同特徵(例如,他們因為重視隱私而跳過了年齡欄位),刪除這些記錄會引入偏差。
- 以平均值填充:用平均年齡取代空白值。快速,但這會人為地降低年齡欄位的變異數。
- 以中位數填充:如果年齡分佈偏斜(例如,少數極年長或極年幼的客戶拉高了平均值),這比使用平均值更好。
- 使用旗標:建立一個名為 'age_missing' 的新欄位(值為 1 或 0),並用中位數填充原始欄位。這樣您的模型就能學習到「缺失」本身是否具有資訊量。
沒有放諸四海皆準的正確答案。選擇取決於資料缺失的原因,以及您打算如何使用這些資料。
提出正確的問題
探索性資料分析 (EDA)
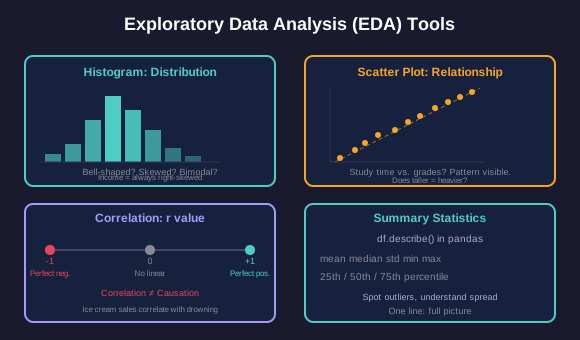
在建立任何模型之前,你需要理解你的資料。EDA 是透過摘要、視覺化與提問來探索資料集,以發現模式、異常值與關係的過程。
關鍵工具
- 直方圖:顯示單一變數的分布。它是鐘形(對稱)?偏斜?還是雙峰(兩個峰值)?收入的分佈直方圖總是右偏的,因為少數人的收入遠高於大多數人。
- 散佈圖:顯示兩個變數之間的關係。較高的人是否體重較重?較多的學習時間是否與較高的成績相關?圖中的模式(或缺乏模式)告訴你是否存在某種關係。
- 相關性:一個介於 -1 和 +1 之間的數值,用於衡量線性關聯。+1 表示完美的正相關,-1 表示完美的負相關,0 表示沒有線性關係。但相關性不等於因果關係:冰淇淋銷量與溺水死亡人數呈正相關,因為這兩者在夏季都會增加。
- 摘要統計量:平均值、中位數、標準差、最小值、最大值。在 pandas 中:df.describe() 可以一行程式碼給出所有這些統計量。
真正的技能
這些工具很容易學習。困難的部分在於提出正確的問題。錯誤的問題:「數據說明了什麼?」正確的問題:「在頭一週內聯繫客戶支援的客戶,其留存率是否更高?」
相關性陷阱
相關性與因果關係
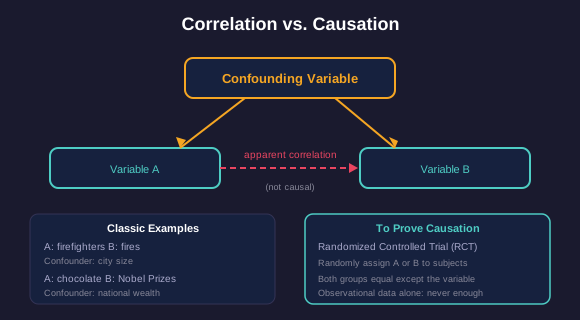
這是數據素養中最重要的單一概念。兩個變數可能高度相關,但其中一個並不導致另一個。
經典範例:
- 消防員較多的城市,火災也較多。(因為大城市同時擁有這兩者。)
- 吃早餐的學生成績更好。(也許較富裕的家庭更有可能提供早餐,同時也提供學術支援。)
- 消費巧克力的國家,獲得諾貝爾獎的次數也較多。(兩者都與國家財富相關。)
這個隱藏因素被稱為混淆變數(confounding variable):一個同時驅動你所觀察的兩個變數的第三個變數。
建立有用的變數
什麼是特徵工程?
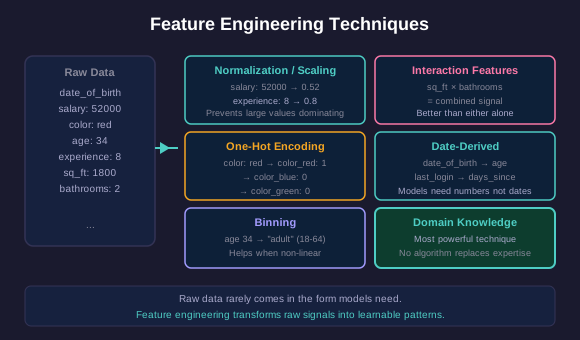
特徵(Feature)是模型用來進行預測的輸入變數。特徵工程是從原始資料中建立新特徵的藝術,以幫助模型學習否則無法察覺的模式。
原始資料很少以模型所需的格式呈現。考慮一個包含「出生日期」欄位的資料集。模型無法對原始日期做太多處理。但如果你從中建立一個「年齡」特徵,模型突然就能學習基於年齡的模式了。
常見技術
- 正規化(Normalization):將數值縮放至共同範圍(例如 0 到 1,或均值為 0 且標準差為 1)。若未執行此步驟,以千為單位的特徵(如薪資)將壓倒以個位數為單位的特徵(如年資)。
- 獨熱編碼(One-hot encoding):將分類變數轉換為二進位欄位。例如,包含 [紅、藍、綠] 值的「顏色」欄位會變成三個欄位:「color_red」、「color_blue」、「color_green」,每個欄位的值為 0 或 1。
- 分箱(Binning):將連續變數轉換為類別。例如,0-17 歲變為「未成年人」,18-64 歲變為「成年人」,65 歲以上變為「老年人」。當變數間關係非線性時,此方法特別有用。
- 交互特徵(Interaction features):將兩個特徵相乘。「建築面積乘以浴室數量」可能比單獨使用任一特徵更能準確預測房價。
- 領域知識(Domain knowledge):最強大的技術。建立醫療模型的醫生知道哪些實驗室檢測值重要;行銷人員知道「距上次購買的天數」比「購買日期」更有用。任何演算法都無法取代這種專業知識。
特徵練習
應用特徵工程
想像一下,你正在構建一個模型,以預測哪些客戶會在下個月取消他們的串流媒體訂閱。你的原始資料包括:
- 帳戶建立日期
- 最後登入日期
- 上個月觀看節目數量
- 每月付款金額
- 提交的客戶支援工單數量
- 國家
訓練/測試分割
為什麼要分割你的資料
建模中最重要的規則:絕不能在同一份用於訓練的資料上評估模型。
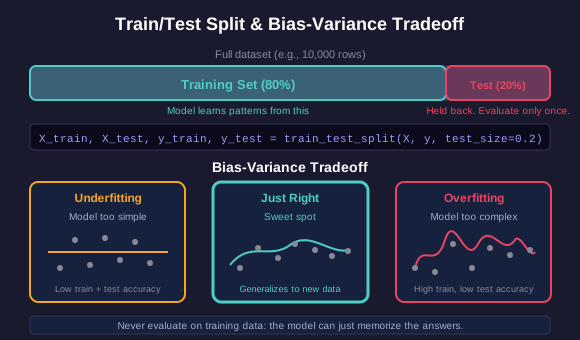
如果這麼做,模型只需記住答案即可。它在訓練資料上會獲得完美分數,但在新的、未見過的資料上會失敗。這被稱為過擬合:模型學習的是特定資料集中的雜訊,而非真正的模式。
標準做法是將資料分割:
- 訓練集(通常佔 70-80%):模型從中學習
- 測試集(通常佔 20-30%):保留下來,僅用於評估最終模型
在 scikit-learn 中:X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2)
常見演算法
- 線性回歸:繪製穿過數據的最佳擬合直線。簡單、可解釋,適用於關係大致呈線性的情況。預測數值(價格、溫度、分數)。
- 決策樹:由是/否問題組成的流程圖。容易理解與解釋。若未進行修剪或限制深度,容易過度擬合。
- 隨機森林:許多決策樹共同投票。比單棵樹更準確,較不易過度擬合,但較難解釋。
過度擬合與欠擬合
- 過度擬合:模型過於複雜。它記住了訓練數據,包括噪聲。在訓練數據上準確率高,在測試數據上準確率低。
- 欠擬合:模型過於簡單。它無法捕捉真實的規律。在訓練數據和測試數據上的準確率都低。
目標是找到兩者之間的最佳平衡點。
評估指標
如何判斷模型是否良好?
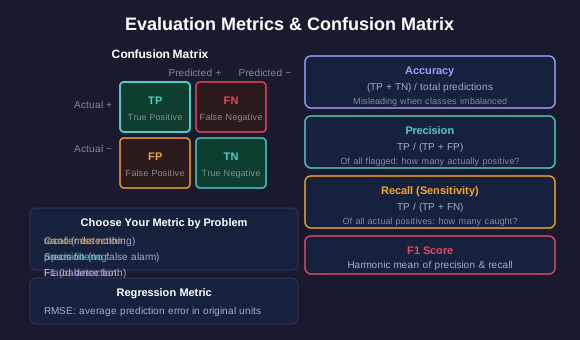
僅憑準確率可能會產生誤導。如果 95% 的電子郵件不是垃圾郵件,那麼一個總是判定為「非垃圾郵件」的模型準確率可達 95%:但完全沒有實用價值。
關鍵指標:
- 準確率 (Accuracy):預測正確的百分比。在類別平衡時很有用。
- 精確率 (Precision):在模型標記為陽性的所有項目中,實際為陽性的比例是多少?高精確率意味著誤報較少。
- 召回率 (Recall):在所有實際的陽性案例中,模型捕捉到了多少?高召回率意味著遺漏的案例較少。
- F1 分數:精確率(Precision)與召回率(Recall)的調和平均數。當您需要同時平衡兩者時,此指標非常有用。
- RMSE(均方根誤差):用於回歸問題(預測數值)。它衡量預測值平均偏離實際值多少。
哪項指標最重要取決於具體問題。對於癌症檢測,召回率(Recall)更為重要:您不希望遺漏任何病例。對於垃圾郵件過濾,精確率(Precision)更為重要:您不希望誤刪真正的郵件。
資料分析師 vs. 資料科學家 vs. 機器學習工程師
三個不同的角色
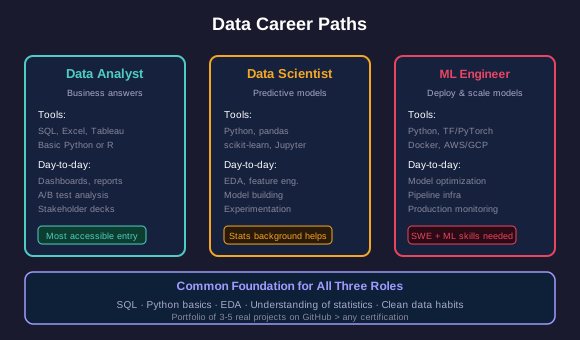
資料領域有三個主要的職業軌道,且它們需要不同的技能。
資料分析師
- 重點:利用現有數據回答商業問題
- 工具:SQL、Excel、Tableau、基礎 Python 或 R
- 日常工作:儀表板、報告、A/B 測試分析、利害關係人簡報
- 入門途徑:通常最容易進入。許多分析師在沒有電腦科學學位的情況下也能從業。
資料科學家
- 重點:建立預測模型並在複雜數據中發現模式
- 工具:Python (pandas, scikit-learn, matplotlib)、統計學、SQL、Jupyter 筆記本
- 日常工作:探索性資料分析(EDA)、特徵工程、模型建置、實驗
- 入門途徑:通常需要統計或量化背景。參加訓練營與自學也是可行的選擇。
機器學習工程師
- 重點:在生產系統中部署與擴展模型
- 工具:Python、TensorFlow/PyTorch、Docker、雲端平台(AWS/GCP)、API
- 日常工作:模型最佳化、管線基礎設施、監控生產環境中的模型
- 入門途徑:通常需要強勁的軟體工程技能加上機器學習知識。
建立作品集
招聘經理更在意你能做什麼,而不僅僅是你學過什麼。在 GitHub 上展示 3 到 5 個紮實項目的作品集,比任何認證都更有價值。優秀的項目應使用真實(而非玩具級)數據集,包含清晰的文檔,並展示完整的流程:從混亂的數據到可執行的洞察。
你的下一步
接下來該往哪走
這些專業工具都是免費且易於獲得的:
- pandas:用於數據操作的標準 Python 庫
- matplotlib / seaborn:可視化函式庫
- scikit-learn:傳統機器學習的主力工具
- Jupyter notebooks:互動式編碼環境,可混合程式碼、輸出結果與筆記
- Kaggle:免費資料集、競賽以及實務工作者社群
從一個你感興趣的真實資料集開始。下載它、清理它、探索它,並嘗試回答一個問題。這個單一專案將教會你比任何課程都多的東西。