Dwa problemy na obu końcach treningu
Problem na wczesnych krokach: Świeże wagi nie mogą wykonywać dużych kroków
Na kroku 0 każda waga zaczyna jako mała liczba losowa pobrana z rozkładu zbliżonego do zera. Aktywacje pozostają w pobliżu zera. Gradienty niosą bardzo mało informacji o ostatecznym rozwiązaniu. Zastosowanie szczytowej stopy uczenia do tych gradientów powoduje, że model oddala się daleko od inicjalizacji w kierunkach, które nie kodują znaczącej struktury.
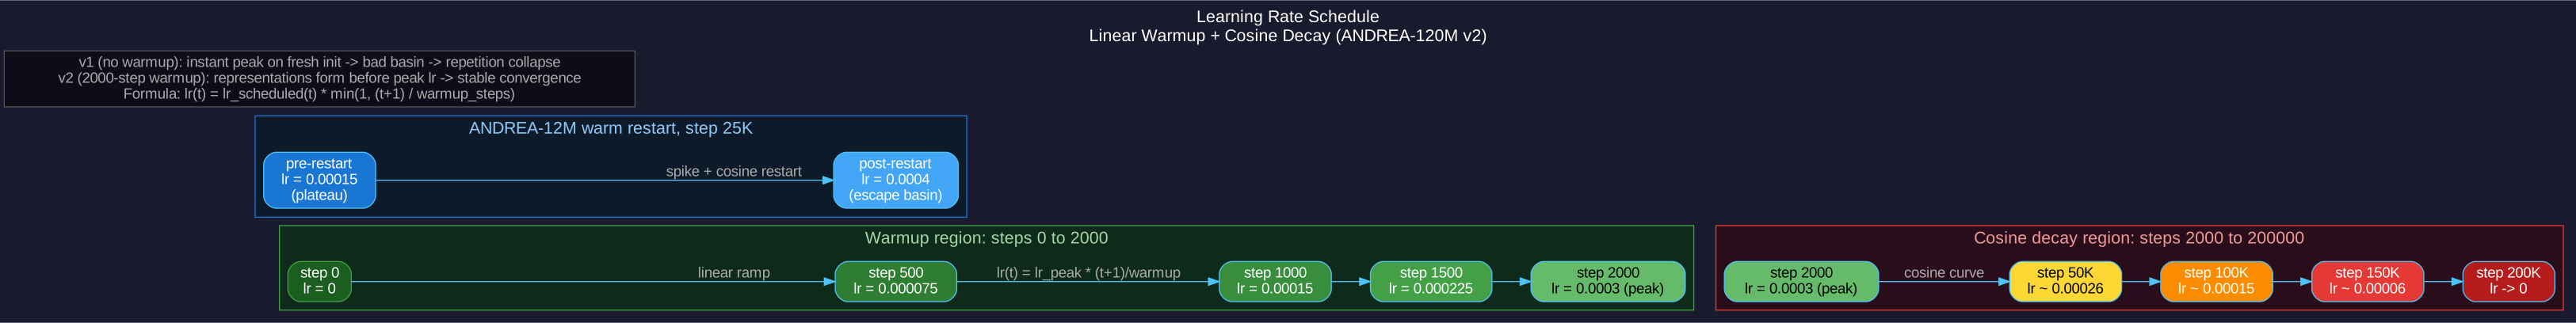
ANDREA-120M v1 popełnił ten błąd. Brakowało rozgrzewki (warmup). Na kroku 1 użyto lr = 0.0003 na świeżo zainicjowanych wagach. Wynik: model trafił do złego basenu parametrów w ciągu kilku setek kroków. Wartości straty wyglądały rozsądnie; próbki generowały pętle powtórzeń do kroku 80K i nigdy się z tego nie wydobrzały.
Problem na późnym etapie: Duże kroki nie mogą dopracować rozwiązania
Na kroku 100 tys. model poznał już strukturę ogólną. Gradienty przenoszą teraz sygnał o wysokiej rozdzielczości: które wagi tokenów wymagają małej korekty, która głowa uwagi potrzebuje lekkiego wyważenia. Stosowanie szczytowej stopy uczenia na tym etapie powoduje przekroczenie każdego drobnego dostosowania, oscylując wokół optimum bez ustabilizowania się.
Dwa problemy, na przeciwnych końcach treningu. Jeden harmonogram, dwa obszary: łagodne zwiększanie, gładkie zmniejszanie.
Liniowe rozgrzewanie: pierwsze 2000 kroków
Wzór
ANDREA-120M v2 wykorzystuje liniowe rozgrzewanie przez 2000 kroków:
lr(t) = lr_scheduled(t) * min(1, (t + 1) / warmup_steps)
gdzie t to numer kroku (indeksowany od 0), warmup_steps = 2000, a lr_scheduled(t) to wartość, którą narzucałby harmonogram cosinusowy, gdyby ignorować fazę rozgrzewki.
Interpretacja wzoru:
- Dla t = 0: lr = lr_scheduled(0) min(1, 1/2000) = lr_scheduled(0) 0.0005. Bardzo mały pierwszy krok.
- Przy t = 1000: lr = lr_scheduled(1000) min(1, 1001/2000) = lr_scheduled(1000) 0.5. Połowa mocy.
- Przy t = 2000: lr = lr_scheduled(2000) min(1, 2001/2000) = lr_scheduled(2000) 1.0. Pełna moc.
- Przy t > 2000: ograniczenie (clamp) utrzymuje mnożnik na poziomie 1, rozgrzewka nie ma już żadnego wpływu, a spadek cosinusoidalny przejmuje stery samodzielnie.
Liniowy wzrost od zera daje modelowi 2000 kroków na wykształcenie wstępnych reprezentacji, zanim AdamW i przycinanie gradientów zobaczą aktualizacje o pełnej sile. Do kroku 2000 wagi zdążą się wystarczająco zmienić, aby szczytowa wartość lr nie pchała ich już do złego dołku (basin).
Obliczanie LR podczas rozgrzewki
Spadek kosinusowy po fazie rozgrzewki
Krzywa
Po zakończeniu fazy rozgrzewki na kroku 2000, stopień uczenia się podąża za krzywą kosinusową od wartości szczytowej do zera w ciągu pozostałych kroków:
lr(t) = lr_min + (lr_peak - lr_min) 0.5 (1 + cos(pi * progress))
gdzie progress = (t - warmup_steps) / (total_steps - warmup_steps). Przy progress = 0 (tuż po fazie rozgrzewki), cos(0) = 1, lr = szczytowa wartość. Przy progress = 1 (ostatni krok), cos(pi) = -1, lr = lr_min (zwykle 0 lub bardzo mała wartość dolna).
Dlaczego cosinus, a nie liniowy ani wykładniczy?
Spadek cosinusoidalny zaczyna się powoli (krzywa jest niemal płaska w pobliżu szczytu), przyspiesza w środkowej części, a następnie spowalnia w pobliżu zera. Trzy korzyści:
1. Płaski odcinek w pobliżu szczytu. Wczesne kroki po fazie rozgrzewki otrzymują niemal pełną wartość lr, co pozwala modelowi wykorzystać długi odcinek wysokiego współczynnika uczenia do budowania reprezentacji.
2. Płynne przejście przez część środkową. Brak nagłych skoków, które musiałby być absorbowane przez AdamW.
3. Płaskowyż w okolicach zera. Ostatnie kroki otrzymują bardzo małe lr do precyzyjnego wygładzania, co jest analogiczne do symulowanego wyżu.
ANDREA-120M trenuje przez 200K kroków łącznie; 198K z nich to region zaniku cosinusowego po 2000-krokowym rozgrzewaniu.
Wznowienie z ciepła (Warm Restart) modelu ANDREA-12M na kroku 25K
Płaskowyż
ANDREA-12M trenowało przez 60K kroków z zanikiem cosinusowym od szczytowego lr = 0.0004. W okolicach kroku 22K strata osiągnęła płaskowyż na poziomie EMA ~2.4. Zanik cosinusowy obniżył lr do ~0.00015. Bandit nadal dostarczał zróżnicowane dane, ale model przestał się poprawiać.
Diagnoza: lr (współczynnik uczenia) uległ zbyt silnemu zanikowi, aby model mógł wydostać się ze swojego bieżącego basenu. Dane Hermes miały wkrótce wejść do programu nauczania (krok 25K), dostarczając 590 tys. nowych rozmów. Model potrzebował energii, aby wchłonąć ten wstrząs danych.
Restart
Na kroku 25K harmonogram wykonał ciepły restart: lr został zwiększony z 0,00015 (po zaniku) z powrotem do 0,0004 (pierwotny szczyt), a następnie wznowiono zanik kosinusowy na pozostałych krokach.
Loshchilov i Hutter (2017) nazwali tę technikę „SGDR” (stochastic gradient descent with warm restarts – stochastyczne obliczanie gradientu z ciepłymi restartami). Intuicja jest następująca: wysoki lr dodaje wystarczającą energię kinetyczną, aby wydostać się z lokalnego basenu i eksplorować sąsiednie; kolejny zanik kosinusowy ponownie „odpuszcza” model do lepszego basenu.
Wynik. Po wznowieniu treningu, strata EMA spadła z 2,40 do 2,10 w ciągu kolejnych 10 tys. kroków. Model został dostarczony na kroku 43,6 tys. ze stratą SMMA wynoszącą 2,0, co wykazało spójną strukturę kolejności pytań i odpowiedzi.
ANDREA-120M v2 zdecydował się NIE korzystać z wznawiania treningu (warm restarts): przy dyspozycji 200 tys. kroków oraz znacznie większej liczbie parametrów, gładki, monotoniczny spadek zapewniał stabilniejszą konwergencję. Wznawianie treningu działa najlepiej, gdy trening jest krótki, a plateau (poziomowanie) zbiega się z znaną zmianą w danych.
Diagnoza awarii wersji v1
Wybory harmonogramu w praktyce
Działania Pokrewne
Trzy elementy pokrewne łączą się z harmonogramem LR:
- Aktywność 10: AdamW. Rozgrzewka (warmup) daje korekcie biasu w AdamW czas na stabilizację. Bez rozgrzewki 10-krotne wzmocnienie na kroku 1 mnoży szum, który niosą gradienty; z rozgrzewką mnożnik dotyka rzeczywistego sygnału.
- Aktywność 12: Przycinanie gradientów (Gradient clipping). Przycinanie ogranicza normę L2 gradientu do 1.0 PRZED AdamW. Rozgrzewka tłumi lr; przycinanie tłumi g. Razem zapewniają bezpieczeństwo wczesnych kroków, nawet na curriculum podatnych na wstrząsy.
- Aktywność 22: Punkt kontrolny (Checkpointing). Restart z rozgrzewką wymaga wczytania stanu optymalizatora (m, v, licznik kroków) z punktu kontrolnego, a następnie modyfikacji harmonogramu w trakcie uruchomienia. Restart ANDREA-12M na kroku 25K to demonstruje; wymagało to dwóch prób, aby poprawnie zaimplementować logikę wczytywania stanu.
Harmonogram, optymalizator i przycinanie tworzą trójkąt stabilności. Usunięcie jednego wierzchołka spowoduje, że ANDREA powtórzy swój zawód z wersji v1.