Dlaczego istnieją dolne granice
Zła seria wynagrodzeń może głodować priorytetowe źródło
Bandyt ANDREA wybiera ramiona skupienia według rankingu UCB1. Ranking UCB zależy od mean_reward(k), który zależy od zaobserwowanych popraw w stracie. Seria dokumentów o wysokiej stracie z priorytetowego źródła (np. dictionary) może obniżyć mean_reward(k). Teraz dictionary ma niski ranking, otrzymuje mało pobrań skupienia, a jego mean_reward(k) nie może się odbudować (brak pobrań = brak nowych obserwacji).
To samo ryzyko dotyczy każdego źródła, które projektant treningu ANDREA chce mieć w mieszance, niezależnie od krótkoterminowego sygnału wynagrodzenia.
Podłogi jako minimalne wagi
Konfiguracja treningowa ANDREA określa podłogę (floor) dla każdego źródła: minimalną wagę próbkowania, którą źródło otrzymuje niezależnie od wyjścia UCB. Podłogi przyjmują wartości od 0.0 do 1.0. Przykłady:
hermes3-general floor = 0.8 (priorytetowe źródło konwersacyjne)
chat floor = 0.8
dictionary floor = 0.7 (rusztowanie do przywoływania faktów)
gutenberg floor = 0.7 (spójność prozy)
synthetic-chat floor = 0.0 (brak podłogi; bandyta decyduje swobodnie)
Jak działają podłogi
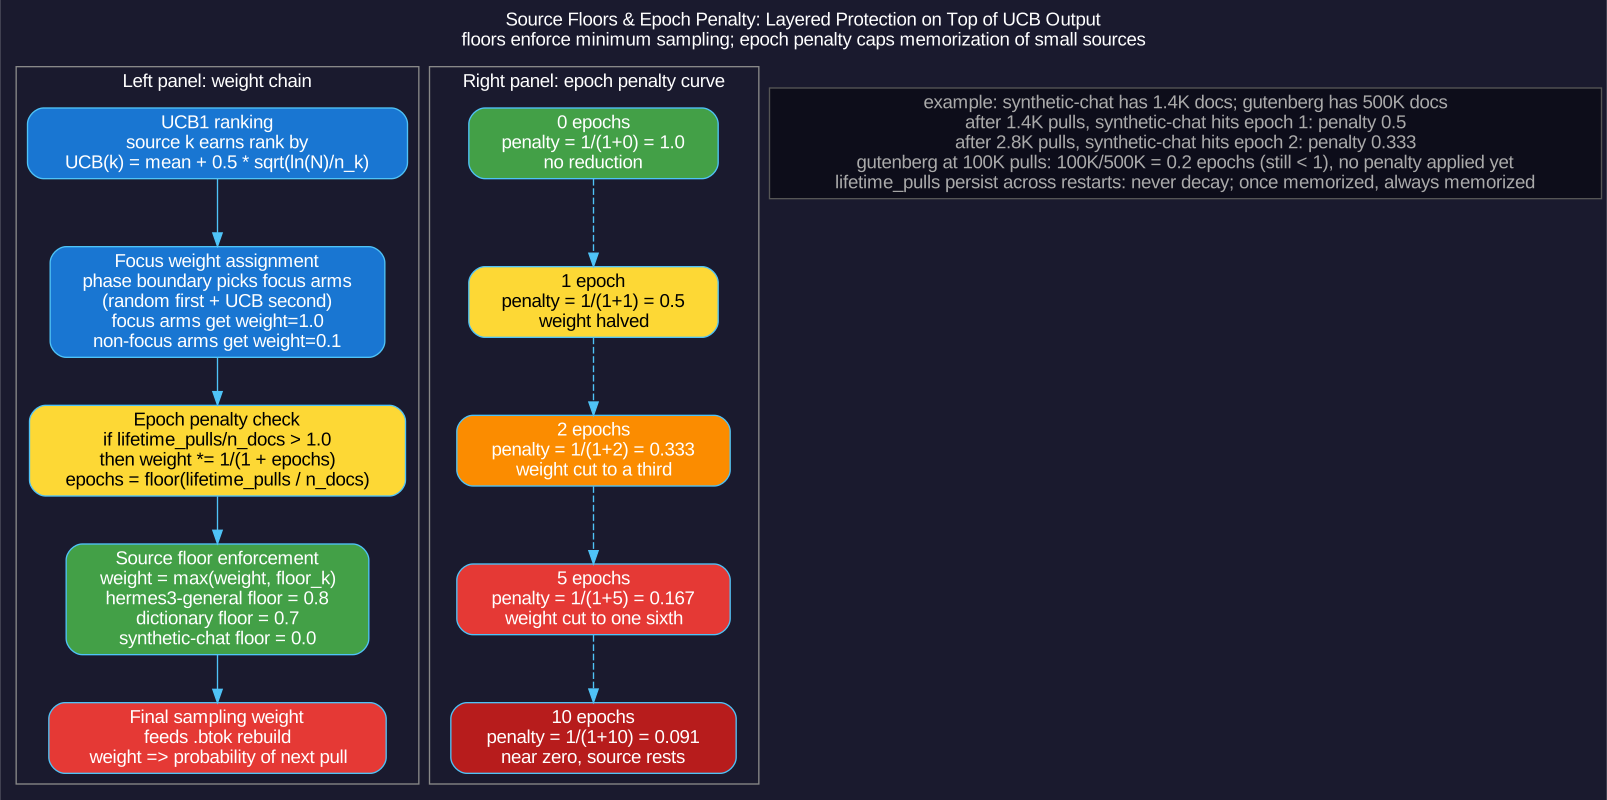
Po tym, jak UCB1 uszereguje ramiona, a kontrola kości (dice control) skomponuje zestawy skupienia, każda źródłowa metoda otrzymuje wstępny ciężar. Następnie uruchamiane jest egzekwowanie podłóg:
final_weight_k = max(tentative_weight_k, floor_k)
Jeśli bandyta przypisał ciężar 0.3 do hermes3-general, ale jego podłoga wynosi 0.8, to podłoga wygrywa: końcowy ciężar = 0.8. Głos bandyty może zostać nadpisany tylko w górę; nigdy nie jest nadpisywany w dół.
Różne konfiguracje, różne dolne granice
ANDREA dostarcza kilka konfiguracji treningowych: chatbot, tool-caller, bash-commander. Każda konfiguracja ustawia inne dolne granice (floors) dla swoich priorytetowych źródeł. Konfiguracja chatbot ustawia wysokie dolne granice dla hermes3-general i chat. Konfiguracja tool-caller ustawia wyższe dolne granice dla repo-docstrings. Konfiguracja bash-commander ustawia wyższe dolne granice dla repo-commits. Ten sam algorytm, inne priorytety.
Zastosowanie dolnej granicy
Ryzyko zapamiętywania
Małe źródła są zapamiętywane
Źródła danych ANDREA różnią się znacząco rozmiarem. synthetic-chat ma około 1400 dokumentów. gutenberg ma ponad 500 000. Jeśli bandit pobiera równomiernie, synthetic-chat szybko wyczerpuje swój zbiór dokumentów: po 1400 pobraniach każdy dokument został wyświetlony co najmniej raz. Po 2800 pobraniach każdy dokument został wyświetlony średnio co najmniej dwa razy.
Powtarzające się narażenie na mały zbiór dokumentów prowadzi do zapamiętywania: model przestaje uczyć się uogólnialnych wzorców i zaczyna recytować konkretne sekwencje tokenów z danych treningowych. Zapamiętywanie jest szkodliwe z dwóch powodów: (1) marnuje pojemność na mechaniczne odtwarzanie zamiast uogólniania, oraz (2) może wyciekać dane treningowe podczas generowania.
Epoki jako proxy zapamiętywania
Zdefiniuj epokę dla źródła k jako jedno pełne przejście przez wszystkie dokumenty źródła k:
epochs_k = floor(lifetime_pulls_k / n_docs_k)
Jeśli synthetic-chat (n_docs=1400) zostało pobrane 2 800 razy, epoki = floor(2800/1400) = 2: źródło zostało przeanalizowane dwukrotnie. Jeśli gutenberg (n_docs=500 000) zostało pobrane 100 000 razy, epoki = floor(100000/500000) = 0: nie wykonano jeszcze pełnego przejścia.
Kara 1/(1+epochs)
Gdy lifetime_pulls / n_docs > 1.0, ANDREA nakłada mnożnikową karę:
penalty = 1 / (1 + epochs)
final_weight = bandit_weight * penalty
Krzywa:
| epoki | kara | redukcja wagi |
|---|---|---|
| 0 | 1,000 | brak |
| 1 | 0,500 | połowa |
| 2 | 0,333 | jedna trzecia |
| 3 | 0,250 | jedna czwarta |
| 5 | 0,167 | jedna szósta |
| 10 | 0,091 | jedna jedenasta |
Kara rośnie z każdym ukończonym przebiegiem. Po wielu epokach waga źródła zbliża się do zera & bandyta naturalnie go „odpoczywa”.
Dlaczego dożywotnie pociągnięcia utrzymują się po ponownych uruchomieniach
Sesje treningowe ANDREA trwają dni. Wypadki się zdarzają. Serwery są restartowane. Konfiguracje są modyfikowane & trening wznawiany jest z punktu kontrolnego. Dożywotnie pociągnięcia utrzymują się przez wszystkie te zdarzenia: proxy nieprzerwanie zapisuje liczniki pociągnięć na dysk.
Gdyby pociągnięcia były resetowane przy każdym ponownym uruchomieniu, małe źródło mogłoby de facto wracać do epoki 0 za każdym razem, gdy trening jest wznawiany. Kara nigdy by się nie akumulowała, & memorizacja postępowałaby niezależnie od tego. Utrwalanie dożywotnich pociągnięć sprawia, że kara staje się rzeczywistym, monotonicznie rosnącym ograniczeniem.
Obliczenie kary za epokę
Zakończenie kursu dotyczącego stosu algorytmów bandytów
Co masz
Podłogi (floors) gwarantują minimalne próbkowanie dla źródeł priorytetowych: final_weight = max(bandit_weight, floor_k). Kary za epoki ogranicz zapamiętywanie w małych źródłach: gdy lifetime_pulls/n_docs > 1, waga jest mnożona przez 1/(1+epochs). Liczba pobrań w całym cyklu życia jest utrwalana między restartami, dzięki czemu kara staje się monotonnym ograniczeniem, a nie resetowalnym licznikiem.
Pełny potok
Łącząc wszystkie cztery aktywności bandyta ANDREA (76–79):
1. Aktywność 76 (UCB1). Na każdym kroku obliczane jest UCB(k) = mean_reward(k) + 0,5 * sqrt(ln(N)/n_k). Funkcja argmax wybiera ramię.
2. Aktywność 77 (fazy kostek). Granice faz (co 7 do 42 kroków) rzucają kostkami, aby ustalić liczbę ramion w skupieniu. Najpierw wybierane są ramiona losowe, a UCB wypełnia resztę. 25–33% faz działa w pełni losowo.
3. Aktywność 78 (przypisywanie nagrody). CUDA raportuje stratę; EMA per źródło śledzi historię; nagroda = max(0, EMA - loss) * 1000. Zskalowana nagroda zasila mean_reward(k).
4. Aktywność 79 (dolne granice i epoki, ta lekcja). Po wyjściu UCB dolne granice podnoszą priorytet źródeł; kary epok obniżają wagę źródeł zapamiętanych. Pobrania dożywotnie są utrwalane.
Razem: bandyta, który się adaptuje (UCB1), eksploruje wiarygodnie (fazy kości), otrzymuje uczciwe sygnały nagrody (skalowanie 1000x), respektuje priorytety projektowania treningu (dolne granice) oraz unika zapamiętywania (kara za epoki).
Referencje
Biały papier ANDREA, sekcje 3.5 i 3.6.