Zapytanie, Klucz, Wartość
Trzy mapowania liniowe z tego samego wejścia
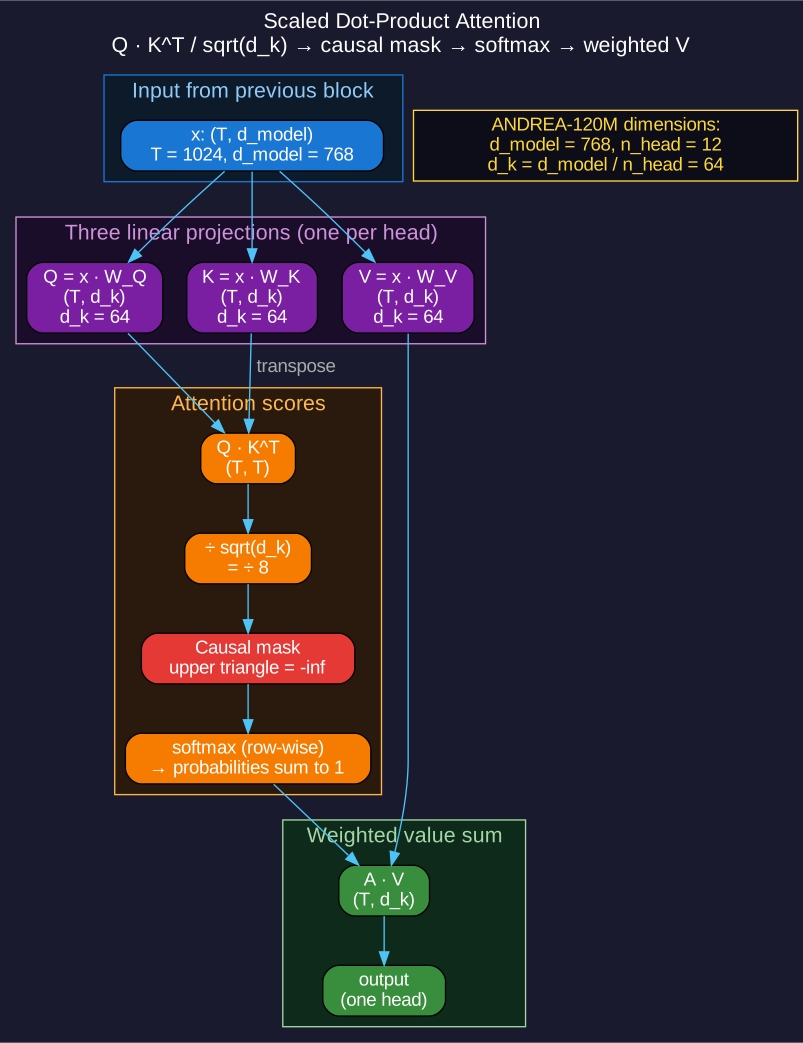
Po osadzeniu (aktywność 4) każda pozycja niesie wektor 768-wymiarowy x_t. Uwaga rozpoczyna się od wygenerowania trzech różnych projekcji x:
Q (zapytanie): czego ta pozycja chce się dowiedzieć?
K (klucz): co ta pozycja oferuje innym pozycjom?
V (wartość): jaką treść ta pozycja dostarcza, jeśli zostanie uwzględniona?
Każda projekcja pochodzi z wyuczonej macierzy wag:
Q = x · W_Q     # kształt W_Q: (d_model, d_k)
K = x · W_K     # kształt W_K: (d_model, d_k)
V = x · W_V     # kształt W_V: (d_model, d_k)
Trzy macierze, wszystkie trenowane za pomocą propagacji wstecznej. Model uczy się: na tej pozycji, które zapytanie najlepiej pobiera przydatny kontekst z przeszłości? Który klucz dobrze reklamuje zawartość tej pozycji? Jaka wartość jest dostarczana, jeśli pozycja zostanie wybrana?
Analogia biblioteczna
Wyobraź sobie katalog kartkowy w bibliotece. Wchodzisz z tematem w głowie (twoje zapytanie). Każda karta zawiera słowa kluczowe (klucz). Gdy twój temat pasuje do słów kluczowych na karcie, pobierasz treść książki (wartość). Mechanizm uwagi wykonuje to dla każdego tokena równolegle: każda pozycja wysyła zapytanie do każdej innej pozycji, rankuje dopasowanie i pobiera ważoną kombinację wektorów wartości.
Wymiary ANDREA-120M
| Wielkość | Wartość | Uwagi |
|---|---|---|
| d_model | 768 | Rozmiar wektora w każdej pozycji |
| n_head | 12 | Równoległe głowice uwagi |
| d_k | 64 | Wymiar na głowicę (= d_model / n_head) |
| T | 1024 | Długość kontekstu |
d_k = d_model / n_head = 768 / 12 = 64. Każda głowica widzi 64-wymiarowy wycinek pełnej przestrzeni 768-wymiarowej. Aktywność 6 (grow_a_language_model_multi_head) szczegółowo omawia podział na głowice.
Oblicz d_k
Dlaczego dzielimy przez sqrt(d_k)
Macierz ocen
Gdy Q i K istnieją (każde o kształcie (T, d_k)), uwaga oblicza macierz ocen:
scores = Q · K^T # kształt: (T, T)scores[i, j] = jak silnie zapytanie (query) z pozycji i jest zgodne z kluczem (key) z pozycji j. Każda para (i, j) otrzymuje jeden wynik: 1024 × 1024 = 1 048 576 wyników na głowę uwagi (attention head) w jednym przebiegu do przodu (forward pass).
Dlaczego dzielimy
Iloczyny skalarne dwóch losowych wektorów jednostkowych w przestrzeni d-wymiarowej mają wielkość rzędu sqrt(d). Bez skalowania wyniki rosną wraz z d_k:
- d_k = 64: typowe iloczyny skalaryczne rzędu 8.
- d_k = 256: typowe iloczyny skalaryczne rzędu 16.
- d_k = 4096: typowe iloczyny skalaryczne rzędu 64.
Wysokie wartości punktacji prowadzą do ostrego rozkładu softmax (jedna pozycja dominuje, a gradienty zanikają w pozostałych miejscach). Trening staje w miejscu. Skalowanie koryguje rzęd wielkości:
scaled_scores = (Q · K^T) / sqrt(d_k)Dla ANDREA-120M, sqrt(d_k) = sqrt(64) = 8. Każdy wynik jest dzielony przez 8. Wartości pozostają w przybliżeniu w skali jednostkowej, niezależnie od d_k. Funkcja softmax zachowuje się stabilnie. Gradienty przepływają.
Oryginalne uzasadnienie Vaswaniego
Z artykułu Attention Is All You Need (2017): „Dla dużych wartości d_k iloczyny skalarnie rosną w wartości bezwzględnej, co popycha funkcję softmax do obszarów, w których ma ona ekstremalnie małe gradienty.” Dzielnik sqrt(d_k) przeciwdziała temu wzrostowi.
Widok kodu
W pliku microgpt_cuda.cu to skalowanie pojawia się jako dosłowne dzielenie:
scores[i][j] = dot(Q[i], K[j]) * (1.0f / sqrtf(d_k));Jedno mnożenie liczb zmiennoprzecinkowych na wynik. Tanie. Krytyczne.
Skalowanie przy d_model = 4096
Dlaczego pozycja i nie może widzieć pozycji j > i
Ograniczenie wynikające z generowania
ANDREA generuje jeden token naraz. Podczas inferencji pozycja 0 produkuje pierwszy token, następnie pozycja 1 widzi wynik pozycji 0 i produkuje drugi token, i tak dalej. Model nigdy nie ma dostępu do przyszłych tokenów podczas generowania.
Trening musi to odzwierciedlać. Gdyby podczas treningu pozycja 5 mogła zwracać uwagę na pozycję 6, model nauczyłby się skrótu: „przewidz token 6, czytając token 6”. Podczas inferencji ten skrót znika (token 6 jeszcze nie istnieje). Zachowanie modelu podczas treningu i inferencji rozjechałoby się katastrofalnie.
Maska
Maska przyczynowa blokuje uwagę z dowolnej pozycji i do dowolnej pozycji j > i. Implementacja: ustaw scaled_scores[i][j] = -∞ wszędzie tam, gdzie j > i. Po softmax te wpisy stają się exp(-∞) = 0. Maska czysto zeruje uwagę do przyszłych pozycji.
for i in range(T):
for j in range(T):
if j > i:
scaled_scores[i][j] = -1e9   # effectively -inf
Po zastosowaniu softmax (wzdłuż wierszy), suma każdego wiersza wynosi 1, ale masę prawdopodobieństwa niosą wyłącznie elementy [0, i]. Pozycja i miesza informacje wyłącznie z pozycji poprzedzających.
Wizualizacja maski
Macierz ocen o kształcie (T, T) z zastosowaną maską wygląda jak struktura dolnego trójkąta:
scaled_scores po zastosowaniu maski, softmax wzdłuż wierszy:

wiersz 0:  [1.0, 0,   0,   0,   ...]   # widzi tylko siebie
wiersz 1:  [0.4, 0.6, 0,   0,   ...]   # widzi pozycje 0, 1
wiersz 2:  [0.2, 0.3, 0.5, 0,   ...]   # widzi 0, 1, 2
wiersz 3:  [0.1, 0.2, 0.3, 0.4, ...]   # widzi 0, 1, 2, 3
...
Ścisłe rozkład prawdopodobieństwa dolnego trójkąta w każdym wierszu. Przyszłość pozostaje niewidoczna.
Dlaczego Transformer tylko z dekodownikiem potrzebuje tego
Modele wyłącznie dekodera, takie jak ANDREA, GPT i LLaMA, mają wspólny cel: przewidywanie następnego tokena na podstawie przeszłości. Maska przyczynowa (causal mask) sprawia, że ten cel można trenować równolegle: każda pozycja oblicza swoje własne przewidywanie następnego tokena jednocześnie, a żadna pozycja nie „oszukuje”, podglądając przyszłość.
Maska i warianty
Od wyników do wyjścia
Softmax: Punkty do prawdopodobieństw
Zamaskowane i znormalizowane punkty nadal przyjmują wartości z zakresu liczb rzeczywistych. Funkcja Softmax przekształca każdy wiersz w rozkład prawdopodobieństwa:
A[i][j] = exp(scaled_scores[i][j]) / sum_k exp(scaled_scores[i][k])Wynikają z tego trzy właściwości:
- A[i][j] >= 0 dla wszystkich (i, j).
- sum_j A[i][j] = 1 dla każdego wiersza i.
- Wyższe surowe wyniki generują wyższe prawdopodobieństwa (monotoniczność).
Wektor prawdopodobieństwa w wierszu i mówi modelowi: na ile pozycja i powinna zwracać uwagę na każdą z poprzednich pozycji przy obliczaniu swojego wyjścia?
Zważona suma V
Ostateczny wynik uwagi dla pozycji i:
output[i] = sum_j A[i][j] · V[j]Każdy wektor wartości V[j] jest ważony przez prawdopodobieństwo uwagi A[i][j], a następnie sumowany. Wynik dla pozycji i łączy wektory wartości ze wszystkich poprzednich pozycji, ważone według stopnia istotności.
W postaci macierzowej, wszystkie pozycje naraz:
Attention(Q, K, V) = softmax(mask(Q · K^T / sqrt(d_k))) · VJedna linia. Cały mechanizm uwagi. Vaswani i in. napisali ten wiersz w 2017 roku; transfomy nie zmieniły się fundamentalnie od tamtej pory.
Kształt wyjścia na głowę
Wyjście jednej głowy uwagi: kształt (T, d_k). W przypadku ANDREA-120M: (1024, 64). Wszystkie 12 głów oblicza równolegle; ich wyjścia są łączone w (1024, 768) i trafiają do końcowej projekcji liniowej (W_O), a następnie do MLP bloku transformera.
Aktywność 6 (grow_a_language_model_multi_head) obejmuje podział na wiele głów. Aktywność 7 (grow_a_language_model_transformer_block) obejmuje wszystko, co otacza uwagę: połączenia rezydualne, normalizację warstwy oraz MLP.