ステップ0〜20K:制限された食事
2つのフェーズ、1つのラン
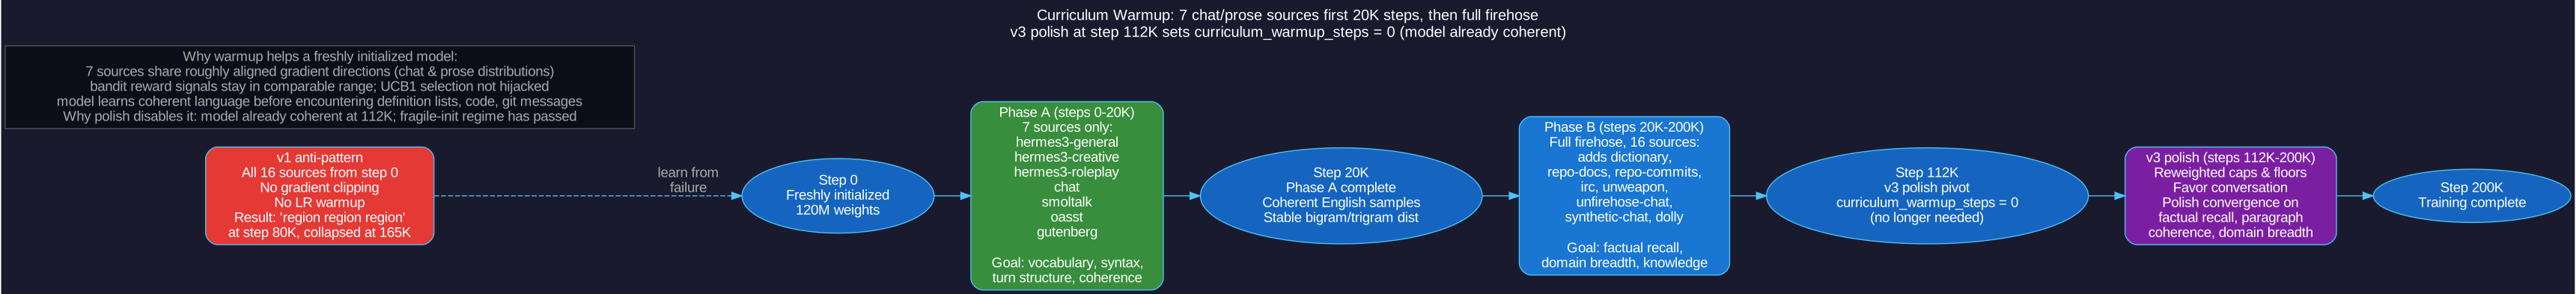
v2の火柱カリキュラムは、単一の200Kステップのトレーニングラン内で2つのフェーズとして実行されます:
フェーズA(ステップ0から20K)。 バンディットは、7つのチャットおよび散文ソースからのみデータを取得します:
- hermes3-general
- hermes3-creative
- hermes3-roleplay
- chat
- smoltalk
- oasst
- gutenberg
フェーズB(ステップ20Kから200K)。 Banditは、参照(dictionary)、技術(repo-docs、repo-commits)、およびソーシャル(irc、unweapon)を含む、全16ソースからなる完全なミックスからサンプリングを行います。
制限されたデータセットが共有するもの
ウォームアップ用の7つのソースのうち6つは対話型です。残り1つ(gutenberg)は段落形式の散文です。これらは共通した構造を有しています。すなわち、ターン構造(プロンプトとレスポンス)または物語の流れです。7つのソースにわたる語彙分布は概ね通常の英語に近く、クロスエントロピーのターゲットは安定した範囲内に留まり、勾配の大きさも予測可能な範囲に保たれます。
設定フィールド
"curriculum_warmup_steps": 20000,
"curriculum_warmup_sources": ["hermes3-general", "hermes3-creative",
"hermes3-roleplay", "chat", "smoltalk", "oasst", "gutenberg"]
ウォームアップフェーズを特定する
ウォームアップなしのv1の姿
v1: ステップ0から全16ソース
最初のANDREA-120Mトレーニング実行(2026年3月〜4月)では、ステップ0でフルファイアホース(全ソース)が有効化されました。16のソースには、辞書(> define X / < X is... 形式の88,000語の定義)、リポジトリ文書(Markdown形式のドキュメント)、リポジトリドックストリング(Pythonのドックストリング)、およびリポジトリコミット(チャットや散文と並んでのgitコミットメッセージ)が含まれていました。
何が間違っていたか
ランダムな重みで初期化されたばかりの120Mモデルは、16つの異なる分布を同時にモデル化することはできません。構造が異なるソースからの各バッチは、異なる勾配方向を生成します。ソースが7〜42ステップごとに切り替わることで勾配の大きさが激しく変動し、モデルは表現を形成する速度よりも速くアトラクターの間を跳ね回っていました。
ステップ80K時点で、v1は以下を生成しました:region region region region region region region。Hermes3-general教師蒸留報酬(平均340-453)により、反復的なリスト構造のソースがクロスエントロピーで最も高いスコアを獲得し、バンディットはこれを「これらのアームは容易である」と解釈しました。バンディットは、モデルを退化させるものをモデルにさらに供給しました。
7つのソースに制限することがなぜ有効か
1. 分布の類似性。 7つのウォームアップソースはすべて、類似した形状のテキスト(ターン構造またはナラティブ)を生成します。バッチ間の勾配方向はおおよそ整った状態を保ちます。
2. 一貫性を最優先する。 モデルは、定義リスト、コード、またはgitメッセージに遭遇する前に、語彙の頻度、構文パターン、およびターン構造を学習する。
3. 安定したカリキュラム。 7つのチャット/散文ソースにまたがるバンディット報酬シグナルは比較可能な範囲内に留まるため、UCB1選択が異常に報酬の高い単一のソースによって乗っ取られることはない。
フェーズBが有効化されるタイミング
ステップ20K時点で、モデルは約40〜50サンプル(100ステップごとに1つ)を生成しており、サンプルに一貫性のある英語が見られ、安定したバイグラムおよびトライグラムの分布が構築されている。これにより、辞書の > define X / < X is... パターン、リポジトリドキュメントのコードブロック、およびgitコミットヘッダーを、その下にあるチャット構造を失うことなく吸収できるようになる。
v1の失敗を診断する
v3 ポリッシュセット curriculum_warmup_steps = 0
異なる出発点
ステップ112,619でのv3ポリッシュの転換点は、step_112600.bin からトレーニングを再開し、curriculum_warmup_steps を 0 に設定しました。一見すると、これは矛盾のように見えます。ウォームアップがv2に役立ったなら、なぜポリッシュフェーズでそれを無効にするのですか?
なぜなら、モデルはすでに一貫性を学習済みだから
フェーズAは、新たに初期化されたモデルが語彙の頻度、ターン構造、段落の連貫性を学習するための時間を確保します。ステップ112K時点で、モデルはすでにこれらすべてを習得しています。112K時点でのサンプル監査では、連貫した会話ターン、俳句、Q&A、対話が確認されました。ウォームアップの元の目的(脆弱な新モデルを勾配の混乱から保護すること)は、もはや適用されません。
Polishは再重み付けを行うが、リスタートはしない
Polishはカリキュラムの摂動であり、新しい実行ではありません。同じ200Kのターゲット、同じアーキテクチャ、同じオプティマイザの状態、同じ損失履歴です。変化する点:ソースの上限と下限が再重み付けされ、知識アームよりも会話を優先するようになります。モデルがすでに連貫しているため、ステップ112,619以降、すべてのアクティブなソースが対象となります。
サマリーテーブル
| フェーズ | curriculum_warmup_steps | 理由 |
|---|---|---|
| v1 | (存在しない) | ステップ0からの全16ソース -> 崩壊 |
| v2 (ステップ0-200K) | 20,000 | 初期化されたばかりの重みを勾配の混乱から保護 |
| v3 base (ステップ0-112K) | 20,000 | v2と同じ保護 |
| v3 polish (ステップ112K-200K) | 0 | モデルはすでに一貫性がある。保護すべき脆弱な初期化状態は存在しない |