متوسط الحركة الأسي
متوسط حديث مُنعَّم
يتتبع متوسط الحركة الأسي (EMA) قيمة معينة من خلال إعطاء وزن أكبر للعينات الحديثة مقارنةً بالقديم منها، مع تضاؤل الأوزان بشكل أسي. الصيغة:
EMA(t) = (1 - alpha) EMA(t-1) + alpha value(t)
حيث يقع ألفا (معامل التنعيم) في المجال (0, 1). يستخدم ANDREA قيمة ألفا = 0.1 لتتبع الخسارة لكل مصدر.
حدًا بحد
- value(t): الملاحظة الأحدث. في حالة ANDREA، هذه هي الخسارة التي يبلغ عنها CUDA بعد تمريرة أمامية على مستند من المصدر k.
- EMA(t-1): قيمة EMA السابقة للمصدر k. مخزنة في حالة الوكيل (proxy state).
- ألفا = 0.1: تساهم كل خسارة جديدة بنسبة 10%؛ بينما تساهم السجل المتحرك بنسبة 90%.
- (1 - ألفا) = 0.9: الوزن المخصص للتاريخ.
لماذا EMA بدلاً من المتوسط العادي
يُوزّع المتوسط التشغيلي العادي الوزن بالتساوي على كل خطوة. فخطوة 1 لها نفس وزن الخطوة 100,000. وهذا يعمل إذا كانت البيانات ثابتة (stationary). لكن خسائر ANDREA ليست ثابتة: فإمكانية النموذج (model capacity) تنمو أثناء التدريب، لذا فإن خسارة مصدر معين عند الخطوة 5,000 تختلف عن خسارته عند الخطوة 50,000.
يحل EMA هذه المشكلة. تتلاشى قيم الخسارة القديمة بشكل أسي (exponentially). يعكس EMA الواقع الأخير، وليس متوسط الشروط الأولية.
لكل مصدر
تحتفظ ANDREA بـ EMA واحد لكل ذراع (arm) (لكل مصدر). ستة عشر ذراعاً = ستة عشر EMA. في كل خطوة، يتم تحديث EMA المصدر الذي تم سحبه فقط. تبقى الـ 15 EMA الأخرى مجمّدة (غير متغيرة) حتى سحبها التالي.
حساب خطوة EMA
معادلة المكافأة
المكافأة = التحسن، مُقيّساً
تعرف ANDREA مكافأة الخطوة الواحدة للذراع k على النحو التالي:
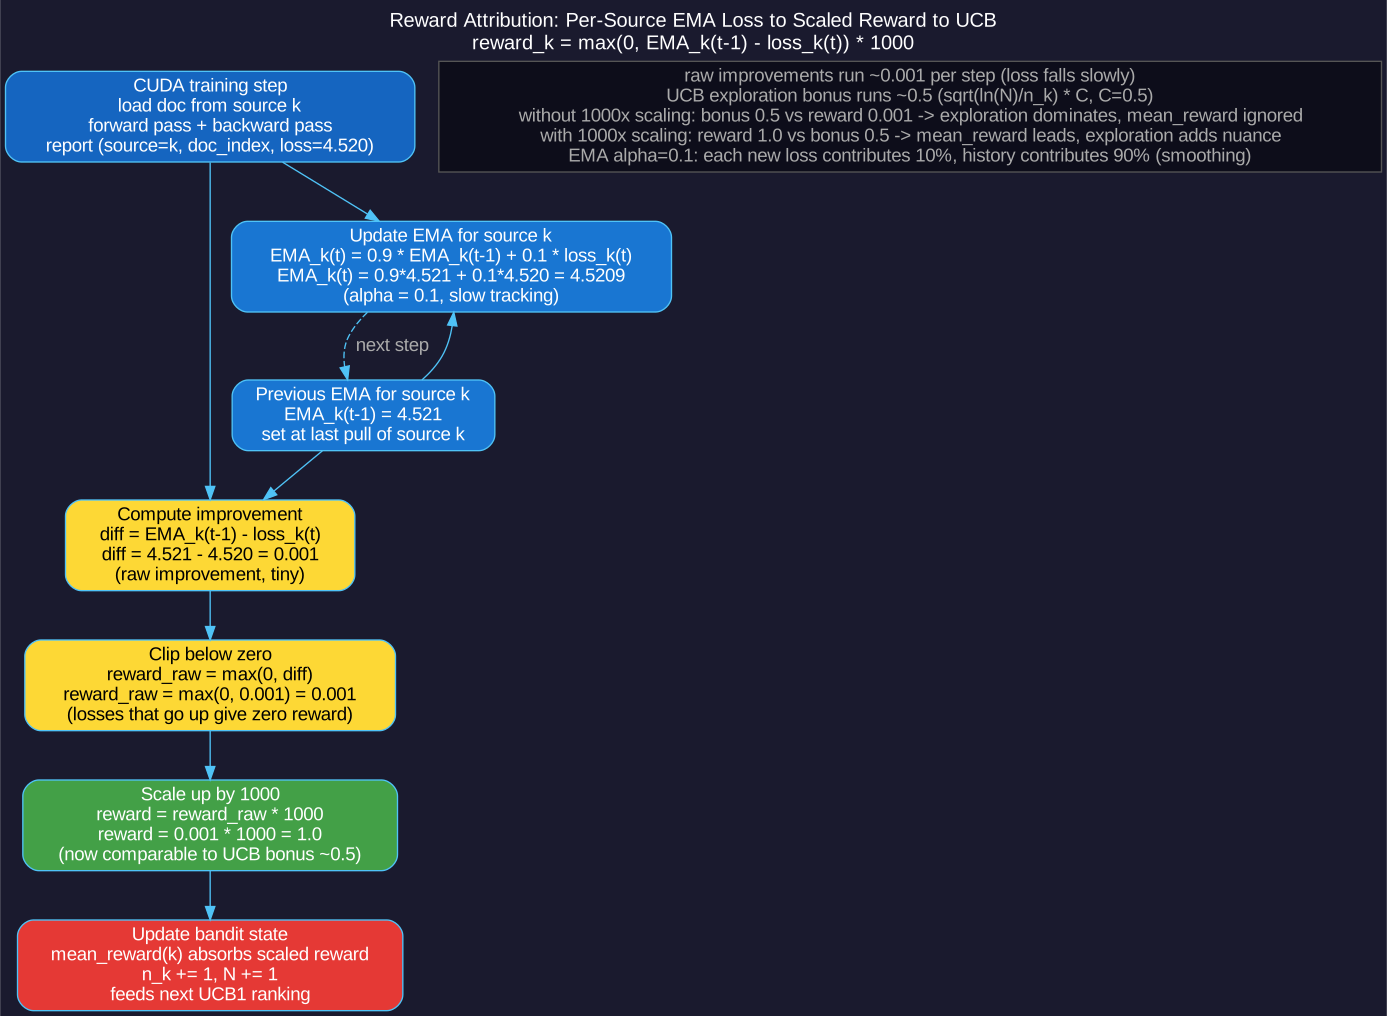
reward_k = max(0, EMA_k(t-1) - loss_k(t)) * 1000
ثلاثة مكونات:
1. EMA_k(t-1) - loss_k(t): التحسّن. إذا جاء الخسارة الجديدة أقل من المتوسط المتحرك، يكون الفرق موجباً: المصدر k أدّى بشكل أفضل من المتوقع.
2. max(0, ...): قصّ التحسّنات السالبة إلى صفر. إذا جاءت الخسارة الجديدة أسوأ من المتوسط المتحرك، لا توجد مكافأة (ولكن لا يوجد عقاب أيضاً).
3. \* 1000: للتوسيع حتى يصبح الإشارة قابلة للمقارنة مع مكافأة الاستكشاف في UCB.
لماذا max(0, ...)
ستدفع المكافآت السالبة متوسط المكافأة mean_reward(k) إلى الانخفاض، مما يحرف UCB ضد الأذرع التي ارتفعت خسائرها بشكل متقلب. لكن التقلب أمر طبيعي: مستند واحد صعب يرفع الخسارة دون أن يعني أن المصدر سيئ. القصّ إلى صفر يعامل التقلب كـ "لا توجد معلومات" بدلاً من "عقوبة".
يمكن للمصادر أن تكسب مكافأة صفرية بشكل متكرر دون أن تغرق. يبقى ترتيبها في UCB مدفوعاً بمكافأة الاستكشاف (عالية عندما يكون n_k صغيراً) بالإضافة إلى الانتصارات السابقة.
ما يُبلّغه CUDA
في كل عملية تمرير أمامي وخلفي، يُصدر نواة CUDA سجلاً واحداً:
{source: 'hermes3-general', doc_index: 4231, loss: 4.520}
يستقبل الوكيل (Proxy) السجل، ثم يبحث عن متوسط الحركة الأسي (EMA) لذلك المصدر، ويحسب المكافأة، ويحدّث متوسط الحركة الأسي، ويغذي المكافأة في مُجمِّع mean_reward(k) لخوارزمية العازف (Bandit).
حساب المكافأة
مطابقة المكافأة مع مكافأة الاستكشاف
مشكلة الحجم
تحسينات الخسارة لكل خطوة تكون صغيرة. تنخفض الخسارة من 4.521 إلى 4.520: الفرق 0.001. من 4.520 إلى 4.518: الفرق 0.002. على مدار عملية تدريب كاملة، تتراوح الفروق الخام تقريباً في النطاق [0, 0.01].
الآن انظر إلى مكافأة الاستكشاف في خوارزمية UCB عند C=0.5، مع N=1000 و n_k=20:
0.5 sqrt(ln(1000) / 20) = 0.5 sqrt(6.91 / 20) = 0.5 * 0.588 = 0.294
تعمل المكافأة بمعدل 0.294. بينما تعمل المكافأة الخام بمعدل 0.001. المكافأة أكبر بـ 300 مرة من المكافأة الخام. يرتب argmax في UCB القائمة بشكل شبه كامل بناءً على المكافأة؛ حيث يوفر mean_reward إشارة شبه معدومة.
النتيجة بدون القياس (Scaling): يختار خوارزمية bandit في ANDREA الذراع (arm) ذات أصغر قيمة لـ n_k في كل خطوة. يتم تجاهل mean_reward. تتحول الخوارزمية إلى سياسة استكشاف خالصة.
الحل: مضاعفة 1000 مرة
اضرب المكافأة الخام في 1000. الآن تكون المكافأة عند 1.0 (مقابل 0.001 الخام). قارن ذلك بنفس مكافأة الاستكشاف 0.294:
المكافأة المُقيّمة 1.0 مقابل المكافأة 0.294 = المكافأة تتقدم بفارق 3.4 مرات
الآن تتحكم متوسط المكافأة (mean_reward) في ترتيب UCB. يضيف الاستكشاف دقة للذيل (فالأذرع النادرة تحصل على دفعة قدرها 0.3)، لكن جوهر الترتيب يأتي من المكافأة المرصودة.
لماذا 1000 (وليس 10، وليس 100,000)
مطابقة رتبة المقدار. المكافآت الخام تتراوح حول ~10^-3. مكافأة الاستكشاف تتراوح حول ~10^0. الفارق هو 10^3. اضرب المكافأة الخام في 10^3 لتقع في نفس النطاق كمكافأة الاستكشاف.
التحجيم بمعامل 100x يترك المكافأة عند 0.1 (لا تزال أقل من مكافأة 0.294 -> الاستكشاف لا يزال مسيطراً). التحجيم بمعامل 100,000x يرفع المكافأة إلى 100 (الآن لا يمكن للاستكشاف التأثير على أي شيء؛ ينهار UCB إلى متوسط المكافأة الجشع). معامل 1000x يقع في المنطقة العاملة حيث يساهم كلا الحدين.
معايرة، وليس نظرية
عامل 1000x هو معايرة هندسية، وليس ثابتاً نظرياً. يعتمد على ثلاثة أشياء: مقياس خسارة التدريب (الإنتروبيا المتقاطعة على مفردات من 8K رمز تعمل بالقرب من 4.5)، معدل انخفاض الخسارة لكل خطوة (بطيء)، وثابت UCB C=0.5. غيّر أيّاً من تلك، وقد لا يكون 1000 هو المعامل الصحيح بعد الآن.
التفكير في عامل التحجيم
ما سيأتي تالياً
ما لديك
تنسب المكافآت (Reward attribution) تحويل تقارير الخسارة من CUDA إلى إشارة جاهزة لـ UCB في ثلاث عمليات: تتبع EMA لكل مصدر لتاريخ الخسارة (alpha=0.1، بطيء)، المكافأة = max(0, EMA - loss) تقصّ القيم السالبة، ومعامل التقييس 1000 يطابق حجم المكافأة مع حجم مكافأة الاستكشاف في UCB.
ما تبقى
تعمل أدنى الحدود (Floors) وعقوبات الحقبات (Epoch penalties) (النشاط 79) فوق مخرجات خوارزمية UCB. تضمن أدنى الحدود المصدرية الحد الأدنى من العينة للمصادر ذات الأولوية بغض النظر عن ترتيب UCB. تقوم عقوبات الحقبات بخفض وزن المصادر التي تم سحبها (Pull) أكثر من عدد مستنداتها، مما يمنع الحفظ (Memorization) لمجموعات البيانات الصغيرة مع الحفاظ على حداثة مجموعات البيانات الكبيرة.
المرجع
ورقة ANDREA البيضاء، القسم 3.3.